NVIDIA מציגה דרך יעילה לאמן מודלי MoE בביולוגיה
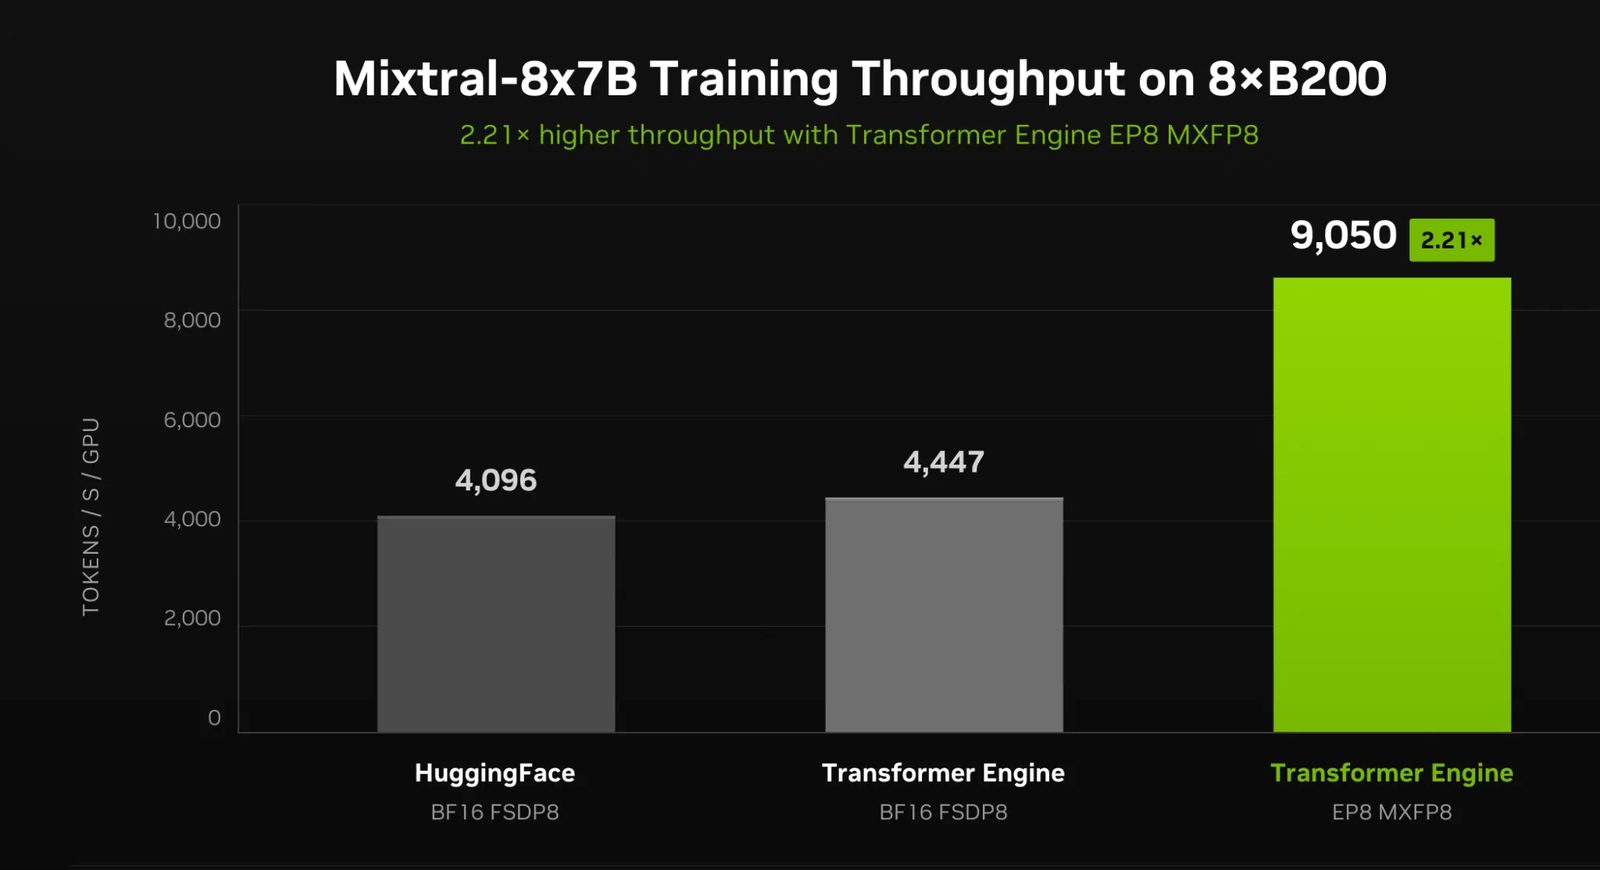
מדריך חדש בבלוג המפתחים של NVIDIA מסביר כיצד Transformer Engine ומתכון BioNeMo מאיצים אימון של מודלים מבוססי תערובת מומחים (MoE) בביולוגיה, עם תפוקה גבוהה פי 2.21 מהבסיס על שמונה GPU מדגם B200.
בלוג המפתחים של NVIDIA פרסם מדריך לאימון יעיל יותר של מודלי בסיס ביולוגיים מבוססי תערובת מומחים (MoE). את המדריך כתבו Faradawn Yang, Peter St John, Kyle Tretina ו-Zoey Zhang.
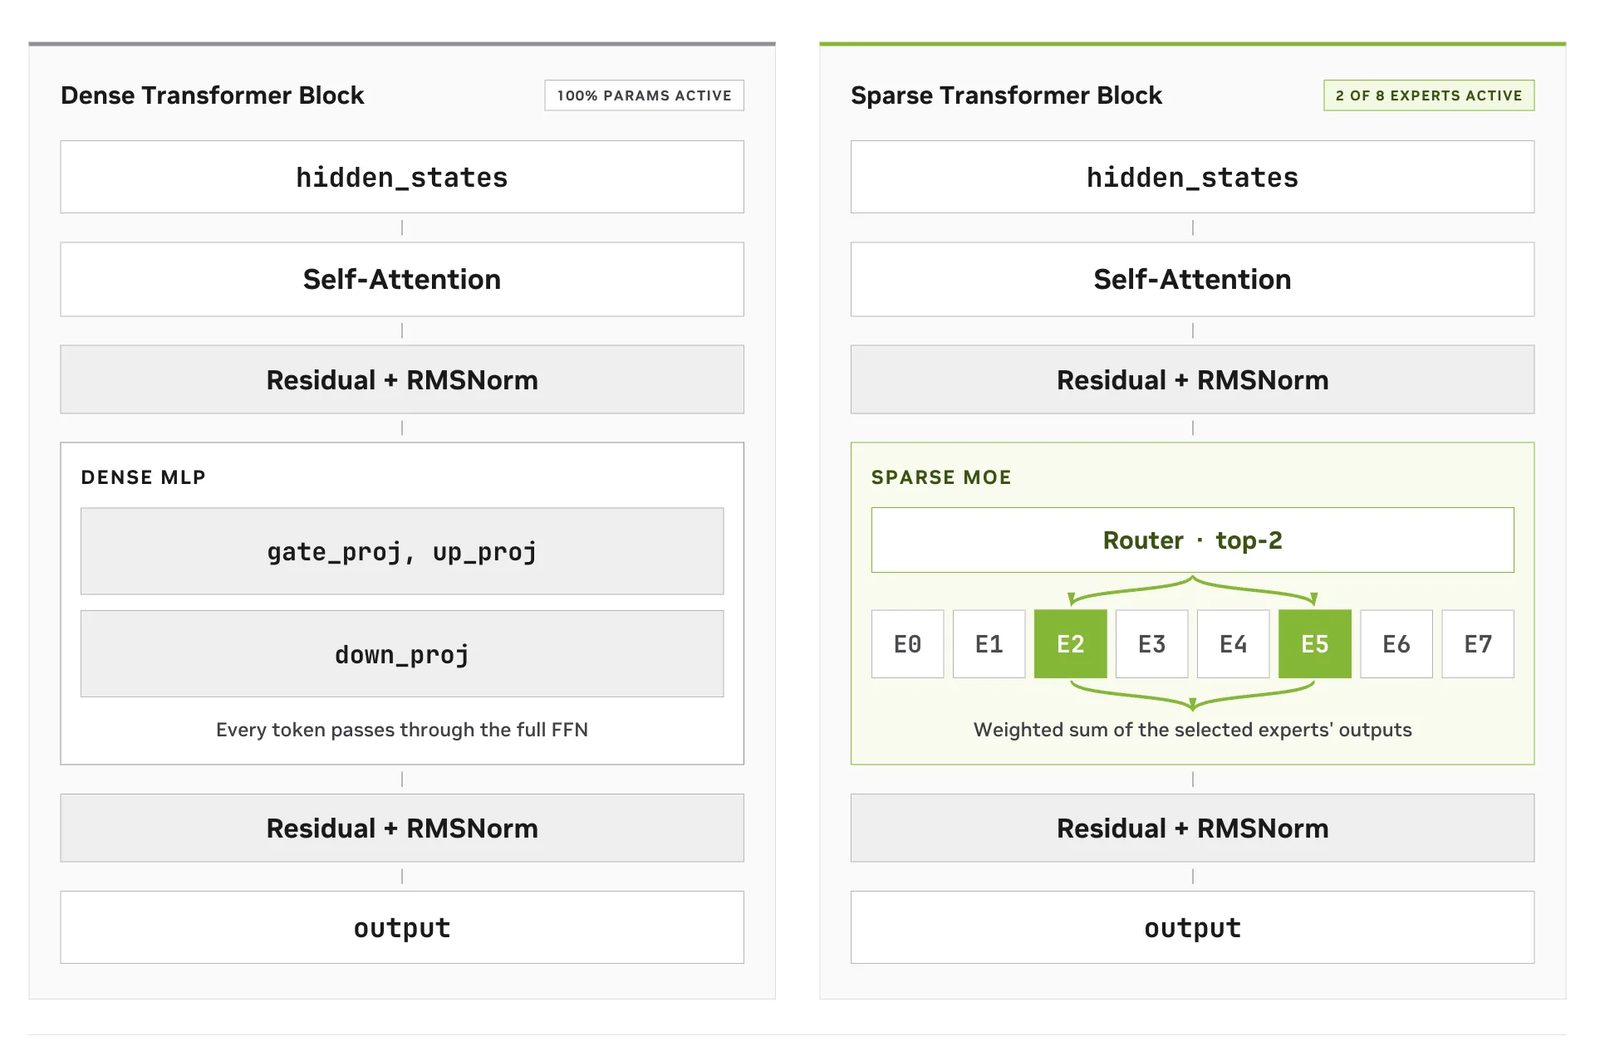
טרנספורמרים צפופים מעבירים כל טוקן דרך כל השכבות, ולכן הרחבת היכולת יקרה גם באימון וגם בהסקה. ארכיטקטורות MoE מחלקות את בלוק ה-feed-forward למומחים רבים ומפעילות רק מעטים מהם לכל טוקן. התוצאה תלויה במימוש: חישובי מומחים מפוצלים מנמיכים את ניצולת ה-GPU, הניתוב מוסיף תקורות תקשורת, ומספר פרמטרים גדול יותר מכביד על הזיכרון.
מומחים מקובצים במקום לולאת Python
האתגר הראשון הוא פיצול הקרנלים. במימוש הבסיסי של Hugging Face המומחים רצים בזה אחר זה בלולאת Python, וכל אחד מפעיל קרנלים נפרדים. GroupedLinear של TE אוסף את משקלי המומחים ואת הטוקנים ומבצע את כל הטרנספורמציות הלינאריות בקריאת GEMM מקובצת אחת, תוך קבלת מספר הטוקנים לכל מומחה בארגומנט split_sizes. הערימה של NVIDIA יכולה למזג את ההקרנה הזו עם כימות MXFP8 וסקילת משקלי הניתוב בתוך קרנל GroupedMLP.
צמצום הזיכרון ותקורות הכימות
למודלי MoE יש יותר פרמטרים, ועומסי גנומיקה משתמשים לרוב ברצפים ארוכים, מה שלחץ על זיכרון האקטיבציות. BF16 שומר כל ערך ב-16 ביטים, בעוד FP8 ו-MXFP8 משתמשים ב-8. MXFP8 מקצה מקדם סקלה לכל בלוק של 32 ערכים רצופים כדי לשמור על הטווח המספרי, ועל מעבדי Blackwell ה-GEMM האלה רצים בהוראות Tensor Core ייעודיות.
אימון בדיוק נמוך עדיין שומר את משקלי האב ב-16 ביטים, ולכן הכימות והדה-כימות מוסיפים עבודה. שרשור GroupedLinear, ScaledSwiGLU ו-GroupedLinear דרך API ה-Sequential של TE מאפשר להחליף את התבנית בפעולה מאוחה אחת: ForwardGroupedMLP_CuTeGEMMSwiGLU_MXFP8 במעבר קדימה ובמקבילה לאחור.
פי 2.21 תפוקה על שמונה GPU מדגם B200
בבדיקה עם המודל Mixtral-8x7B על שמונה GPU של NVIDIA B200 Tensor Core הגיע המתכון לפי 2.21 מהתפוקה של מימוש הבסיס של Hugging Face, בטוקנים לשנייה לכל GPU. קרנלי MXFP8 GroupedMLP המאוחים דורשים חומרת Blackwell, ופריסת מומחים במקביל דורשת לפחות שני מעבדים גרפיים.
המדריך כולל פקודות הרצה: תצורת L0_sanity על שני GPU לאימות הסביבה, ואחריה תצורת L1_8x7B_ep עם פריסת מומחים (EP=8) ודיוק MXFP8 על שמונה GPU.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.