המחשוב החסוי של NVIDIA שומר על 96% מתפוקת האינפרנס ב-Blackwell
לפי הבלוג הטכני של NVIDIA, TensorRT LLM עם מחשוב חסוי שמר על 96.1-98.2% מתפוקת אסימוני הפלט על שמונה מעבדי Blackwell B200, והחברה מסבירה אילו הנחות ריצה נאלצו להשתנות.
NVIDIA פרסמה ניתוח טכני של האופן שבו מחשוב חסוי (confidential computing) משפיע על אינפרנס של מודלי שפה גדולים, וכיצד הותאם פריימוורק TensorRT LLM שלה כך שהרצה מוצפנת על מעבדי Blackwell תשמור על רוב המהירות.
זיכרון מוצפן משנה את הנחות היסוד של זמן הריצה
מחשוב חסוי מריץ עומסים בתוך מכונות וירטואליות עם זיכרון מוצפן, מעבדים גרפיים חסויים ו-NVLink מוצפן. ואולם הרצה מאובטחת משנה את ההנחות שעליהן נשען זמן הריצה של האינפרנס: העברת נתונים בזיכרון, תזמון, תיאום ותקשורת בין כמה מעבדים, ושינויים אלה עולים בביצועים אם הפריימוורק אינו מותאם.
כדי לחשוף את התקורה בחרה הקבוצה הקשר קלט ארוך, יצירה ממושכת ומידת מקביליות נמוכה: DeepSeek-R1-0528-NVFP4 על PyTorch backend של TensorRT LLM, עם 32K אסימוני קלט ו-1K פלט, בין 1 ל-16 בקשות במקביל, TP=8 ומטמון KV מסוג FP8.
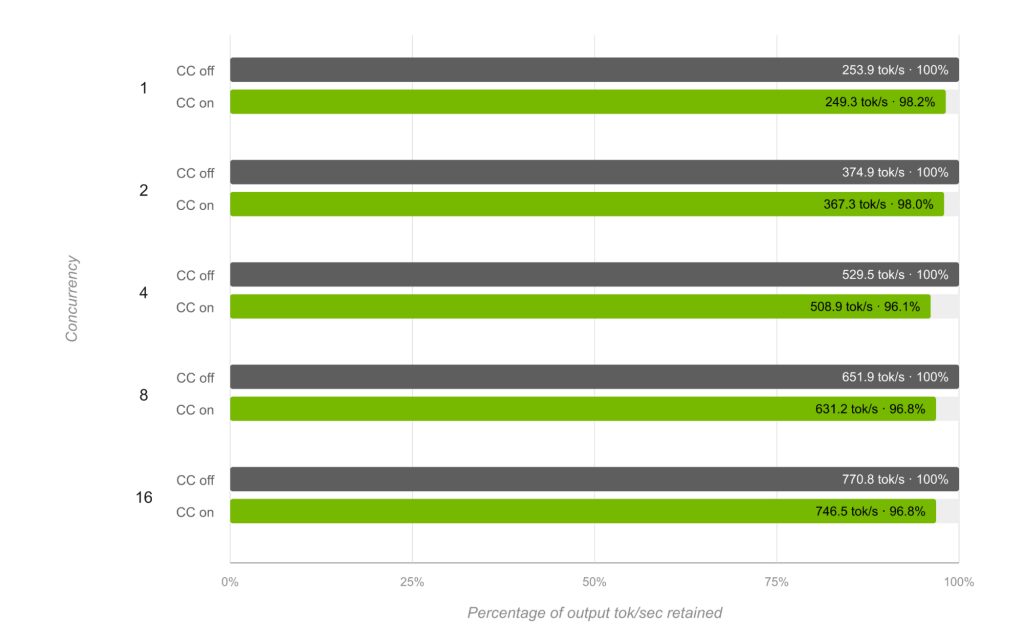
96% מתפוקת האסימונים נשמרו
רק מצב המחשוב החסוי השתנה; המודל, החומרה, גרסאות התוכנה, אורכי הרצפים, המקביליות ורמת העומס נותרו קבועים. עמדת הניסוי: מערכת NVIDIA DGX B200 אחת עם שמונה מעבדי B200, פלטפורמת Intel TDX, CUDA 13.2, NCCL 2.30 ו-TensorRT LLM 1.3.0rc22.
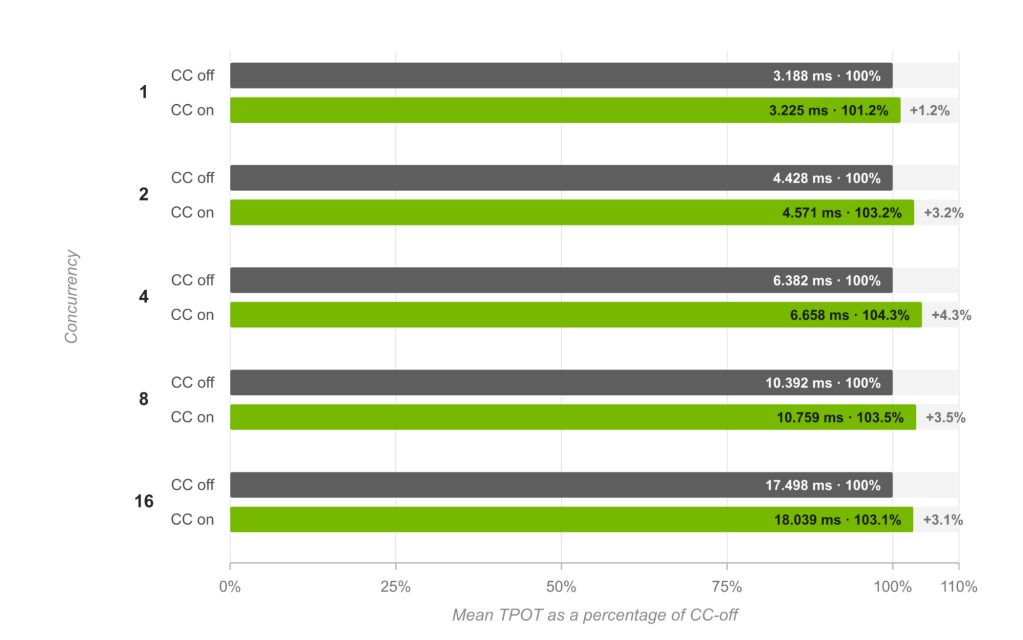
ברמות מקביליות מ-1 עד 16 שמר המצב החסוי על 96.1-98.2% מתפוקת אסימוני הפלט, והזמן הממוצע לאסימון פלט נותר בטווח של 1.2% עד 4.3% מעל קו הבסיס.
שלושה מקומות שהפריימוורק נדרש להתאים
העברות מ-host ל-device עוברות דרך חוצץ מוצפן בתוכנה, משום שהמעבד הגרפי אינו ניגש ישירות לזיכרון המוגן של ה-CVM. לכן pinned memory מאבד את יתרון ההעברה האסינכרונית הרגיל, וחלק מההעתקות עלולות לחסום את ה-thread הקורא; TensorRT LLM בוחר סוגי זיכרון בהתאם למחשוב החסוי ומעביר קריאות חוזרות של אסימונים ל-worker אסינכרוני (PR #11573).
מכוון-הקרנלים משווה טקטיקות באמצעות CUDA events, אך תחת מחשוב חסוי אות התזמון היה לא יציב; כעת הוא מודד באמצעות %globaltimer של המעבד הגרפי (PR #11657). מולטיקאסט NVLink SHARP אינו זמין בתצורות B200 חסויות, ולכן פריימוורקים צריכים לזהות זמינות NVLS ולבחור אלגוריתמים מתאימים.
מדדו את העומס שלכם
ההמלצה של NVIDIA היא להתייחס לתצורת האבטחה ולמיטוב האינפרנס כבעיית פריסה אחת: להפעיל מחשוב חסוי, לבצע אטסטציה לסביבה ולהשוות בין מצב חסוי ללא חסוי על העומס המדויק שאותו תתכוננו לשרת.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.