NVIDIA Warp ו-MJWarp: 2,048 סימולציות רובוטים במקביל על GPU יחיד
NVIDIA פרסמה את המאמר השני בסדרת State of Simulation for Physical AI. הוא מתאר את MuJoCo Warp, שמעביר מודלים תואמים של MuJoCo ל-GPU ומריץ עד 2,048 עולמות סימולציה במקביל, תוך התמקדות בתפוקה כוללת ולא בהשהיה של עולם אחד.
NVIDIA פרסמה את המאמר השני בסדרת State of Simulation for Physical AI. הוא מתאר את MuJoCo Warp (MJWarp), מימוש GPU של הפיזיקה של MuJoCo שנבנה על מסגרת הליבות NVIDIA Warp. בדוגמה מועבר זרוע רובוטית SO-101 מתהליך עבודה רגיל על CPU לעד 2,048 עולמות סימולציה במקביל על GPU אחד. לפי המחברים, השאלה המרכזית אינה עוד כמה מהר מתקדם עולם אחד, אלא כמה עולמות יכולים להתקדם בו-זמנית.
Warp היא מסגרת Python לכתיבת ליבות מהירות במיוחד עם האצת GPU. המפתחים כותבים ליבות בעלות טיפוסים סטטיים ב-Python, ו-Warp מהדר אותן ל-CPU או ל-CUDA ושומר את התוצאה במטמון, בעוד התצורה וההרצה נשארות ב-Python רגיל. המסגרת מציעה מהירות ברמת CUDA באמצעות הידור JIT ו-CUDA Graphs, וקטורים, מטריצות, קווטרניונים ו-hash grid מובנים, וליבות דיפרנציאביליות עם ממשק DLPack, כך שאפשר להכניס את הסימולציה לתוך לולאת אימון.
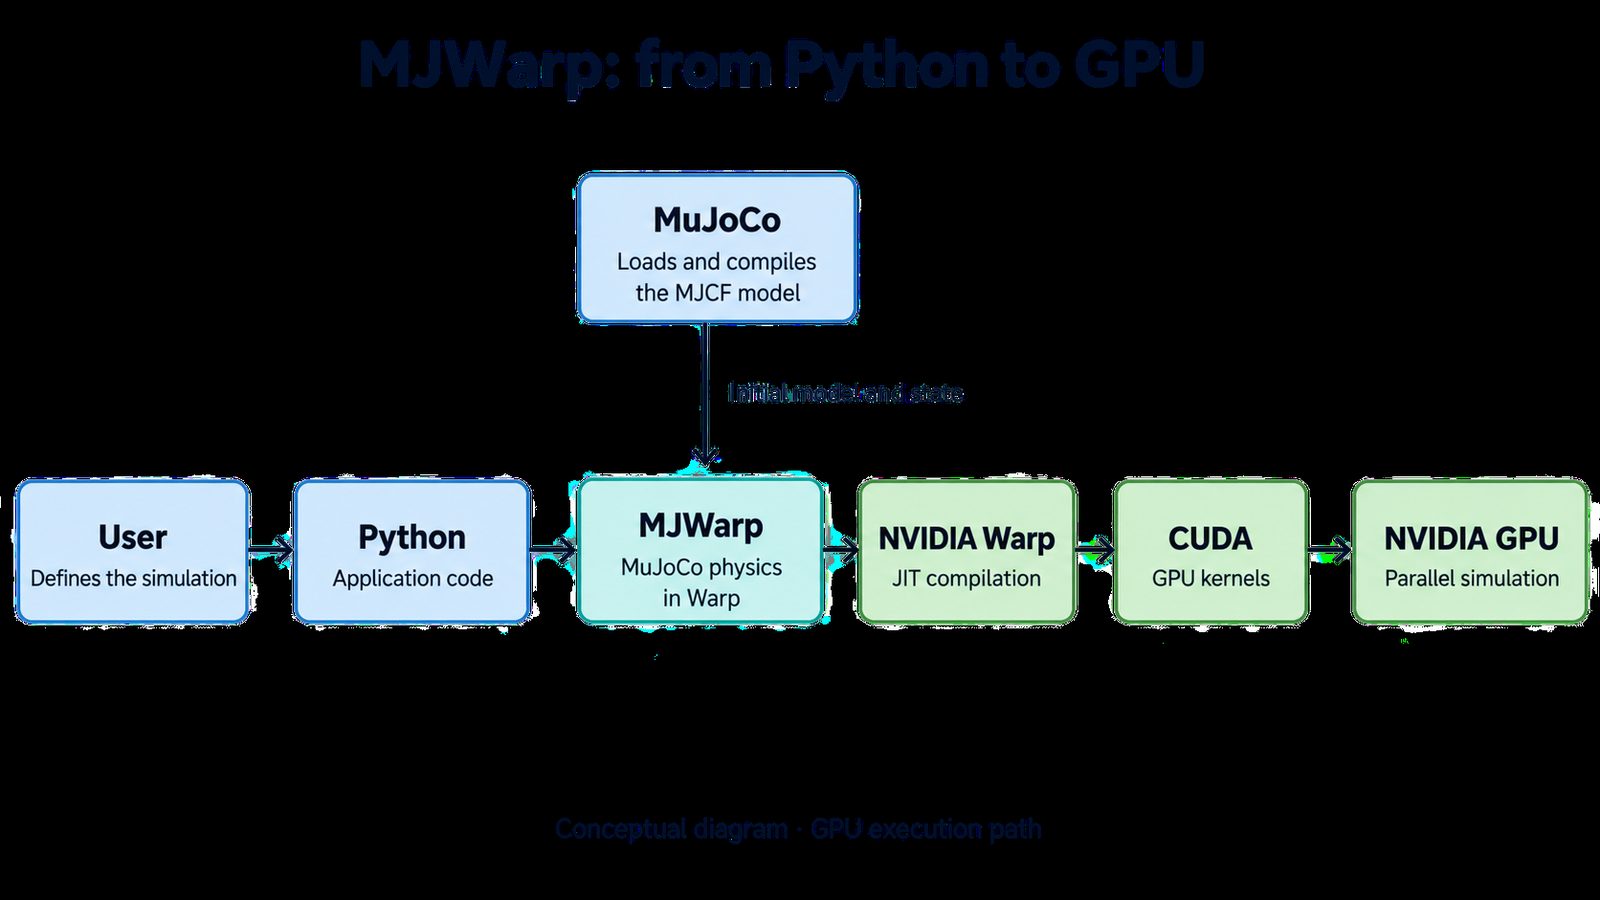
כיצד MJWarp מארגן את הפיזיקה באצוות
MJWarp שומר על פורמט המודל: קובץ MJCF נטען ב-MuJoCo, ו-mjw.put_model מעלה אותו להתקן, שם קריאה אחת ל-mjw.step מקדמת אצווה שלמה של עולמות בלתי תלויים. ארבעה פרמטרים קובעים את הקיבולת: nworld, מספר הסביבות המקבילות; nconmax, המגעים הצפויים לכל עולם; naconmax, מגבלת מגעים גלובלית שגוברת כשמוגדרת; ו-njmax, תקרת האילוצים לכל עולם. הרווח הוא בתפוקה כוללת ולא בהשהיה של עולם בודד, מה שמתאים ללמידת חיזוק ולדגימה בהיקף גדול.
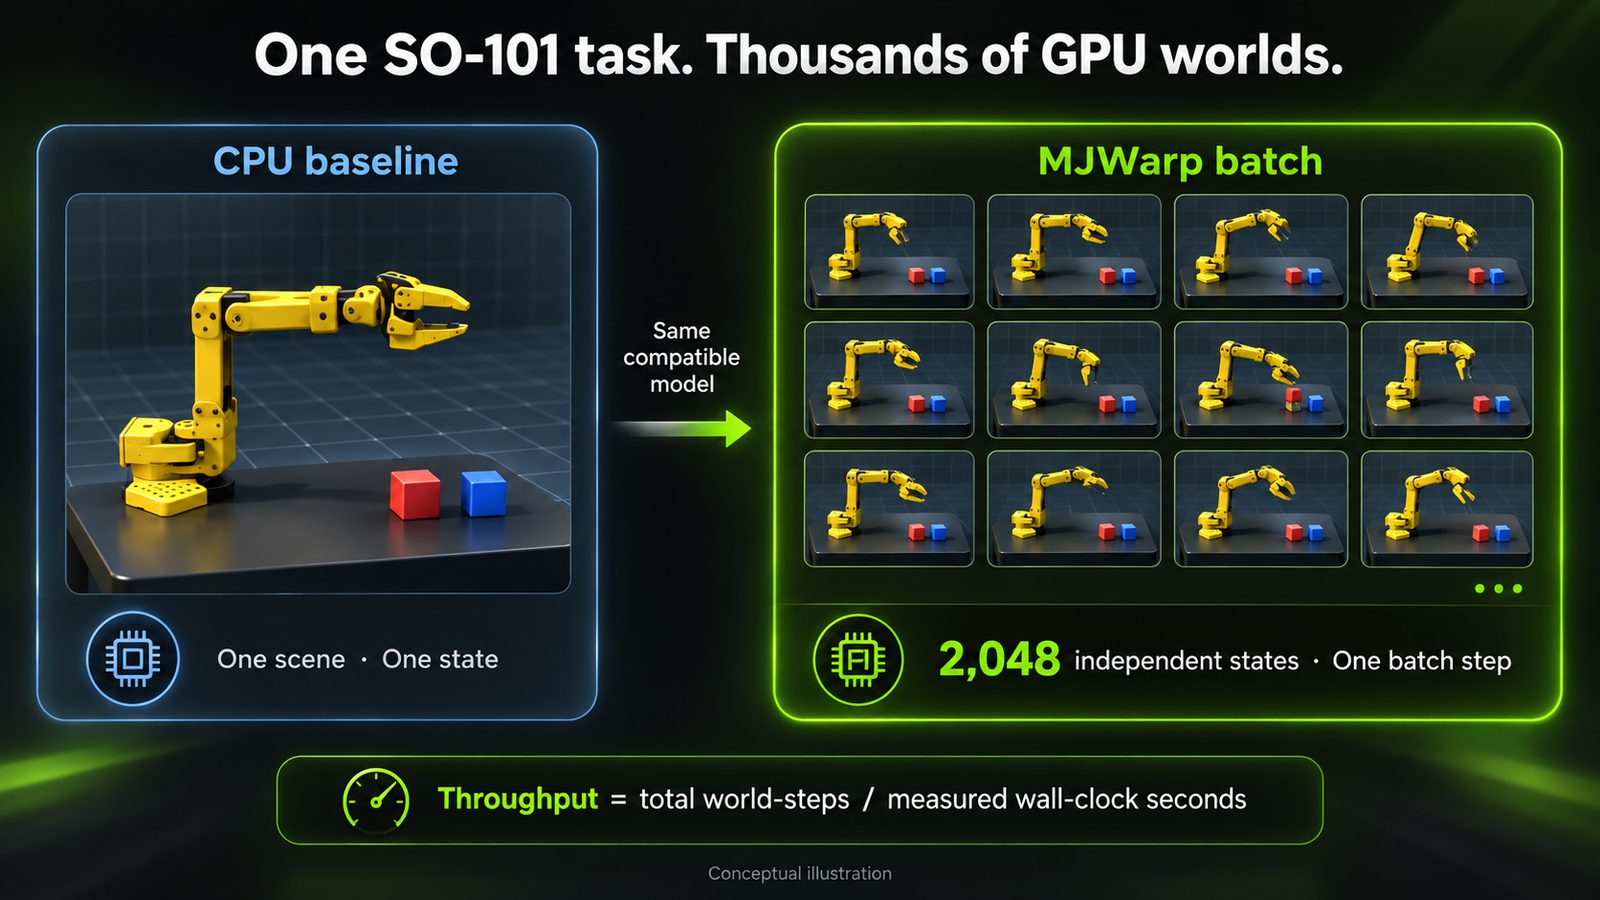
קודם אימות, אחר כך מדידה
המחברים עוברים סדרת בדיקות: בונים בסיס על CPU, מעבירים עולם אחד ל-GPU ומאמתים התאמה, מכיילים את מאגרי המגעים והאילוצים לפי הרגע העמוס ביותר במשימה, ואז עוברים ל-2,048 עולמות. בדוגמה על זרוע SO-101 להניח קובייה אדומה בגודל 44 מ"מ על קובייה כחולה. ההצלחה נמדדת בשני תנאים: שגיאה אופקית של עד 15 מ"מ ומרווח אנכי של 35 עד 55 מ"מ. הצפה של מאגר אינה נזרקת כשגיאה, ולכן הרצה שחרגה ממנה אינה מהימנה למדידות ביצועים.
המדידה היא השלב האחרון. השקות על GPU הן א-סינכרוניות, כך שטיימר נאיבי מודד כמה מהר Python תורם עבודה ולא כמה מהר סיים ה-GPU. המאמר מבצע חימום תחילה ומסנכרן לפני ואחרי קטע המדידה. התוצאות מדווחות בצעדי עולם לשנייה ובמילישניות לצעד באצווה, יחד עם גודל האצווה. Warp 1.15 הוסיף מצב הרצה דטרמיניסטי, והחלק הבא בסדרה יעביר את אותה סביבה ל-Newton.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.