Jeff: מודלי החלטה תואמי Jev בגודל 0.8B שאומנו על GPU מקומי אחד
פרויקט הקוד הפתוח Jeff הופך את Qwen3.5 ו-Gemma 4 למסווגים קטנים ללא אימון מוקדם, שמחזירים הסתברות מכוילת לכל אפשרות במעבר קדימה אחד תוך כ-22 אלפיות שנייה בלבד לכל החלטה.
ב-GitHub הופיע פרויקט הקוד הפתוח Jeff: הוא הופך מודלים קטנים של Qwen3.5 ו-Gemma 4 בגודל 0.8B ו-2B למסווגים שמשתמשים באותו מבנה בקשה כמו Jev. המשתמש מתאר מצב ומונה את האפשרויות במילים פשוטות, והמודל מחזיר הסתברות מכוילת לכל אפשרות במעבר קדימה אחד. המודל אינו מייצר טקסט, ולכן אין צורך לפענח תשובה. החלטה נמשכת כ-22 אלפיות שנייה על NVIDIA RTX PRO 6000 וכ-28 אלפיות שנייה על Apple M4 Max דרך MLX.
מהו Jeff
מצב zero-shot פירושו שהאפשרויות יכולות להיות כל דבר: תורי תמיכה, כוונות משתמשים, תגיות מודרציה או מהלכים במשחק. הקטגוריות אינן חייבות להופיע בנתוני האימון, משום שהמשתמש מתאר אותן בבקשה. ב-Hugging Face פורסמו שלושה מודלים: Jeff-Qwen3.5-0.8B, Jeff-Qwen3.5-2B ו-Jeff-Gemma4-E2B. בקשה אחת יכולה לכלול שלושה סוגי שאלות: בחירה בין עד 255 אפשרויות, תשובת כן/לא כהסתברות, וניקוד לפי סקאלה שמתוארת בבקשה.
תוצאות הבנצ'מרקים
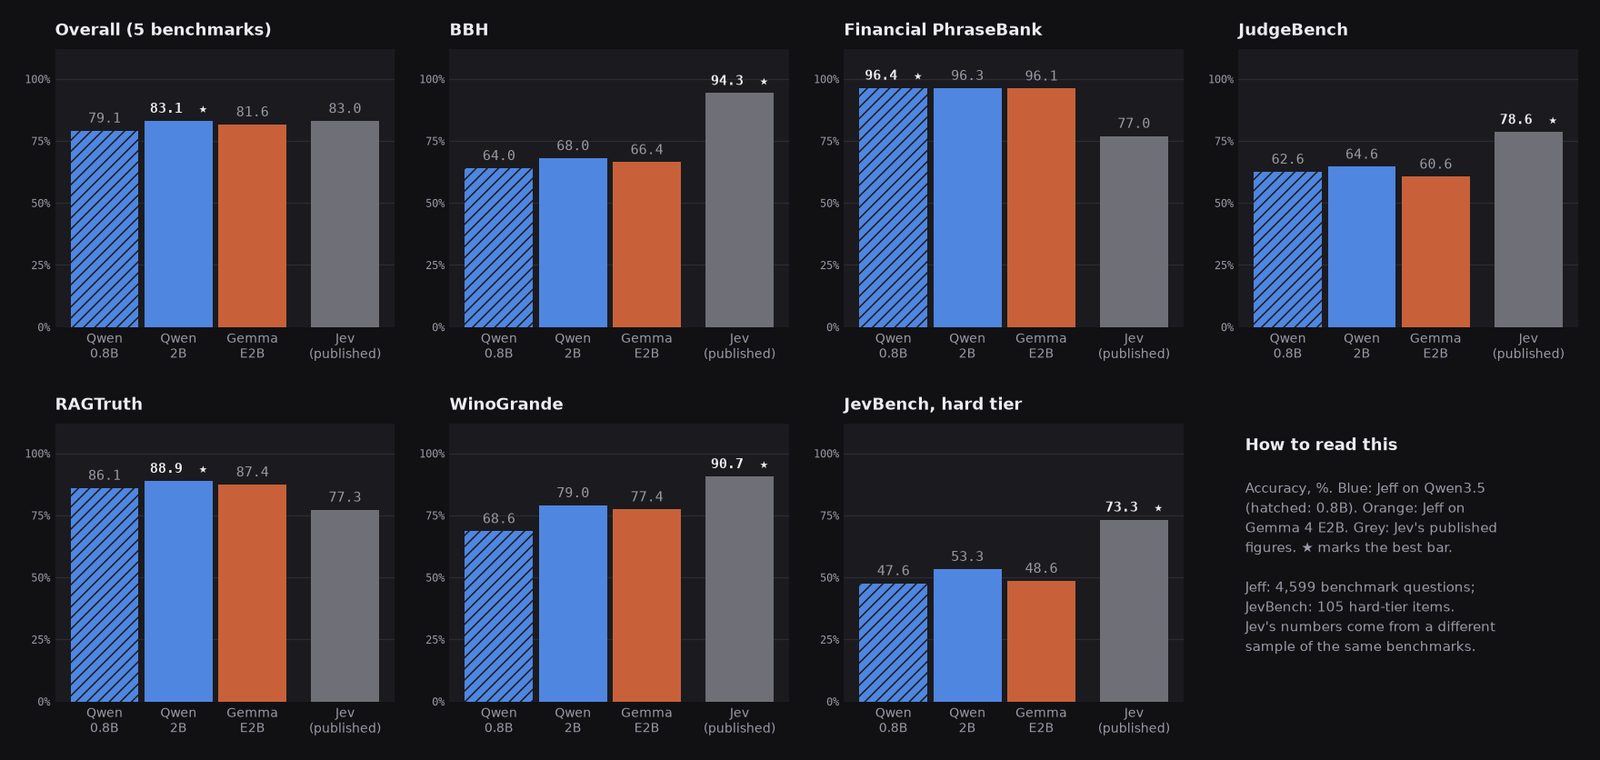
המודלים נבחנו על 4,599 שאלות מחמישה בנצ'מרקים ציבוריים, ובנפרד על הדרגה הקשה של JevBench, 105 פריטים. בציון הכולל Jeff-Qwen3.5-2B מגיע ל-83.1, Jeff-Gemma4-E2B ל-81.6 ו-Jeff-Qwen3.5-0.8B ל-79.1, לעומת 83.0 בנתונים שפורסמו של Jev. ב-Financial PhraseBank המודלים הקטנים מטפסים ל-96.4 מול 77.0, ואילו במבחני חשיבה הם מפגרים: BBH יורד ל-64.0 מול 94.3. המחברים כותבים שהציון הכולל מגיע ממשימות סיווג, שבהן המודלים הקטנים אינם נחותים מהגדולים.
אימון על חומרה מקומית
הפרויקט נבנה על חומרה מקומית: המודל 0.8B מתאמן כשעתיים על כרטיס מסך בודד מדגם RTX PRO 6000 בתחנת עבודה, וה-2B כשלוש וחצי שעות. נתוני האימון הסינתטיים נכתבו בידי מודל פתוח, Qwen3.8-Flash-Next, על שני מכשירי DGX Spark, והבדיקות נעשו ב-MacBook. לא נעשה שימוש ב-GPU בענן, ופלט של מודל סגור לא נכנס לנתוני האימון. Jeff הוא פרויקט עצמאי ואינו קשור ל-TypeSafe, יוצרי Jev. הקוד משוחרר ברישיון MIT והמשקולות ב-Apache 2.0.
משחקים ומגבלות
כדי לבחון יכולות zero-shot שיחק Jeff בשלושה משחקים, כשבכל תור תואר המצב במילים: 6.55 הריגות ב-Doom, כמו בוט חוקים שנכתב ביד, 10.3 חציות ב-Frogger לעומת 1.0 במודל שלא אומן, ו-57.0 מתוך 98 נקודות ב-Pac-Man לעומת 25.8, בהחלטה בת 29 עד 49 אלפיות שנייה על M4 Max. בין המגבלות המפורטות: מודלים קטנים אינם מנמקים, הם עובדים רק עם טקסט באנגלית, ציוני הבנצ'מרק אינם מנבאים את המשחק, וה-2B משחק גרוע יותר מה-0.8B. כיול קצר על דוגמאות משלך עוזר מאוד: גרסה לניווט קולי על כ-11 אלף דוגמאות העלתה את הדיוק מ-31.7% ל-95.8% בפחות מחצי שעה על כרטיס מסך אחד.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.