SiTech AI Team2 წთ. საკითხავი
גיזום מודלי שפה כמו פיזיקאי: הסרת בלוקים כבעיית אופטימיזציית איזינג
מאמר חדש של Multiverse Computing מנסח מחדש את בחירת הבלוקים בטרנספורמר כבעיית אופטימיזציה בינארית שממופה לזכוכית איזינג, ומשיג יתרון של כמעט 23 נקודות MMLU בדחיסה עמוקה ללא אימון מחדש.
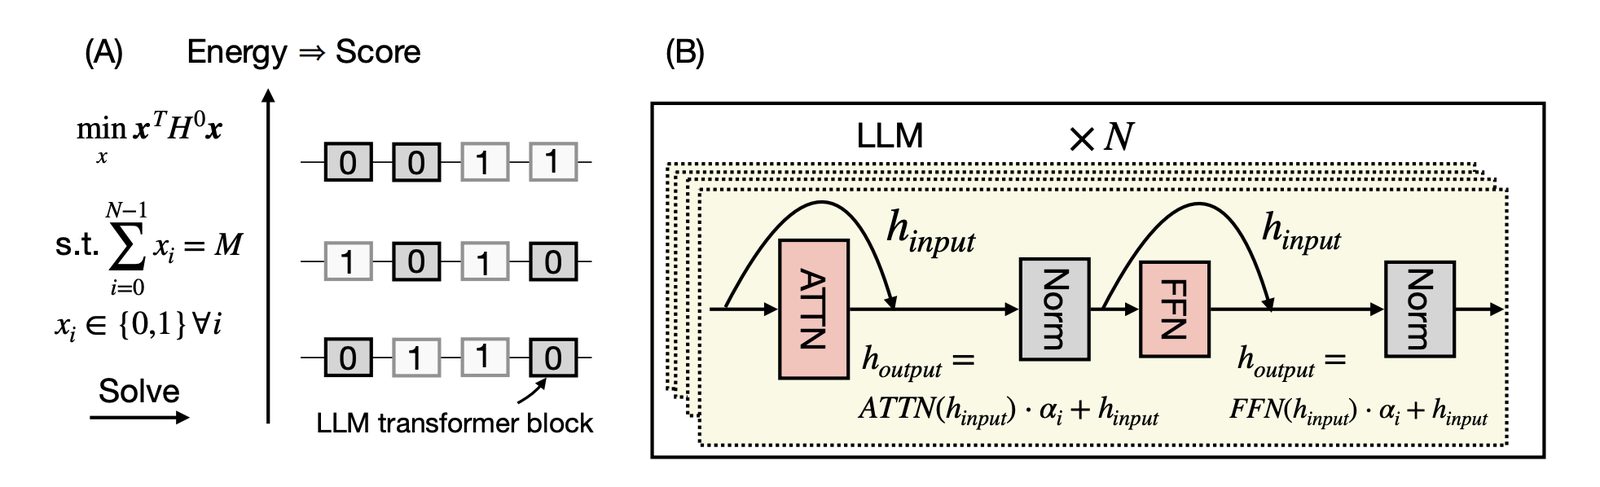
מחיקת בלוקים שלמים של טרנספורמר היא דרך זולה להאיץ מודל שפה גדול: המודל פשוט מתקצר, ולכן block removal (depth pruning) מניבה האצת הסקה צפויה מעל לחיסכון בזיכרון ומשתלבת עם קוונטיזציה. הקושי הוא בהחלטה אילו בלוקים לחתוך: ההשפעה של הסרת בלוק תלויה בכך אילו בלוקים אחרים הוסרו יחד איתו. במאמר LLM Compression by Block Removal with Constrained Binary Optimization (בלוג Hugging Face, 21 בספטמבר 2026) הבחירה מנוסחת מחדש כאופטימיזציה בינארית עם אילוץ (CBO) שממופה לזכוכית איזינג, שהאנרגיה שלה היא מדד זול לאיכות המודל.
 ההססיאן מחושב פעם אחת בלבד, ממעברים קדימה ואחורה על מערך כיול קטן; לאחר מכן כל תצורה מועמדת מוערכת בחישוב אנרגיה זול אחד, בלי להריץ את המודל. אותו הססיאן משמש ערכים רבים של M.
 ב-Llama-3.1-8B-Instruct, בהסרת 16 מתוך 32 בלוקים, המצב המעורר ה-17 הוא הראשון שמציע להסיר בלוק בתחילת המודל, ולאחר אימון מחדש קל הוא עוקף את מצב היסוד. ללא אימון מחדש מגיע Llama-3.3-70B-Instruct ל-76.6 ו-76.9 ב-MMLU בהסרת 32 ו-40 מתוך 80 בלוקים, לעומת 59.3 ו-54.0 ל-block influence; ב-Qwen3-14B, בהסרת 12 מתוך 40, היתרון כ-10 נקודות. השיטה עוברת גם למודל ההיברידי NVIDIA-Nemotron-3-Nano-30B-A3B-FP8 ומנצחת את block influence ב-AIME25 וב-GPQA. הקוד פתוח.
מדוע הבלוקים אינם בלתי תלויים
שיטות קיימות מדרגות כל בלוק בנפרד — לפי גודל, רגישות או block influence — ומסירות את הפחות חשובים: זהו קירוב שדה ממוצע שרואה את תרומת הבלוק כבלתי תלויה באחרים. בפועל הסרת בלוק 20 מזיקה רק אם יחד איתו הוסרו בלוק 19 או 24, ומספר הצירופים גדל באופן מעריכי.מבחירת בלוקים למינימיזציית אנרגיה
לכל בלוק מוצמד משתנה בינארי: 0 להשאיר, 1 להסיר. פיתוח טיילור מסדר שני של פונקציית ההפסד מניב מטריצת הססיאן מקורבת: האלכסון מראה עד כמה חשוב כל בלוק בפני עצמו, והאיברים מחוץ לאלכסון הם הצימודים הזוגיים ששיטות שדה ממוצע מתעלמות מהם. המשימה היא למצוא M בלוקים מתוך N שהסרתם ממזערת את האנרגיה.
ההססיאן מחושב פעם אחת בלבד, ממעברים קדימה ואחורה על מערך כיול קטן; לאחר מכן כל תצורה מועמדת מוערכת בחישוב אנרגיה זול אחד, בלי להריץ את המודל. אותו הססיאן משמש ערכים רבים של M.
פותרים, ספקטרום ותוצאות
על GPU בודד המחברים סורקים בכוח גס עשרות מיליארדי תצורות; המקרה הכבד ביותר, הסרת 8 מתוך 80 בלוקים של Llama-3.3-70B (כ-29 מיליארד תצורות), ארך כיומיים. מעבר לכך המשימה בצורת QUBO עוברת לפותרים קלאסיים, קוונטיים ובהשראה קוונטית — חישול, QAOA, tabu search, branch-and-bound; פותר tabu בקוד פתוח מגיע למצבי האנרגיה הנמוכים בתוך שניות. מצב היסוד האמיתי אינו נדרש: די בכמה מצבי אנרגיה נמוכה טובים.
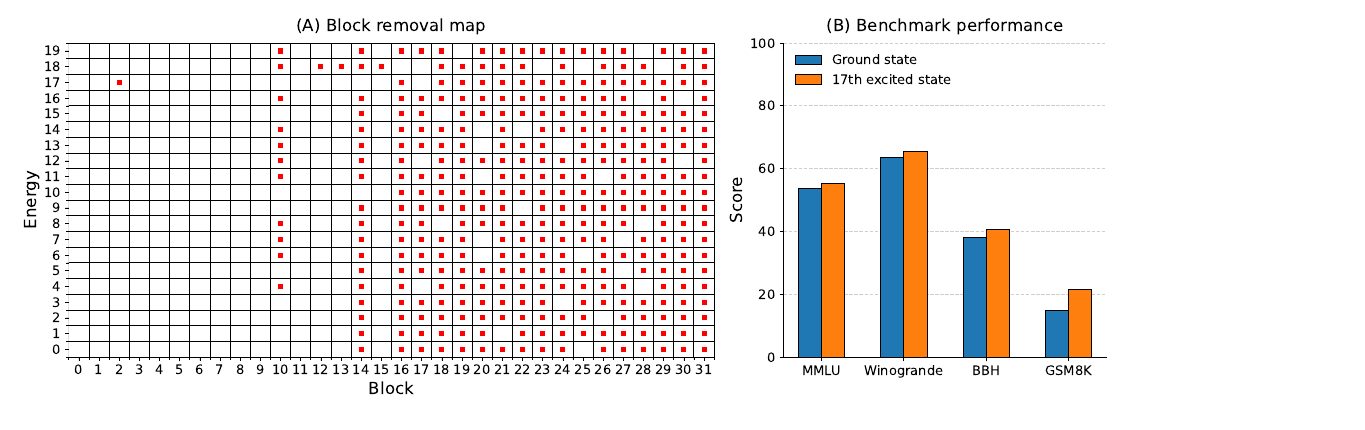
ב-Llama-3.1-8B-Instruct, בהסרת 16 מתוך 32 בלוקים, המצב המעורר ה-17 הוא הראשון שמציע להסיר בלוק בתחילת המודל, ולאחר אימון מחדש קל הוא עוקף את מצב היסוד. ללא אימון מחדש מגיע Llama-3.3-70B-Instruct ל-76.6 ו-76.9 ב-MMLU בהסרת 32 ו-40 מתוך 80 בלוקים, לעומת 59.3 ו-54.0 ל-block influence; ב-Qwen3-14B, בהסרת 12 מתוך 40, היתרון כ-10 נקודות. השיטה עוברת גם למודל ההיברידי NVIDIA-Nemotron-3-Nano-30B-A3B-FP8 ומנצחת את block influence ב-AIME25 וב-GPQA. הקוד פתוח.
שתף חוויה דיגיטלית
SSiTech
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.