Qwen3.6 27B — נקודת האיזון המעשית לפיתוח מקומי
פוסט בבלוג של Quesma טוען שהמודל הצפוף Qwen3.6 27B הוא הראשון ששווה להריץ באופן קבוע: הוא עובד היטב על מחשב נייד, גובר על גרסת ה-MoE המהירה במשימות אמת, ומגיע במדדי הביצועים לרמת מודלי הפרונטיר מאמצע 2025.
מודלים מקומיים לא נתפסו לרוב כאופציה רצינית לעבודה יומיומית, אך פוסט בבלוג של Quesma טוען ש-Qwen3.6 27B הוא הראשון ששווה להריץ באופן קבוע. המודל יוצא בשתי גרסאות: Mixture of Experts בשם Qwen3.6 35B A3B, המהירה יותר, ו-Qwen3.6 27B הצפוף — איטי יותר, חזק יותר, וזו הגרסה שהמחבר ממליץ עליה.
מה נבדק
מעבר למבחני כתיבה יצירתית שגרתיים, המודל התבקש לבנות שולה מוקשים משושה דרך OpenCode עם pnpm. הוא יצר פרויקט עובד עם חבילת Node מסודרת מהנחיה אחת, כבר בניסיון הראשון. גרסת 35B A3B המהירה עבדה מהר יותר אך התעלמה מההוראה ליצור חבילה ושמה הכול בקובץ index.html אחד. הנחיה ארוכה יותר לדף נחיתה של חנות נרות רצה כמה דקות והחזירה עמוד מותאם עם ברירות מחדל סבירות. המסקנה: לא מרשים בקנה מידה של מודלי פרונטיר, אבל כבר עבודה מעשית.
הרצה מקומית
ההגדרה נשענת על llama.cpp ולא על Ollama, עם כימות של 8 סיביות מ-Hugging Face: Qwen3.6-27B-MTP-GGUF של unsloth בגרסת Q8_0, שתומכת בחיזוי ריבוי טוקנים. פקודת llama-server אחת מריצה את המודל עם ניסוח MTP, כל השכבות על ה-GPU, flash attention דלוק, הקשר של 64k ופורט קבוע; ההקשר המקורי של המודל הוא 256k. כימות של 8 סיביות מחצה את הנפח לעומת גרסת BF16 כמעט בלי פגיעה באיכות, וגרסת 4 סיביות נכנסת מתחת ל-18 ג'יגה-בייט — קטנה מספיק למכשיר עם 32 ג'יגה-בייט.
ביצועים ומיקום בשוק
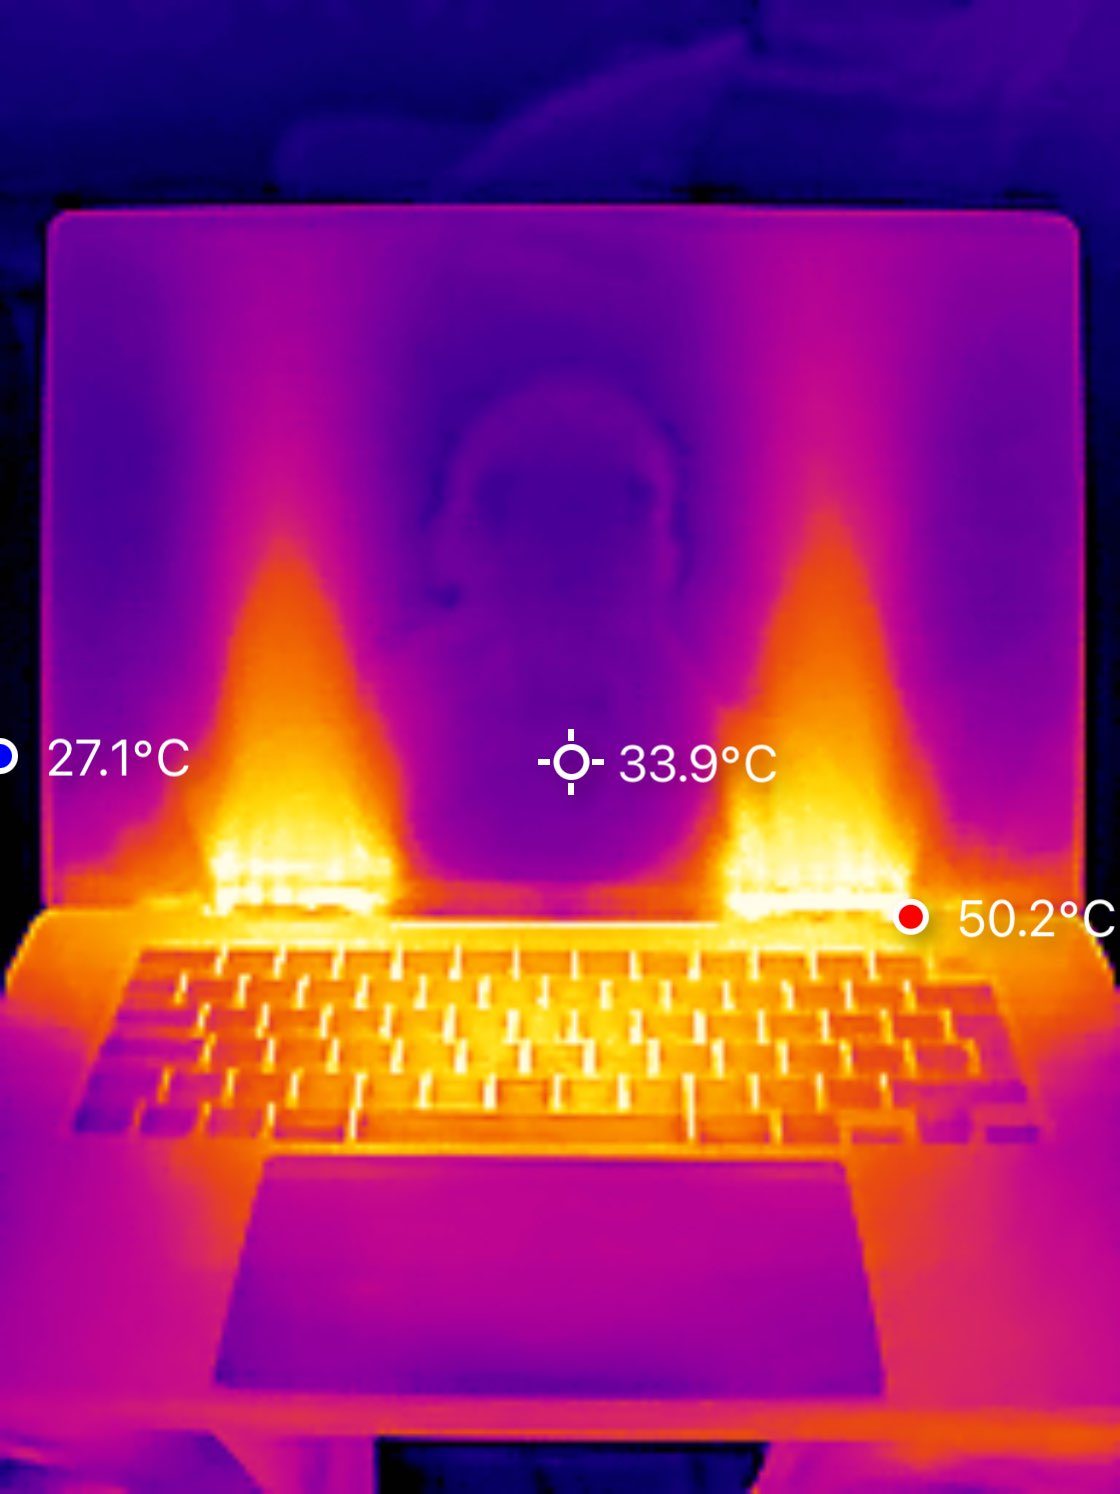
על MacBook M5 Max עם 128 ג'יגה-בייט זיכרון מאוחד המודל מייצר כ-30 טוקנים בשנייה — בתוך הטווח המקובל של API-ים למודלי פרונטיר — תוך שימוש של כ-95 אחוז מה-GPU. llama.cpp היה מהיר יותר מ-mlx-lm, אף שהאחרון מכוון לשבבי אפל; שתי גרסאות Qwen3.6 נשארות בתוך 48 ג'יגה-בייט. על כרטיס צרכני Nvidia RTX 5090 דיווח מגיב ב-Hacker News על כ-50 טוקנים בשנייה בהקשר של 123k, עם כימות Q6_K ומטמון KV מסוג Q4_0. במדד הבינה של Artificial Analysis מקבל ה-27B ציון 37, שאותו ממפה הפוסט לרמת פרונטיר של אמצע 2025 — לפני 35B A3B עם 32 ו-Gemma 4 31B עם 29. המחבר בכל זאת מעדיף את ה-27B: שליש מכמות הקוד, אך באיכות גבוהה יותר. הטיעון הרחב יותר: מודלים מקומיים ניתנים לכוונון, אי אפשר לשלול אותם, והם מתאימים לנתונים רגישים.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.