Qwen 3.8 27B: מצוין בגודל 17 ג'יגה-בייט, אך כברירת מחדל הוא חושב יותר מדי
מעבדת Qwen של עליבאבא פרסמה מודל של 27 מיליארד פרמטרים עם תמיכה בראייה תחת רישיון Apache 2.0. הוא רץ על חומרה ביתית, אבל הגדרת ברירת המחדל של מנגנון החשיבה מבזבזת משאבים רבים.
ב-14 באוגוסט פרסמה מעבדת המחקר Qwen של עליבאבא את Qwen 3.8 27B — מודל שפה בעל 27 מיליארד פרמטרים עם תמיכה בראייה, תחת רישיון Apache 2.0. המשקלים זמינים ב-Hugging Face, ואת המודל אפשר להריץ מקומית דרך LM Studio או llama.cpp.
ביצועים ורשמים ראשונים
התוצאות שהחברה מפרסמת מציבות את המודל החדש בבירור מעל קודמו, Qwen 3.6 27B, ואף מעל Qwen 3.7-Plus הסגור — מודל שנחשב לאחד החזקים של Qwen בכל גודל עוד במאי. הערכות בלתי תלויות טרם פורסמו. המפתח סיימון ויליסון, שבדק את המודל על MacBook Pro M5 Max עם 128 ג'יגה-בייט זיכרון ועל NVIDIA DGX Spark, תיאר את גודל 27B כגודל מצוין להרצת מודל מוכשר על מחשב נייד רגיל.
חשיבה מופרזת כברירת מחדל
למודל יש פרמטר reasoning_effort שערך ברירת המחדל שלו הוא xhigh, וגרסת ה-GGUF ב-LM Studio שומרת עליו. בפועל גם בקשות פשוטות צורכות אלפי טוקנים של חשיבה: הקשר ברירת המחדל של LM Studio, 8,192 טוקנים, התמלא במהירות, והבעיה נעלמה רק לאחר טעינת ההקשר המלא של 262,144 טוקנים.
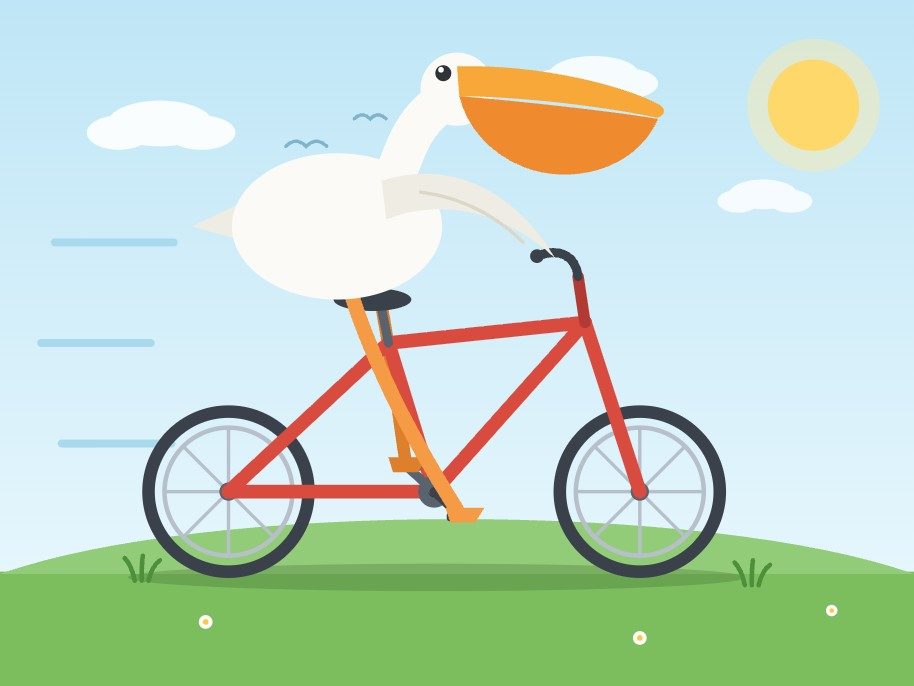
בבדיקה אחת נדרשו למודל 21 דקות ו-22,276 טוקני חשיבה כדי להפיק 3,223 טוקנים של SVG — שקנאי רוכב על אופניים. כשהחשיבה כבויה, אותה בקשה הסתיימה ב-137 שניות וב-3,715 טוקנים. לבקשה פשוטה — לצייר SVG של עיגול — השיב המודל בהרכב אנימטיבי מורכב. העצה המעשית של הכותב היא להריץ את המודל ברמה נמוכה או עם חשיבה כבויה, לפחות בהתחלה.
ראייה, כלים ומהירות
המודל התגלה כחזק בזיהוי חזותי: כשהתבקש להחזיר תיבות תוחמות ב-JSON בסקאלה 0–1000 עבור שקנאים בתצלום, הוא החזיר קואורדינטות שהתאימו לאובייקטים בדיוק. מבקשה בודדת הוא גם בנה כלי HTML קטן שמצייר תיבות כאלה על תמונה ופועל כולו במצב לא מקוון; התוצאה הייתה מורכבת מדי אך עובדת.
החיסרון המרכזי הוא המהירות. LM Studio סיפק כ-15 עד 30 טוקנים בשנייה, לעומת 74 ו-184 טוקנים בשנייה שמדד Artificial Analysis למודלים המאוחסנים 5.6 Sol ו-5.6 Luna של OpenAI. יש כבר אופטימיזציה קהילתית: Qwen תומך ב-Multi-Token Prediction, ושרת llama.cpp עם מצב הפענוח הספקולטיבי draft-mtp עקף את גרסת ברירת המחדל של LM Studio בכ-72% במדידה על DGX Spark.
המסקנה הרחבה היא מה שקובץ בגודל 17 ג'יגה-בייט מדגים כעת: הקשר ארוך, קריאה לכלים, ראייה ויצירת קוד מוכשרת — הכול על חומרה שכבר נמצאת בידי המפתח. השאלה הפתוחה היא אם מהירות ההסקה תדביק את היכולות האלה.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.