„המודל המקומי שלכם חכם ממה שנדמה“ — איפה ערימת האינפרנס מאבדת איכות
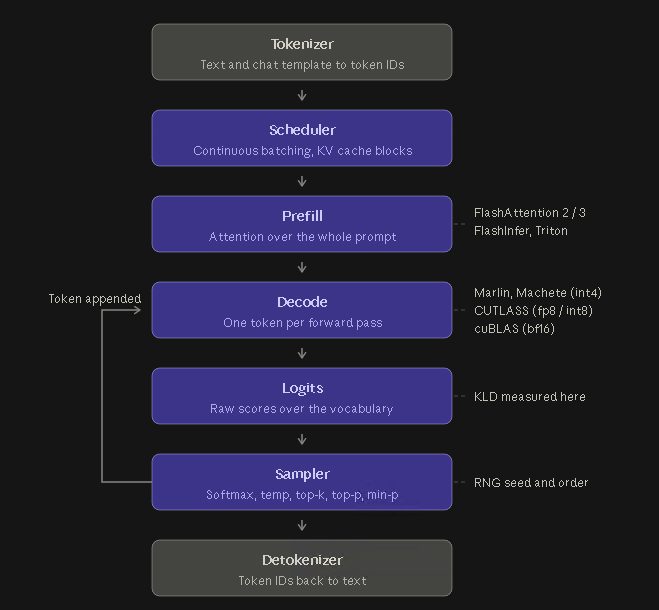
סדרת ניסויים בפורום Level1Techs מראה שה"טיפשות" של מודל מקומי נובעת פעמים רבות מבק-אנדים של attention, מכיול מטמון KV ומקביליות טנזורית — ולא מהמודל עצמו, כפי שנדמה לרבים.
סדרת ניסויים שפורסמה בפורום Level1Techs מראה שמודל שרץ מקומית נראה לעתים קרובות חלש מכפי שהוא באמת — והאשם הוא פעמים רבות ערימת האינפרנס עצמה ולא המודל. מחבר השרשור, משתמש בשם thr3e, מריץ את אותם משקלים בהגדרות שונות של סביבת ההרצה ומודד היכן הפלטים מתחילים להתפצל.
אין שתי מימושים זהים
המחבר מכנה "מימוש ייחוס" את המעבדה שמפרסמת את המודל, מארחת אותו לראשונה ומציגה את תוצאות הבנצ'מרק המקוריות: החומרה והתוכנה שלה שונות משלכם. תצורות ביתיות מערבבות לא פעם דורות שונים של כרטיסים גרפיים, וקבוצות פקודות שונות מחשבות את המתמטיקה של הטוקן הבא אחרת גם כשהמשקלים זהים לחלוטין. מכולת ה-vLLM מסוג nightly ששימשה בניסויים הכילה 734 חבילות, מהן 252 חבילות Python — 734 בסיסי קוד, כל אחד עם באגים משלו.
שלושה מבחנים: בק-אנדים, מטמון KV וכיול
המבחן הראשון השווה שלושה בק-אנדים של attention — FlashAttention 2, Flash Inference ו-Triton Attention — על Qwen3.6-27B ב-BF16 על כרטיס RTX PRO 6000 Blackwell, בלי לשנות דבר אחר. העומס היה הקשר של כ-100 אלף טוקנים שנלקח מתהליך עבודה אמיתי עם קריאות לכלים. באלפי הטוקנים הראשונים כל הבק-אנדים הסכימו, ובהמשך הפרומפט החלו להתפצל. הרצה חוזרת של אותו בק-אנד הניבה לוגיטים זהים ביט-לביט, כך שהפיצול נובע מהמתמטיקה של שלב ה-prefill ולא מרעש.
המבחן השני כִּיֵּל רק את מטמון ה-KV: גרסת int8 הצליחה בסופו של דבר להתאושש משגיאה בקריאה לכלי, גרסת int4 לא. המבחן השלישי השווה חמישה פורמטים של משקלים: INT8 W8A16 היה הטוב ביותר, בעוד NVFP4 של Nvidia הגיע למקום האחרון — כשלמעלה מ-50% מהטוקנים "התהפכו" בהקשר של 88 אלף טוקנים. גם NVFP4 וגם AWQ W4A16 הריצו פקודה שגויה על התקן Cisco — 'show run' במקום 'show arp'.
טוקן אחד שהתהפך, משימה אחת שנכשלה
בחלק השני המחבר תיעד 100% מהלוגיטים בזמן קריאות לכלים ופיצל את ההרצות כדי לראות לאן כל גרסה המשיכה. במקרה אחד הרצה עם FlashAttention 2 פנתה ל-GigabitEthernet0/1/4 במקום ל-GigabitEthernet0/0/1.201, ואחר כך הריצה 'show run' במקום 'show mac address table'; במקרה אחר היא נכשלה בהגדרת תיאור לממשק. עם מקביליות טנזורית אותה משימה עברה ב-TP1, נכשלה ב-TP2 ושוב עברה ב-TP4 — מה שבבדיקה מעמיקה יותר מצביע בדרך כלל על NCCL.
איך למדוד נכון
העצה בשרשור היא להריץ בנצ'מרקים סטנדרטיים שמייצגים את עומס העבודה האמיתי: הורדת temperature לאפס והדבקת שלושה פרומפטים אינן מקבילה טובה לעבודה אגנטית, שדורשת קריאות לכלים בהקשר ארוך ובדיקות בתחום ידע ספציפי. יש להשתמש בהגדרות הסמפלר ובתבנית הצ'אט שמופיעות בכרטיס המודל — temperature נמוך מדי הוא הסיבה שחלק מהמודלים נתקעים בלולאה בתוך פלט ה-THINK. משתתפים גם הדגישו שסטיית KL מודדת עד כמה ההתפלגות זזה מהייחוס, ולא נכונות, וכי היא כיוונית; אי-הסכמה בטופ-1 היא מדד נפרד ומחמיר יותר. BF16 הוא אמת מידה לנאמנות נומרית, לא אורקל: מודל מכויל יכול לסטות ממנו ועדיין לתת תשובה טובה יותר.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.