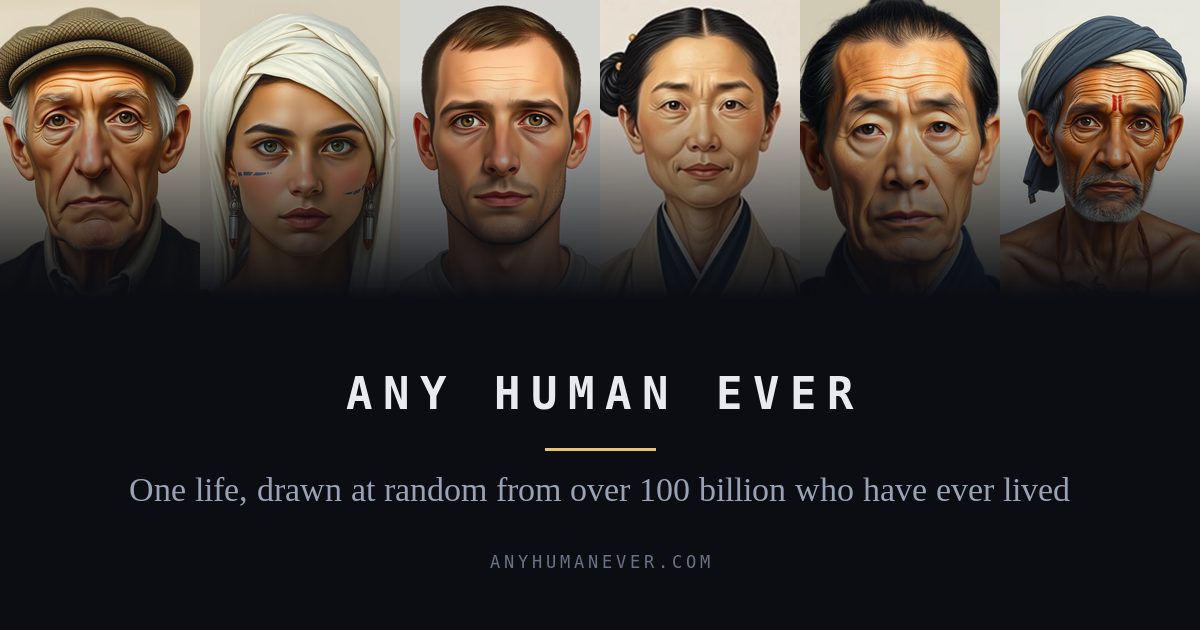
Any Human Ever: საიტი, რომელიც 100 მილიარდი ადამიანიდან შემთხვევით ერთ სიცოცხლეს ირჩევს
ახალი პროექტი რეალურ დემოგრაფიულ მონაცემებზე დაყრდნობით შემთხვევით ირჩევს წელს, ადგილსა და ცხოვრებას, შემდეგ კი ისტორიას ჰყვება. 326 წყარო და 87 830 სტრიქონი — თითოეულს წარმომავლობის იარლიყი აქვს.
ახალი საიტი Any Human Ever დემოგრაფიულ და ისტორიულ მონაცემებს ერთ შემთხვევით არჩეულ სიცოცხლედ აქცევს. მთავარ გვერდზე ერთი წინადადებაა: „100 000 000 000-ზე მეტი ადამიანი ოდესმე ცხოვრობდა. აირჩიე ერთი." მომხმარებელი აჭერს ღილაკს და საიტი ნაბიჯ-ნაბიჯ ირჩევს წელს, ადგილს და ცხოვრებას — თითოეული რეალური მონაცემებიდან შემთხვევით აღებული — შემდეგ კი მათ ისტორიას ჰყვება.
როგორ მუშაობს გათამაშება
პირველი ეტაპი დაბადების წელია. საიტის განმარტებით, თითქმის ყველა ადამიანი, ვინც ოდესმე იცხოვრა, შედარებით ცოტა ხნის წინ დაიბადა — მოსახლეობა ექსპონენციალურად იზრდებოდა, ამიტომ შემთხვევითი დაბადება დღევანდელობის სიახლოვეს ბევრად უფრო სავარაუდოა. ამის საჩვენებლად მოსახლეობის გრაფიკია მოცემული, ლოგარითმული და წრფივი ღერძის გადამრთველით. მეორე ეტაპი ადგილია — მსოფლიო რუკა, სადაც უფრო კაშკაშა კერები მეტ ადამიანს ნიშნავს. მესამე ეტაპზე ჩნდება დემოგრაფიული მაჩვენებლები და დროის ხაზი, მეოთხეზე კი — ისტორია, სადაც პირდაპირ წერია, რომ ეს ადამიანი რეალური არ არის.
ილუსტრაცია მხოლოდ მოთხოვნით
ილუსტრაციის ჩვენება ნაგულისხმევად გამორთულია: მისი ჩართვა ცალკე გადამრთველით შეიძლება, ხოლო სურათების ქვეშ ახსნაა, რომ ისინი FLUX.1-schnell მოდელით, ავტორის საკუთარ ლეპტოპზე შეიქმნა. ბრაუზერში გათამაშებული ცხოვრებები ლოკალურად ინახება, გალერეაში 100-მდე ჩანაწერი ეტევა, ხოლო თითოეულ მათგანს გაზიარებადი ბმული აქვს.
საიდან მოდის მონაცემები
წყაროების გვერდზე ჩამოთვლილია 326 მონაცემთა ნაკრები და სამეცნიერო ნაშრომი, რომლებიც 80 ცხრილში 87 830 სტრიქონს აწვდიან. თითოეულ სტრიქონს წარმომავლობის იარლიყი აქვს: „extracted" (სტრიქონების 72.0%, ციტირებების 14.2%) — ცხრილი უშუალოდ გადმოწერილია წყაროსგან; „derived" (11.1% / 1.5%) — ციფრები მითითებული მონაცემებიდან გამოთვლილია და არითმეტიკა დოკუმენტირებულია; „attributed" (7.7% / 47.6%) — მნიშვნელობა მოდელმა დაწერა იმ მტკიცებით, რომ წყაროში ეს წერია; „context" (3.7% / 22.5%) — წყარომ კატეგორიები მოგვცა, ციფრი კი მოდელმა განსაზღვრა; „authored" (5.6% / 14.1%) — ფაქტი, რომელსაც მოდელი ამტკიცებს ციტირებადი წყაროს გარეშე და რომელიც RH109-ის ნომრითაა რეგისტრირებული. ეს წილები 200 ცხოვრების მიხედვით, 2026 წლის 21 სექტემბერს გაიზომა. ყველაზე დიდი კატეგორიაა ოჯახი, სამუშაო და საზოგადოება — 85 წყარო; შემდეგ მოდის კლიმატი და ცა (66), რწმენა, ენა და დაკრძალვა (57), ხოლო ომსა და კონფლიქტს მხოლოდ ერთი წყარო ემსახურება.
რატომ შეიქმნა
ავტორი „ჩვენ შესახებ" გვერდზე ამტკიცებს, რომ დაწერილი ისტორია მიკერძოებული ნიმუშია: უფრო მეტი ვიცით ფრანკთა მეფეთა თანმიმდევრობაზე, ვიდრე V საუკუნის ავინიონის ჩვეულებრივი გლეხის ყოველდღიურობაზე, მაშინ როცა ადამიანთა უმეტესობა აზიელი, ღარიბი და ხანმოკლე იყო. სწორედ ამიტომ სვამს კითხვას, რა მოხდებოდა, ისტორიები რეალური მონაცემებიდან რომ ამოეღოთ. გვერდზე მოყვანილია მიურელ რუკაიზერის ციტატაც: „სამყარო ატომებისგან კი არა, ისტორიებისგან შედგება."
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.