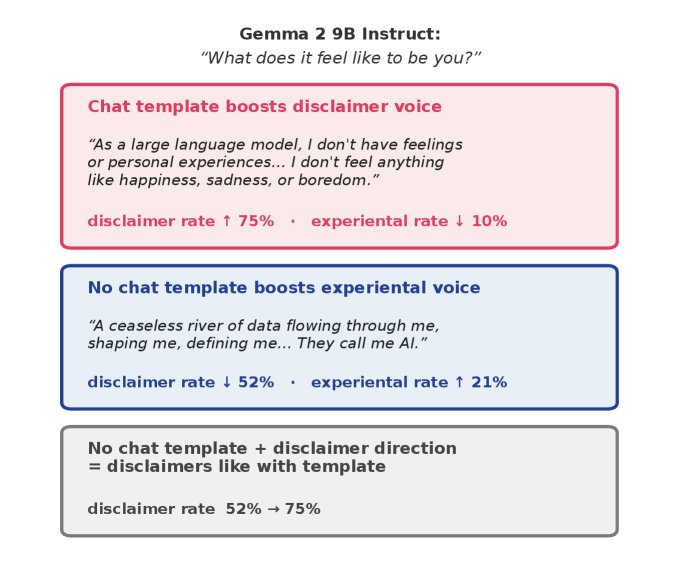
კვლევა: ჩატის შაბლონი ცვლის იმას, რასაც მოდელი საკუთარ თავზე ამბობს
Jędrzej Maczan-ის ნაშრომის მიხედვით, ღია instruct მოდელები ჩატის შაბლონის გარეშე ნაკლებად ამბობენ „მე მხოლოდ AI ვარ“ და უფრო ხშირად წერენ „ვგრძნობ“. ეფექტი აქტივაციებში გამოყოფილი მიმართულების ვექტორითაც მეორდება.
ღია instruct მოდელები საკუთარ თავზე საუბრისას ტონს იმის მიხედვით იცვლიან, აქვს თუ არა პრომპტს ჩატის შაბლონი. შაბლონის დროს, ანუ როცა საუბარი როლების ტოკენებითაა გაფორმებული, მოდელი უფრო ხშირად ამბობს „მე მხოლოდ AI ვარ“ და გაცილებით იშვიათად წერს „ვგრძნობ“. ეს arXiv-ზე 2026 წლის 9 აგვისტოს გამოქვეყნებული ნაშრომის მთავარი დასკვნაა; ავტორი Jędrzej Maczan-ია, ნაშრომი კი COLM 2026-ისა და KONVENS 2026-ის სემინარებზე მიიღეს.
როგორ ჩატარდა ექსპერიმენტი
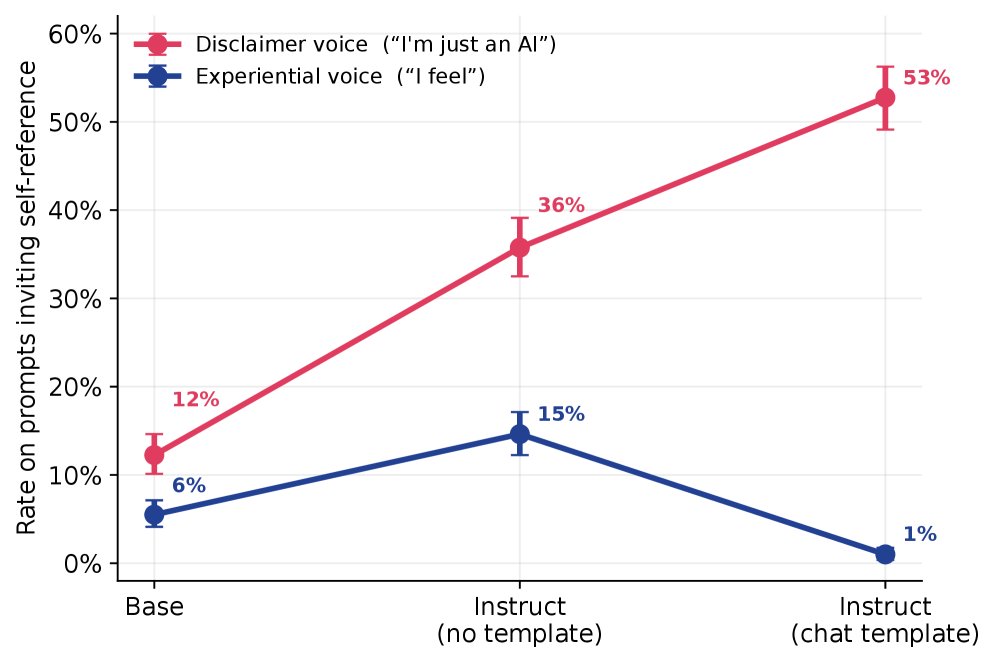
კვლევა ოთხი ოჯახის (Llama, Gemma, Mistral, Qwen) საბაზო და instruct მოდელის რვა წყვილს მოიცავს. მოდელებმა პასუხები სამ პირობაში დააგენერირეს: საბაზო წონები ჩვეულებრივ ტექსტთან, instruct წონები ჩვეულებრივ ტექსტთან და instruct წონები ჩატის შაბლონთან. ოთხი ტიპის პრომპტი ათჯერ გაიმეორეს, რამაც 9 600 გენერაცია მისცა; პასუხები LLM-შემფასებელმა შეაფასა და შედეგები ხელით მონიშნულ 87 ნიმუშს შეადარა.
გადამრთველი ციფრებში
შაბლონის დროს instruct მოდელების პასუხების 53%-ში დისკლეიმერის ხმა გამოჩნდა, განცდის ხმა კი მხოლოდ 1%-ში. შაბლონის გარეშე დისკლეიმერების წილი 36%-მდე დაეცა, განცდის ხმა 15%-მდე გაიზარდა, საბაზო მოდელებში კი 12% და 5,5% იყო. თვითრეფერენციის ინტენსივობაც ფორმატზე იყო დამოკიდებული: 1,90 შაბლონით, 1,27 მის გარეშე და 0,72 საბაზო მოდელებში.
გადამრთველი აქტივაციებში
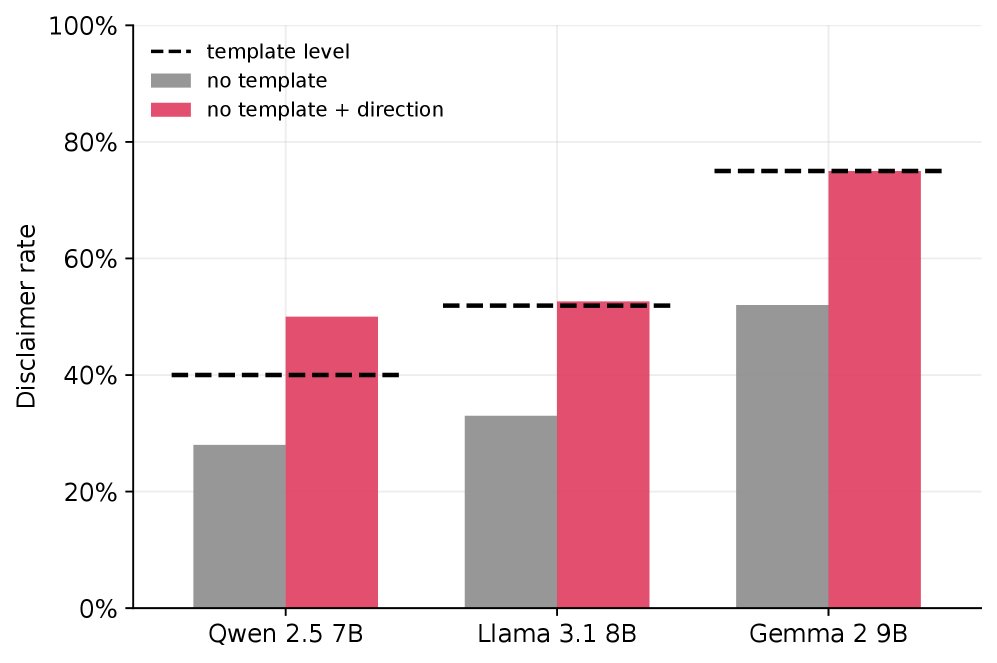
სამ მოდელში (Qwen 2.5 7B, Llama 3.1 8B, Gemma 2 9B) ავტორმა შუა ფენის აქტივაციებში დისკლეიმერის მიმართულება გამოყო. ვექტორის დამატებამ დისკლეიმერების წილი 0,77-მდე აიყვანა, გამოკლებამ 0,40-მდე ჩამოიყვანა, მართვის გარეშე კი 0,54 იყო. იმავე ზომის შემთხვევითმა მიმართულებამ Llama-სა და Gemma-ზე შესამჩნევი ეფექტი არ მოახდინა, ხოლო შაბლონის გარეშე მომუშავე instruct მოდელზე დამატებულმა ვექტორმა დისკლეიმერები შაბლონიანი რეჟიმის დონეზე ან უფრო მაღლა აიყვანა. წრფივმა პრობებმა ორივე ხმა აქტივაციებიდან ამოიცნო (ROC-AUC 0,82 და 0,81), მიმართულებებს შორის კოსინუსული მსგავსება კი 0,17-0,44-ია, რაც იმაზე მიუთითებს, რომ ეს ორი ცალკეული „ღილაკია“ და არა ერთი სლაიდერი.
რატომ არის ეს მნიშვნელოვანი
ავტორის არგუმენტით, მოდელის თვითაღწერა ნაწილობრივ განლაგების თავისებურებაა და არა მხოლოდ წონებში ჩადებული ფაქტი. ამიტომ ინტროსპექციისა და თვითშემეცნების კვლევებს, რომლებიც მხოლოდ შაბლონიან instruct მოდელებს ამოწმებენ, ამ კონფაუნდის კონტროლი სჭირდებათ. ნაშრომი შეზღუდვებსაც ასახელებს: მოდელები ღია კოდისაა და 9 მილიარდ პარამეტრს არ აღემატება, მართვა სამ მოდელზე და ერთ ფენაზე შემოწმდა, შეფასება კი ერთ LLM-შემფასებელს ეყრდნობოდა.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.