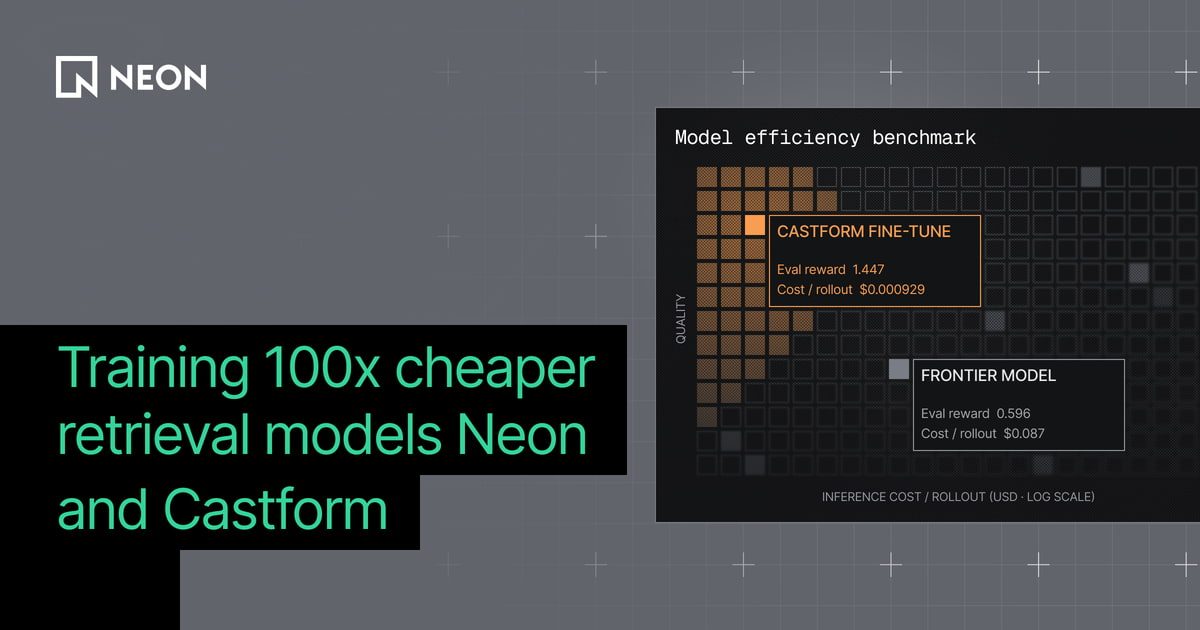
4B ღია მოდელი GPT-5.6 Sol-ს retrieval-ში ედრება — 100-ჯერ იაფად
Neon-ისა და Castform-ის ერთობლივი პოსტი აჩვენებს, როგორ უტოლდება RL-ით დატრენინგებული 4B ღია მოდელი ფრონტიერ მოდელს საძიებო ამოცანებში — დაახლოებით 100-ჯერ დაბალი ღირებულებით.
ღირებულების პრობლემა აგენტურ ძიებაში
2026 წლის 5 აგვისტოს Neon-მა Castform-თან ერთად გამოაქვეყნა მასალა, რომელშიც აღწერილია, თუ როგორ შეუძლია RL-ით (reinforcement learning) დატრენინგებულ 4B ღია მოდელს retrieval-ის ამოცანებში ფრონტიერ მოდელთან გათანაბრება — დაახლოებით 100-ჯერ დაბალი ღირებულებით ერთ მოთხოვნაზე.
სტატია აღწერს, როგორ შეიცვალა ინფორმაციის ძიება აგენტებში. 2022 წლისთვის ინდუსტრია embedding-ძიებაში ინვესტირებდა — pgvector გახდა Neon-ის ყველაზე ხშირად ჩამოტვირთული გაფართოება — და ინჟინრები RAG პაიპლაინებს ხელით ქმნიდნენ. 2025 წლისთვის retrieval აგენტური გახდა: მოდელები ერთი მოთხოვნის ნაცვლად ციკლში გეგმავენ და ეძებენ. ციკლის ყოველი იტერაცია ფრონტიერ მოდელის ახალი გამოძახებაა, ხოლო gpt-5.6-sol-ით ტიპური მრავალნაბიჯიანი მოთხოვნა 10 წამზე მეტს იკავებს და ბოლომდე დაახლოებით $0.03 ღირს.
ღია მოდელის სწავლება ძიებაში
პატარა ღია მოდელები დაახლოებით 100-ჯერ იაფია, თუმცა „ყუთიდან“ ამოღებისას დახურულ API მოდელებს ჩამორჩებიან. ამ სხვაობას RL post-training-ი ხურავს. Castform-ის მიზანია, დეველოპერებმა მოდელების post-training-ი მანქანური სწავლებისა და GPU-ის შიდა დეტალების გარეშე შეძლონ — Ying Hang Seah-ს, Castform-ის თანადამფუძნებლის თქმით, „ისეთივე ხელმისაწვდომი, როგორც prompt engineering“. ის აღნიშნავს, რომ გუნდების საუკეთესო სავარჯიშო მონაცემები ხშირად უკვე მათივე ბაზებში დევს.
პაიპლაინი მთლიანად Neon-ზე მუშაობს: ნედლი დოკუმენტები Postgres-შია, სინთეზური სავარჯიშო ამოცანები lakebase_text და lakebase_vector გაფართოებებით იწერება, ყოველი rollout-ის საძიებო გამოძახება Lakebase Search-ს იყენებს, ხოლო პროდუქციის ინფერენსი იმავე საძიებო ინსტრუმენტს იყენებს. ჯილდოს ფუნქცია სამ რამეს აფასებს — სწორი წყაროს პოვნას, სწორი ნაწყვის ციტირებას და სწორ პასუხამდე მისვლას.
ინფრასტრუქტურა არათანაბარი დატვირთვისთვის
ტრენინგი ძლიერ არათანაბარ დატვირთვას ქმნის: ათასობით პარალელური rollout, რომელთაგან თითოეული ათეულობით საძიებო გამოძახებას აკეთებს. Neon-ის დინამიური გამოთვლითი მასშტაბირება ამ პიკებს შთანთქავს ისე, რომ Castform-ს მაქსიმალურ სიმძლავრეზე მუდმივი რეზერვირება არ სჭირდება. პოსტის მიხედვით, ეს ინფრასტრუქტურა კიდევ უფრო მნიშვნელოვანი ხდება, როცა აგენტები მონაცემების შეცვლას იწყებენ: branching-ი ყოველ rollout-ს იზოლირებულ ბაზის მდგომარეობას აძლევს, ხოლო time-travel მოთხოვნები საშუალებას იძლევა აღადგინო, რა „დაინახა“ აგენტმა.
ავტორების მთავარი დასკვნა: კონკრეტულ ამოცანაში, როგორიც ძიებაა, post-trained ღია მოდელს შეუძლია ფრონტიერ მოდელებთან გათანაბრება და მათი დამარცხებაც — რიგით უფრო დაბალი ღირებულებით. ეს არგუმენტია იმის სასარგებლოდ, რომ აგენტურ retrieval-ს ყველაზე ძვირი ხელმისაწვდომი მოდელი აღარ სჭირდება.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.