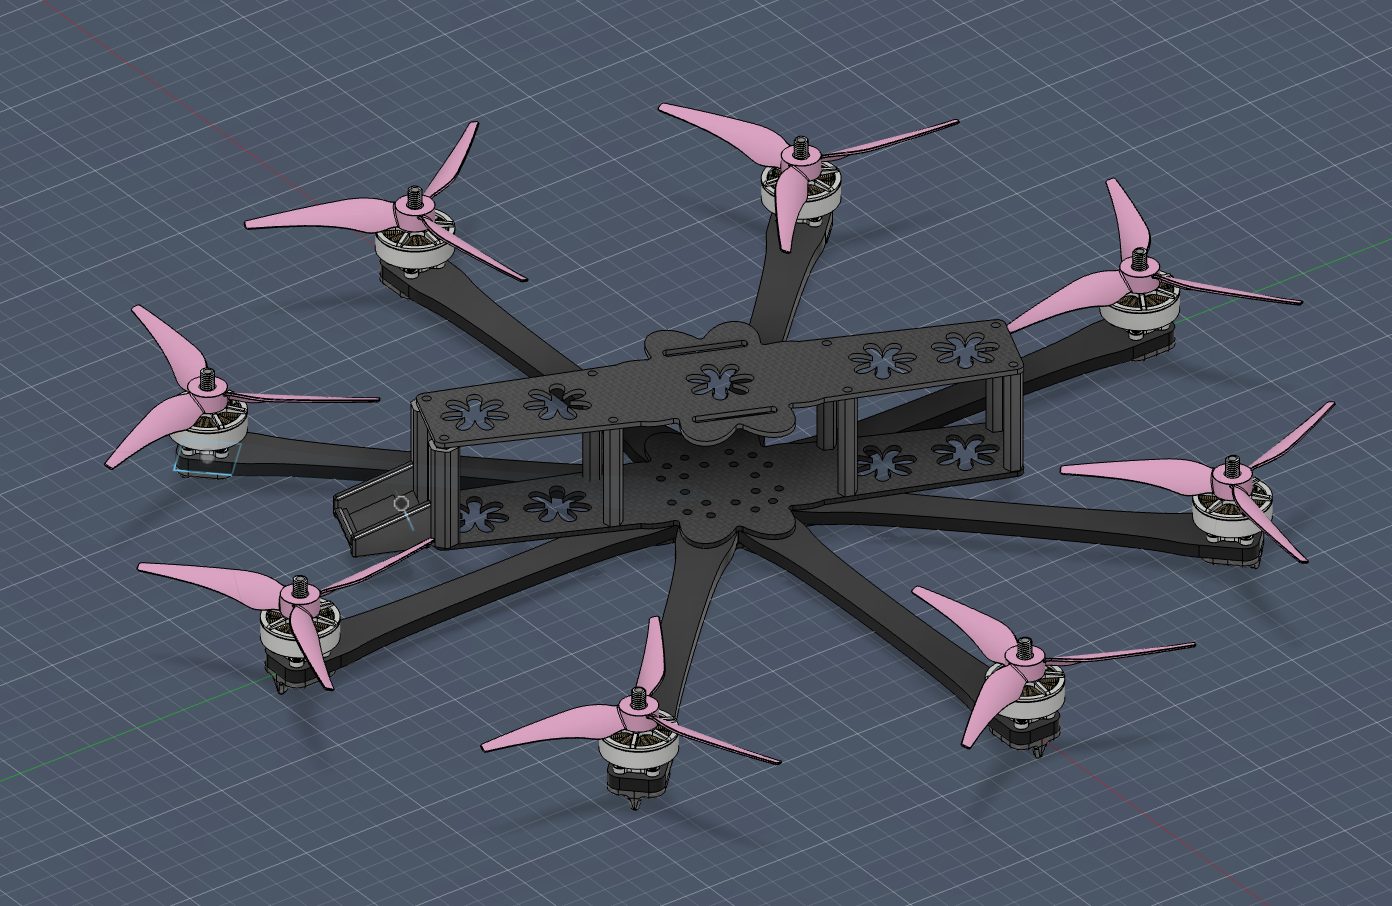
ინჟინერმა ოქტოკოპტერი ნულიდან ააწყო და RL პოლისი შეასწავლა
კაროლინა დუბიელმა ოქტოკოპტერი ჰარდვეარის გამოცდილების გარეშე ააწყო: იდეიდან პირველ ფრენამდე 2.5 კვირა, RL-ით მართულ ფრენამდე 8 კვირაზე ნაკლები. პოლისი ორი ძრავის გაფუჭებაზე გაწვრთნილი, რეალურად ოთხსაც გადაურჩა.
პროგრამული ინჟინერი კაროლინა დუბიელი, რომელსაც მანამდე სერიოზული ჰარდვეარის პროექტი არასდროს ჰქონია, თავად დააპროექტა, დაამუშავა, შეადუღა და გააფრინა საკუთარი ოქტოკოპტერი — შემდეგ კი გაწვრთნა reinforcement learning-ის პოლისი, რომელიც აპარატს ძრავების გაფუჭების შემდეგაც აფრენს. მისივე ცნობით, იდეიდან მფრინავ დრონამდე ორნახევარი კვირა დასჭირდა, RL-ით მართულ ფრენამდე კი რვა კვირაზე ნაკლები.
Fusion 360-იდან ხელით აწყობილ კორპუსამდე
კორპუსი Fusion 360-ში დააპროექტა და CNC-ით მოამუშავა: მკლავები G10 მინაბოჭკოვანი, კორპუსის ფირფიტები 5 მმ ნახშირბადის ბოჭკო, მკლავები ცენტრში ერთმანეთშია გადაჯვარედინებული სიმტკიცისთვის. შემდეგ ოთხი ეტაპი მოჰყვა: აწყობა, ელექტრონიკის მიერთება და ჩვეულებრივი ფრენა, პოლისის გაწვრთნა ნორმალური ფრენისა და ორი ძრავის გაფუჭებისთვის, და sim-to-real გადასვლა.
43 000 პარამეტრის ქსელი 50 Hz-ზე
საბოლოო კონტროლერი პატარაა: ორფენიანი MLP, თითო ფენაში 128 ერთეული — დაახლოებით 43 000 პარამეტრი — რომელიც 50 Hz-ზე მუშაობს დრონის საკუთარ ფრენის კონტროლერზე, ჩაშენებული ArduPilot-ის C++ კოდში ძრავების შერევის დონეზე, დამატებითი კომპიუტერისა და სიმულაციის შემდგომი დახვეწის გარეშე. ის კითხულობს ბოლო ათ მდგომარეობის კადრს (~0.2 წმ): ორიენტაცია, კუთხური სიჩქარეები, პოზიცია, სიჩქარე და რვაელემენტიანი არხი, რომელიც თითოეული ძრავის საწევ ძალას გადმოსცემს — გაფუჭებული ძრავები იძულებით ნულზეა.
ვარჯიში მთლიანად სიმულაციაში მიმდინარეობდა — MuJoCo და PPO PufferLib-ის მეშვეობით — ნულ, ერთ ან ორ მკვდარ ძრავთან ეპიზოდების ფიქსირებულ ნარევზე (წონები 0.1, 0.2, 0.7) და კურიკულუმით, რომელიც domain randomization-ს ნომინალურიდან სრულამდე ზრდის. ერთი ხრიკი სიმეტრიის საშუალოშეწონილი თავია: ქსელი წონებს ორჯერ ატარებს — ნამდვილ მდგომარეობაზე და მის 180°-ით შემობრუნებულ ვერსიაზე — და შედეგებს ასაშუალოებს, რაც მას ამ ბრუნვის მიმართ ზუსტად ეკვივარიანტულს ხდის დამატებითი პარამეტრების გარეშე.
რა გადაიტანა და reward hacking-ის გაკვეთილი
მხოლოდ ნულ, ერთ და ორ მკვდარ ძრავზე გაწვრთნილმა პოლისმა რეალურ აპარატზე სამი და ოთხი ძრავის გაფუჭების შემთხვევაშიც შეინარჩუნა პოზიცია. ავტორი ღიად აღიარებს, რომ ადრინდელი ვერსია reward hacking-ის კლასიკური მაგალითი იყო: პოზაზე ორიენტირებული ჯილდოს პირობებში ოთხ ძრავზე ჰოვერი იმავე ქულას იღებდა, რაც რვაზე, ამიტომ აგენტი ჯანმრთელ ძრავებს აჩერებდა და კვადროკოპტერივით დაფრინავდა. ხელმისაწვდომი ძრავების გამოყენების ჯილდოს დამატებამ ჰოვერში რვავე ძრავა შეინარჩუნა 20-დან 20 ეპიზოდში, 3.6%-ით ნაკლები სიზუსტით, და უკეთ გადაიტანა სავარჯიშო გარემოს გარეთ არსებული ხარვეზები: 99% 90%-ის წინააღმდეგ სამ მკვდარ ძრავთან და 85% 64%-ის წინააღმდეგ ოთხთან.
ბაგები, რომელთა წაკითხვაც ღირს
ბილდ-ლოგი აღწერს სამ სისტემურ ბაგს, რომლებმაც ყველა ადრინდელი მდგრადობის რიცხვი არასწორი გახადა: მასის ცენტრიდან ძრავამდე მანძილი კოდში 35.20 მმ იყო ნამდვილი 181.938 მმ-ის ნაცვლად; ინერციის ფორმულაში 4π²-ის ნაცვლად 8π² გამოიყენებოდა; ძრავების განლაგება კი „+“ კონფიგურაციად იყო მოდელირებული, მაშინ როცა რეალური აპარატი „X“-ია. ერთად ამან სიმულირებულ დრონს ~2.6-ჯერ ნაკლები მართვის ავტორიტეტი დაუტოვა. გასწორების შემდეგ ორი ძრავის გაფუჭების გადატანა სრული domain randomization-ის პირობებში 71.7%-დან 95.8%-მდე გაიზარდა, yaw-ით აუნაზღაურებადი წყვილების კი 41.2%-დან 94.6%-მდე.
ოქტოკოპტერი შეგნებულად აირჩია: კვადროკოპტერს ძრავის დაკარგვისას yaw-ის მართვა მთლიანად უნდა დათმოს.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.