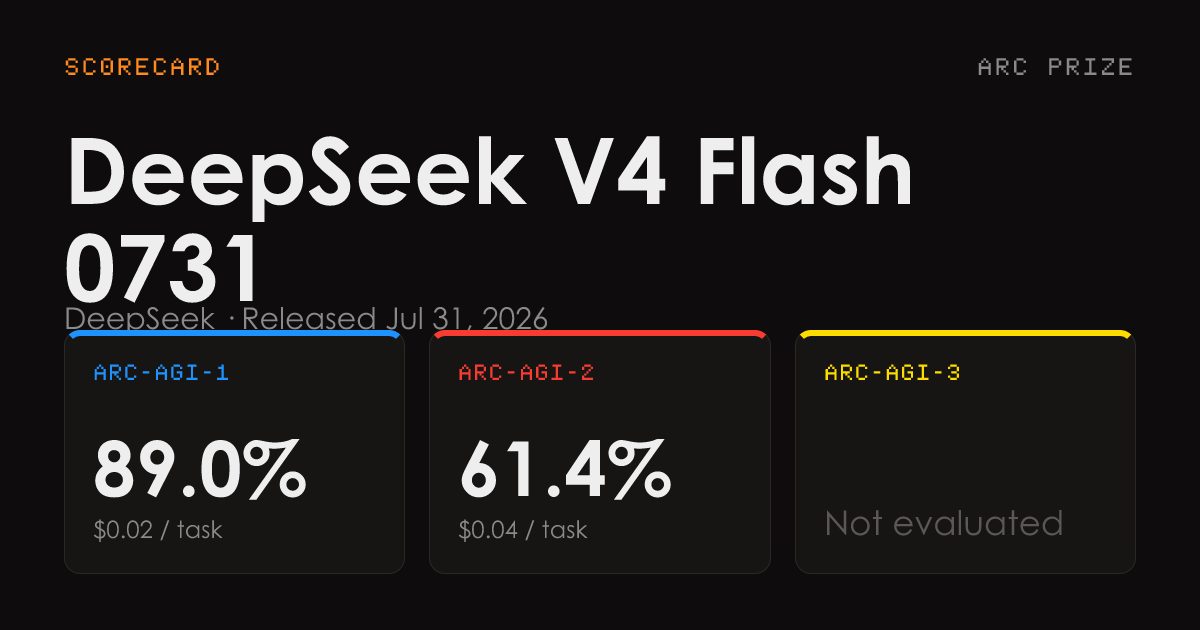
DeepSeek V4 Flash 0731 ARC-AGI-1-ზე 89%-ს, ARC-AGI-2-ზე კი 61.4%-ს აღწევს
ARC Prize-მა DeepSeek V4 Flash 0731-ის ვერიფიცირებული შედეგები გამოაქვეყნა: მსჯელობის მაქსიმალურ დონეზე მოდელი ARC-AGI-1-ის Semi-Private ნაკრებზე 89.0%-ს, უფრო რთულ ARC-AGI-2-ზე 61.4%-ს აღწევს — თითო ამოცანაზე 0.02–0.04 დოლარით.
ოთხი რეჟიმის ვერიფიცირებული შედეგები
ARC Prize-მა გამოაქვეყნა DeepSeek V4 Flash 0731-ის ვერიფიცირებული შედეგები — მოდელი, რომელიც DeepSeek-მა 2026 წლის 31 ივლისს გამოუშვა. მსჯელობის მაქსიმალურ დონეზე ის ARC-AGI-1-ის Semi-Private ნაკრებზე 89.0%-ს აღწევს, ARC-AGI-2-ის Semi-Private ნაკრებზე კი 61.4%-ს; თითო ამოცანის ღირებულება შესაბამისად 0.02 და 0.04 დოლარია.
ქულები იმაზეა დამოკიდებული, თუ რამდენი მსჯელობის რესურსი ეძლევა მოდელს. "High" რეჟიმში ის ARC-AGI-1-ზე 87.0%-ს აღწევს, ARC-AGI-2-ზე — 56.0%-ს; "Low" რეჟიმში — 84.0%-სა და 46.0%-ს. მსჯელობის სრულად გამორთვისას შედეგები 11.8%-მდე და 2.1%-მდე ეცემა.
ცალკეულ ამოცანებზე დაშლილი შედეგები
შედეგების გვერდზე ARC-AGI-2-ის საჯარო შეფასება (Public Eval) ცალკეულ ამოცანებამდეა დაშლილი: 120 დავალების შესრულების ან ჩავარდნის ნიშნები ოთხივე ვარიანტისთვის. სურათი არათანაბარია — ნაწილი ამოცანისა მხოლოდ მაქსიმალური ძალისხმევით წყდება, ნაწილი კი არცერთ რეჟიმში. ARC-AGI-3-ის შედეგები მოდელისთვის მითითებული არ არის.
რატომ აქვს მნიშვნელობა ამ განსხვავებას
ARC-AGI ის ბენჩმარკია, რომელიც ტრენინგის მონაცემების გახსენების ნაცვლად ახალ, უცნობ ამოცანებზე აბსტრაქტული მსჯელობის უნარს ზომავს; ბენჩმარკის მეორე გამოცემა მიზანმიმართულად უფრო რთულია, ვიდრე პირველი. სხვაობა "None"-სა და "Max" რიგებს შორის — 2.1% 61.4%-ის წინააღმდეგ ARC-AGI-2-ზე — პირდაპირ აჩვენებს, შედეგის რა ნაწილი მოდის დასკვნის დროს მსჯელობაზე და არა მოდელის საბაზისო შესაძლებლობებზე. მნიშვნელოვანია ღირებულებაც: ARC-AGI-2-ის თითო ამოცანაზე 0.04 დოლარი ძლიერ შედეგს ჩვეულებრივი ექსპერიმენტების ბიუჯეტის ფარგლებში აქცევს.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.