NVIDIA-ს კონფიდენციალური გამოთვლები Blackwell-ზე AI ინფერენსის 96%-ს ინარჩუნებს
NVIDIA-ს ტექნიკური ბლოგის მიხედვით, TensorRT LLM კონფიდენციალური გამოთვლების ჩართვისას გამტარუნარიანობის 96.1-98.2%-ს ინარჩუნებს რვა Blackwell B200 GPU-ზე. კომპანია ხსნის, რომელი ვარაუდები შეიცვალა დაშიფრული გაშვებისას.
NVIDIA-მ გამოაქვეყნა ტექნიკური ანალიზი იმაზე, თუ როგორ მოქმედებს კონფიდენციალური გამოთვლები (Confidential Computing) დიდი ენობრივი მოდელების ინფერენსზე და როგორ ადაპტირდა TensorRT LLM ფრეიმვორკი, რომ Blackwell GPU-ებზე დაშიფრული გაშვება სიჩქარის უმეტეს ნაწილს ინარჩუნებდეს.
დაშიფრული მეხსიერება ცვლის ვარაუდებს
კონფიდენციალური გამოთვლები დატვირთვას მეხსიერებადაშიფრულ ვირტუალურ მანქანებში, კონფიდენციალურ GPU-ებსა და დაშიფრულ NVLink-ზე ამუშავებს. უსაფრთხო გაშვება კი ცვლის runtime-ის ვარაუდებს მეხსიერების გადაადგილებაზე, დროის აღრიცხვაზე, დაგეგმვასა და მრავალ GPU-ს კომუნიკაციაზე — და ეს წარმადობას აკლებს, თუ ფრეიმვორკი არ ადაპტირდება.
ზედნადების გამოსავლენად გუნდმა აირჩია გრძელი შემავალი კონტექსტი, ხანგრძლივი გენერაცია და დაბალი პარალელურობა: DeepSeek-R1-0528-NVFP4 TensorRT LLM-ის PyTorch backend-ზე, 32K შემავალი და 1K გამომავალი ტოკენი, 1-დან 16-მდე პარალელური მოთხოვნა, TP=8 და FP8 KV cache.
გამტარუნარიანობის 96% შენარჩუნებულია
იცვლებოდა მხოლოდ CC-ის მდგომარეობა: მოდელი, ტექნიკა, პროგრამული ვერსიები, მიმდევრობის სიგრძე, პარალელურობა და დატვირთვის დონე უცვლელი დარჩა. სტენდი: ერთი NVIDIA DGX B200 რვა B200 GPU-ით, Intel TDX, CUDA 13.2, NCCL 2.30 და TensorRT LLM 1.3.0rc22.
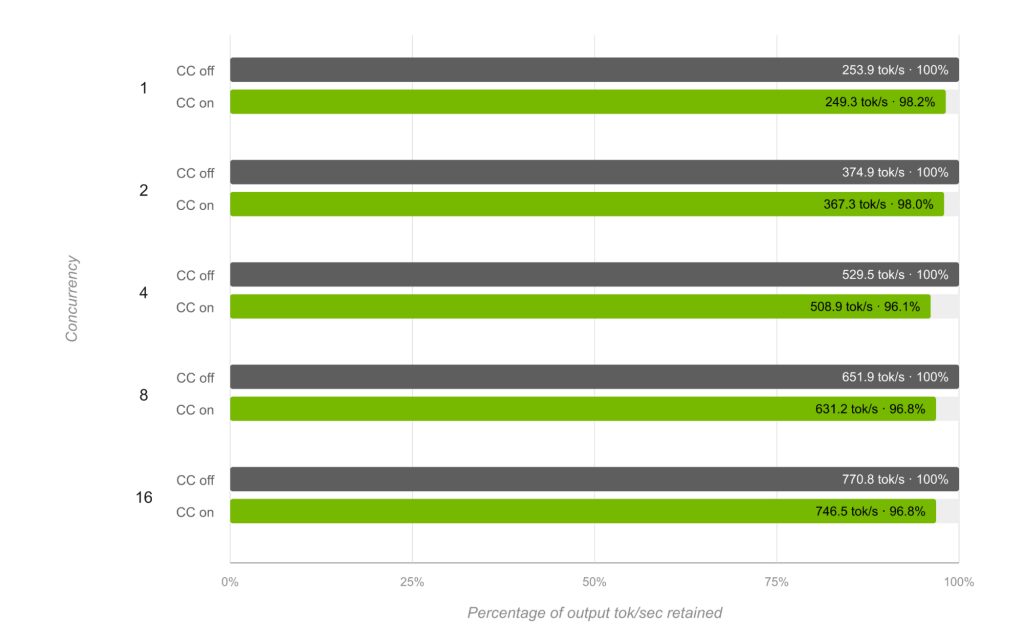
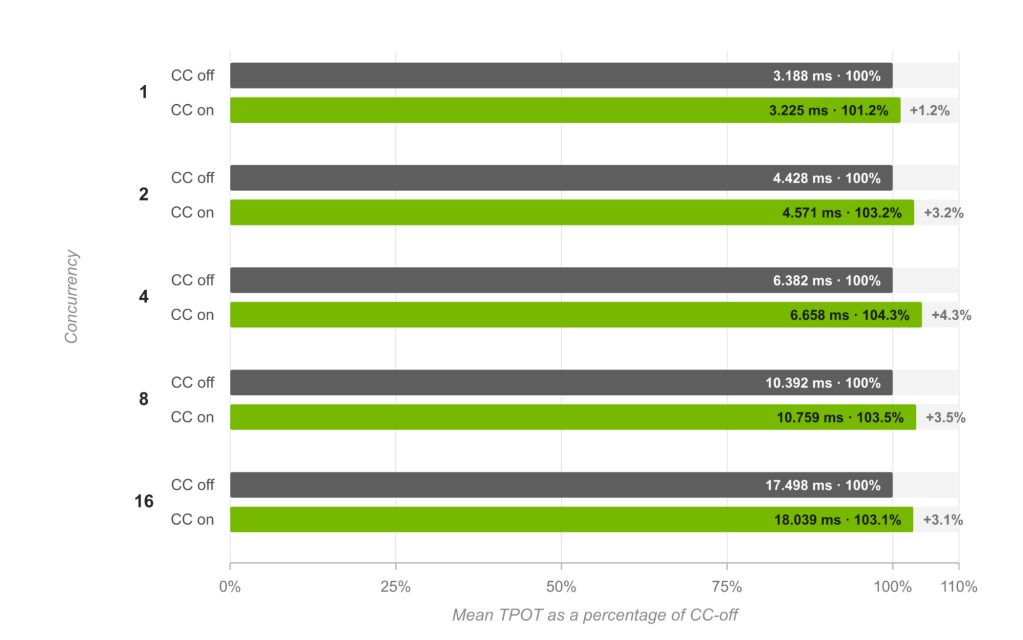
1-დან 16-მდე პარალელურობაზე ჩართული CC-ით შენარჩუნდა გამომავალი ტოკენების გამტარუნარიანობის 96.1-98.2%, ერთ გამომავალ ტოკენზე საშუალო დრო კი ბაზისურიდან 1.2%-4.3%-ის ფარგლებში დარჩა.
სამი ადგილი, სადაც ფრეიმვორკი შეიცვალა
Host-to-device გადაცემები პროგრამული დაშიფვრის bounce buffer-ს გადის, რადგან GPU დაცულ CVM მეხსიერებას პირდაპირ ვერ წვდება. ამიტომ pinned memory ასინქრონულ უპირატესობას კარგავს და ზოგიერთი კოპირება thread-ს აბლოკირებს; TensorRT LLM მეხსიერების ტიპს CC-ის გათვალისწინებით ირჩევს და ტოკენების წაკითხვას ასინქრონულ worker-ზე გადააქვს (PR #11573).
Kernel ავტოტიუნერი tactics-ს CUDA events-ით ადარებს, მაგრამ CC-ის ქვეშ დროის სიგნალი არასტაბილური აღმოჩნდა; ახლა ის GPU-ს %globaltimer-ს იყენებს (PR #11657). NVLink SHARP multicast B200-ის CC კონფიგურაციებში არ არის, ამიტომ ფრეიმვორკებმა NVLS-ის ხელმისაწვდომობა უნდა შეამოწმონ და შესაბამისი ალგორითმი აირჩიონ.
გაზომეთ საკუთარი დატვირთვა
NVIDIA-ს რჩევაა, უსაფრთხოების კონფიგურაცია და ინფერენსის ოპტიმიზაცია ერთ ამოცანად განიხილოთ: ჩართეთ კონფიდენციალური გამოთვლები, გაიარეთ გარემოს ატესტაცია და გაზომეთ ზუსტად ის დატვირთვა, რომლის მომსახურებასაც აპირებთ.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.