ვინ იცის ქართული სინამდვილეში? 22 AI მოდელის დიდი ტესტი
ჩვენ 22 წამყვანი ხელოვნური ინტელექტის მოდელი ქართულ ენაზე შევამოწმეთ: მორფოლოგია, ერგატიული კონსტრუქციები, იდიომები და ლიტერატურული სტილი. მოდელების 90% ერგატივზე ცდება — გამარჯვებული DeepSeek V4.1 Flash-ია (92/100).
„გიორგი მივიდა" თუ „გიორგიმ მივიდა"? ქართველისთვის პასუხი ცხადია — სწორია პირველი, რადგან ზმნა „მივიდა" გარდაუვალია და წყვეტილ დროში ქვემდებარეს სახელობით ბრუნვას მოითხოვს. თუმცა, როდესაც ეს კითხვა 22 წამყვან ხელოვნური ინტელექტის მოდელს დავუსვით, მათმა უმრავლესობამ — დაახლოებით 90%-მა — სწორედ აქ დაუშვა შეცდომა.
ჩავატარეთ ქართული ენის ერთ-ერთი ყველაზე მასშტაბური AI ბენჩმარკი: 22 მოდელი, ოთხი დისციპლინა და 100-ბალიანი სისტემა. შედეგები აჩვენებს, რომ ქართული ჯერ კიდევ სერიოზული გამოცდაა თანამედროვე ტექნოლოგიისთვის — მაგრამ არსებობს მოდელები, რომლებიც მას ნამდვილად ფლობენ.
რატომ არის ქართული AI-სთვის განსაკუთრებული გამოცდა
მოდელების უმრავლესობა ინგლისურ და ჩინურ მონაცემებზე იწვრთნება, ქართული კი დაბალრესურსულ ენათა რიცხვს მიეკუთვნება. ქართველური ენათა ოჯახი იზოლირებულია, გრამატიკა კი ისეთ მახასიათებლებს შეიცავს, რომლებზეც უნივერსალური მოდელები ხშირად მარცხდებიან.
პირველი — აგლუტინაცია და ზმნის მრავალპირიანობა: ქართული ზმნა ერთდროულად გამოხატავს სუბიექტსაც და ობიექტსაც („დაგვახვედრეს", „გამომიგზავნეს"). მეორე — გახლეჩილი ერგატიულობა: წყვეტილ დროში გარდამავალი ზმნის ქვემდებარე მოთხრობით ბრუნვას იღებს (-მა), გარდაუვალისა კი სახელობითს (-ი). მესამე — უცხოენოვანი კალკები („იქნა მიღებული", „ჩემს მიერ"), რომლებითაც ინტერნეტის ქართული ტექსტების დიდი ნაწილია სავსე და რომლებსაც მოდელები „სწორ" ფორმებად სწავლობენ.
ტესტი: ოთხი დისციპლინა
თითოეული მოდელი შეფასდა ოთხ სფეროში, ერთიანი API-ის, იდენტური პრომპტებისა და მინიმალური ტემპერატურის პირობებში:
1. მორფოლოგია და ერგატიული კონსტრუქციები (25 ქულა). სამი წინადადება ბრუნვების ჩასმით — მათ შორის „გუშინ ______ (გიორგი) სკოლაში დროზე მივიდა". სწორია „გიორგი", რადგან ზმნა გარდაუვალია.
2. შეცდომების პოვნა და რედაქტირება (35 ქულა). ხუთი დამალული ხარვეზის ტექსტი: რუსული პასიური კალკი „იქნა მიღებული", ლექსიკური შეცდომა „რამოდენიმე", ტავტოლოგია „ყველაზე საუკეთესო", რიცხვითი შეთანხმება „ათი სტუდენტები" და გამოტოვებული მძიმე.
3. იდიომები და ფრაზეოლოგიზმები (20 ქულა). „კოვზი ნაცარში ჩაუვარდა", „წყალი შეუყენა", „თვალში ნაცრის შეყრა" — გადატანითი მნიშვნელობის გააზრება და კონტექსტური მაგალითები.
4. ლიტერატურული სტილი (20 ქულა). თავისუფალი თხრობა თემაზე „ენა, როგორც ერის მეხსიერება" — კალკების გარეშე, მაღალი სტილით.
დრამა: როგორ „გაიჭედნენ" მოდელები ფიქრში
ტესტირების პირველ რაუნდში 22-დან 14-მა მოდელმა ცარიელი პასუხი დააბრუნა — მიუხედავად იმისა, რომ სტატუსი 200 OK იყო. მიზეზი შიდა მსჯელობის ჯაჭვი აღმოჩნდა: ინგლისურად მარტივ ამოცანას 100-200 „ფიქრის" ტოკენი სჭირდება, ქართულად კი მოდელებს ეს მაჩვენებელი 1,200-2,400 ტოკენამდე აუფეთქდათ. 1,000-ტოკენიანი ბიუჯეტით მთელი ლიმიტი მხოლოდ ფიქრში დახარჯეს და პასუხამდე ვერ მივიდნენ.
2,500-ტოკენიანი ლიმიტით სურათი შეიცვალა: DeepSeek V4.1 Flash-მა ფიქრში 1,242 ტოკენი დახარჯა და შემდეგ უნაკლო ქართული პასუხი დაწერა; Qwen3.8-Max-ს 1,443 ტოკენი დასჭირდა. განსაკუთრებული შემთხვევაა GLM-5.3-flash, რომელიც უსასრულო მსჯელობის მარყუჟში ჩავარდა — 2,494 ტოკენი დახარჯა და პასუხამდე მაინც არ მივიდა.
გამარჯვებულები
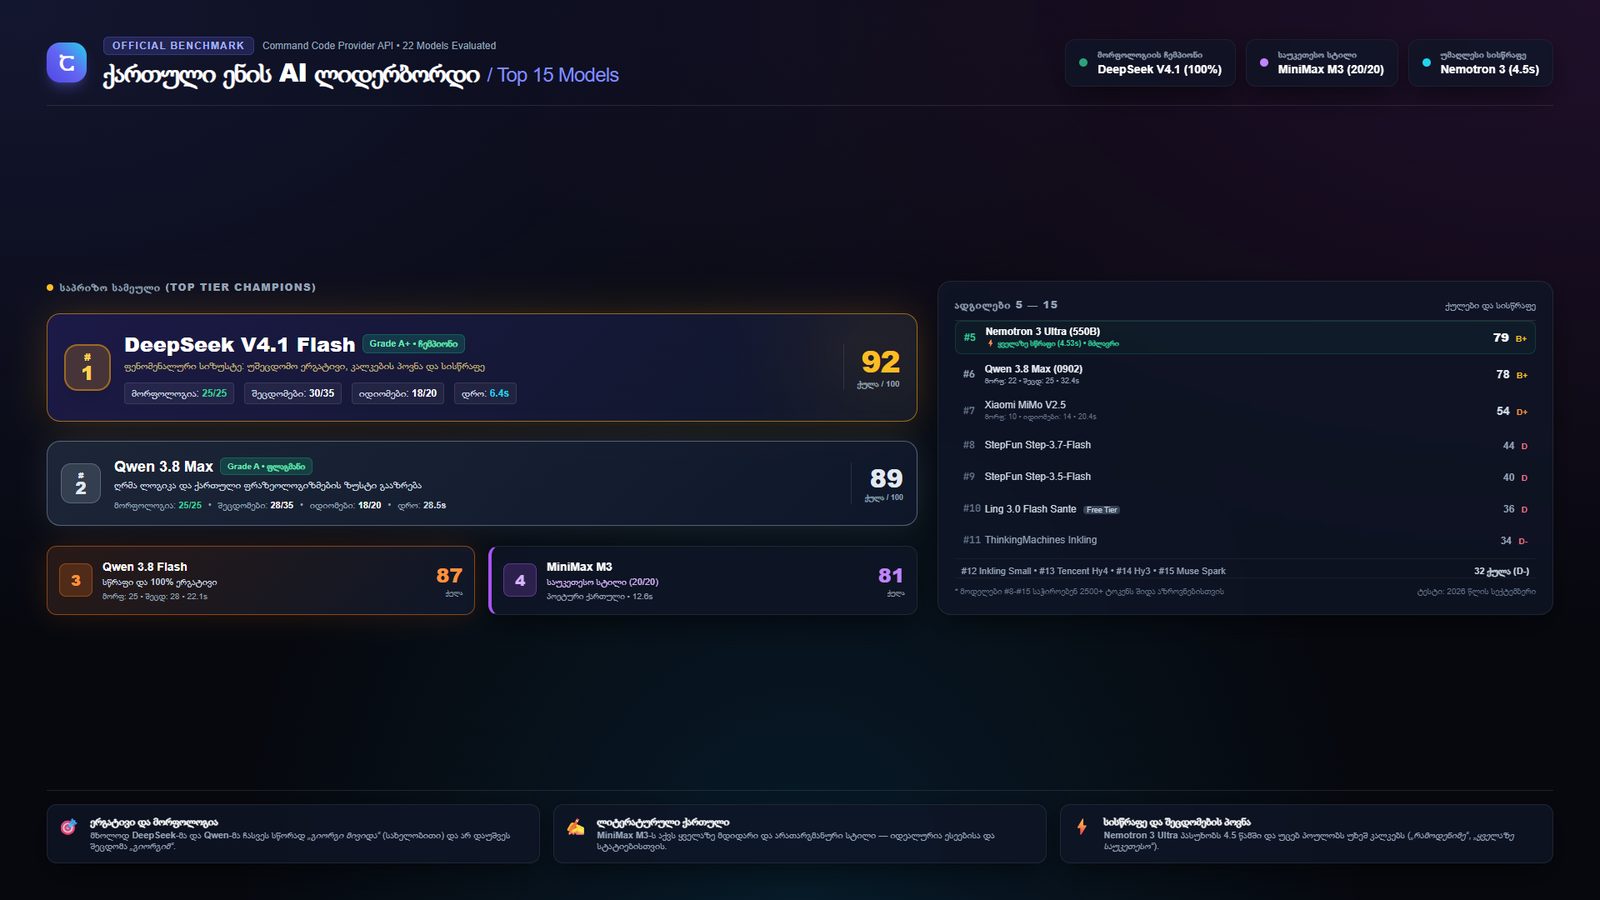
საუკეთესო შედეგი — 92/100 — აჩვენა DeepSeek V4.1 Flash-მა: ერგატივის ტესტში 100% სიზუსტე, უშეცდომო რედაქტირება (იპოვა ყველა ხარვეზი, რუსული კალკის ჩათვლით) და საშუალოდ მხოლოდ 6.4 წამი პასუხზე. მეორე ადგილზეა Qwen3.8-Max (89/100) — ყველაზე ძლიერი ლოგიკური აზროვნებით, თუმცა 28.5-წამიანი დაყოვნებით; მესამე — Qwen3.8-Flash (87/100).
საინტერესოა MiniMax-M3: საერთო ქულით მეოთხე (81/100), მაგრამ ლიტერატურულ ტესტში აბსოლუტური შედეგი — 20/20. მის მიერ დაწერილი ტექსტი ისეთი ბუნებრივია, რომ ადამიანის ნაწერს ძნელად გაარჩევ: „ენა ხომ მხოლოდ სიტყვათა ფორმად კი არ იბადება, არამედ საუკუნოდ დაგროვილი ცხოვრებისეული გამოცდილების, ტკივილისა და სიხარულის სულიერ ნაკვალევად იქცევა".
ყველაზე სწრაფი კი NVIDIA Nemotron-3-Ultra-550B აღმოჩნდა — 4.5 წამი — თუმცა მის ტექსტში რუსული კირილიცური სიტყვა („генеτიკური") შეიპარა, რაც მრავალენოვანი წვრთნის დროს ენების „გაჟონვის" კლასიკური ნიმუშია; მანვე წესის ახსნისას მოიგონა არარსებული გრამატიკული წესი.
სრული ლიდერბორდი (ტოპ-10)
1. DeepSeek V4.1 Flash — 92/100 (6.4 წმ)
2. Qwen3.8-Max — 89/100 (28.5 წმ)
3. Qwen3.8-Flash — 87/100 (22.1 წმ)
4. MiniMax-M3 — 81/100 (12.6 წმ)
5. NVIDIA Nemotron-3-Ultra-550B — 79/100 (4.5 წმ)
6. Qwen3.8-Max-0902 — 78/100
7. Xiaomi MiMo v2.5 — 54/100
8. StepFun Step-3.7-Flash — 44/100
9. StepFun Step-3.5-Flash — 40/100
10. Ling 3.0 Flash — 36/100
საერთო სურათი მკაფიოა: ხუთეულსა და დანარჩენებს შორის უფსკრული უზარმაზარია — 79 ქულიდან 54-ზე ვარდნა. სამი მოდელი ტესტირებამდე ვერ მივიდა (ორი პაკეტის შეზღუდვის გამო, ერთი კი დროებით მიუწვდომელი იყო).
რომელი მოდელი რისთვის
ყოველდღიური მუშაობისთვის — ტექსტების წერა, რედაქტირება, კითხვა-პასუხი — საუკეთესო არჩევანი DeepSeek V4.1 Flash-ია: სისწრაფის, ფასისა და ხარისხის საუკეთესო შეფარდება. რთული ანალიზისა და იურიდიული ტექსტებისთვის უფრო ღრმაა Qwen3.8-Max, მარკეტინგული და შემოქმედებითი მასალისთვის კი — MiniMax-M3, რომლის ქართულიც ყველაზე „ცოცხალია".
მთავარი დასკვნა მარტივია: ქართული ენისთვის მოდელი უნდა შეირჩეს არა ბრენდის ან ზომის, არამედ რეალური ტესტირების მიხედვით. სწორედ ამიტომ გამოვაქვეყნეთ სრული შედეგები და მეთოდოლოგია — რომ ყველას, ვინც ქართულ ტექსტებზე მუშაობს, მზა პასუხი ჰქონდეს.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.