Laya: ღია გადაწყვეტილების ძრავი, რომელიც ერთი წლით ადრე შეიქმნა
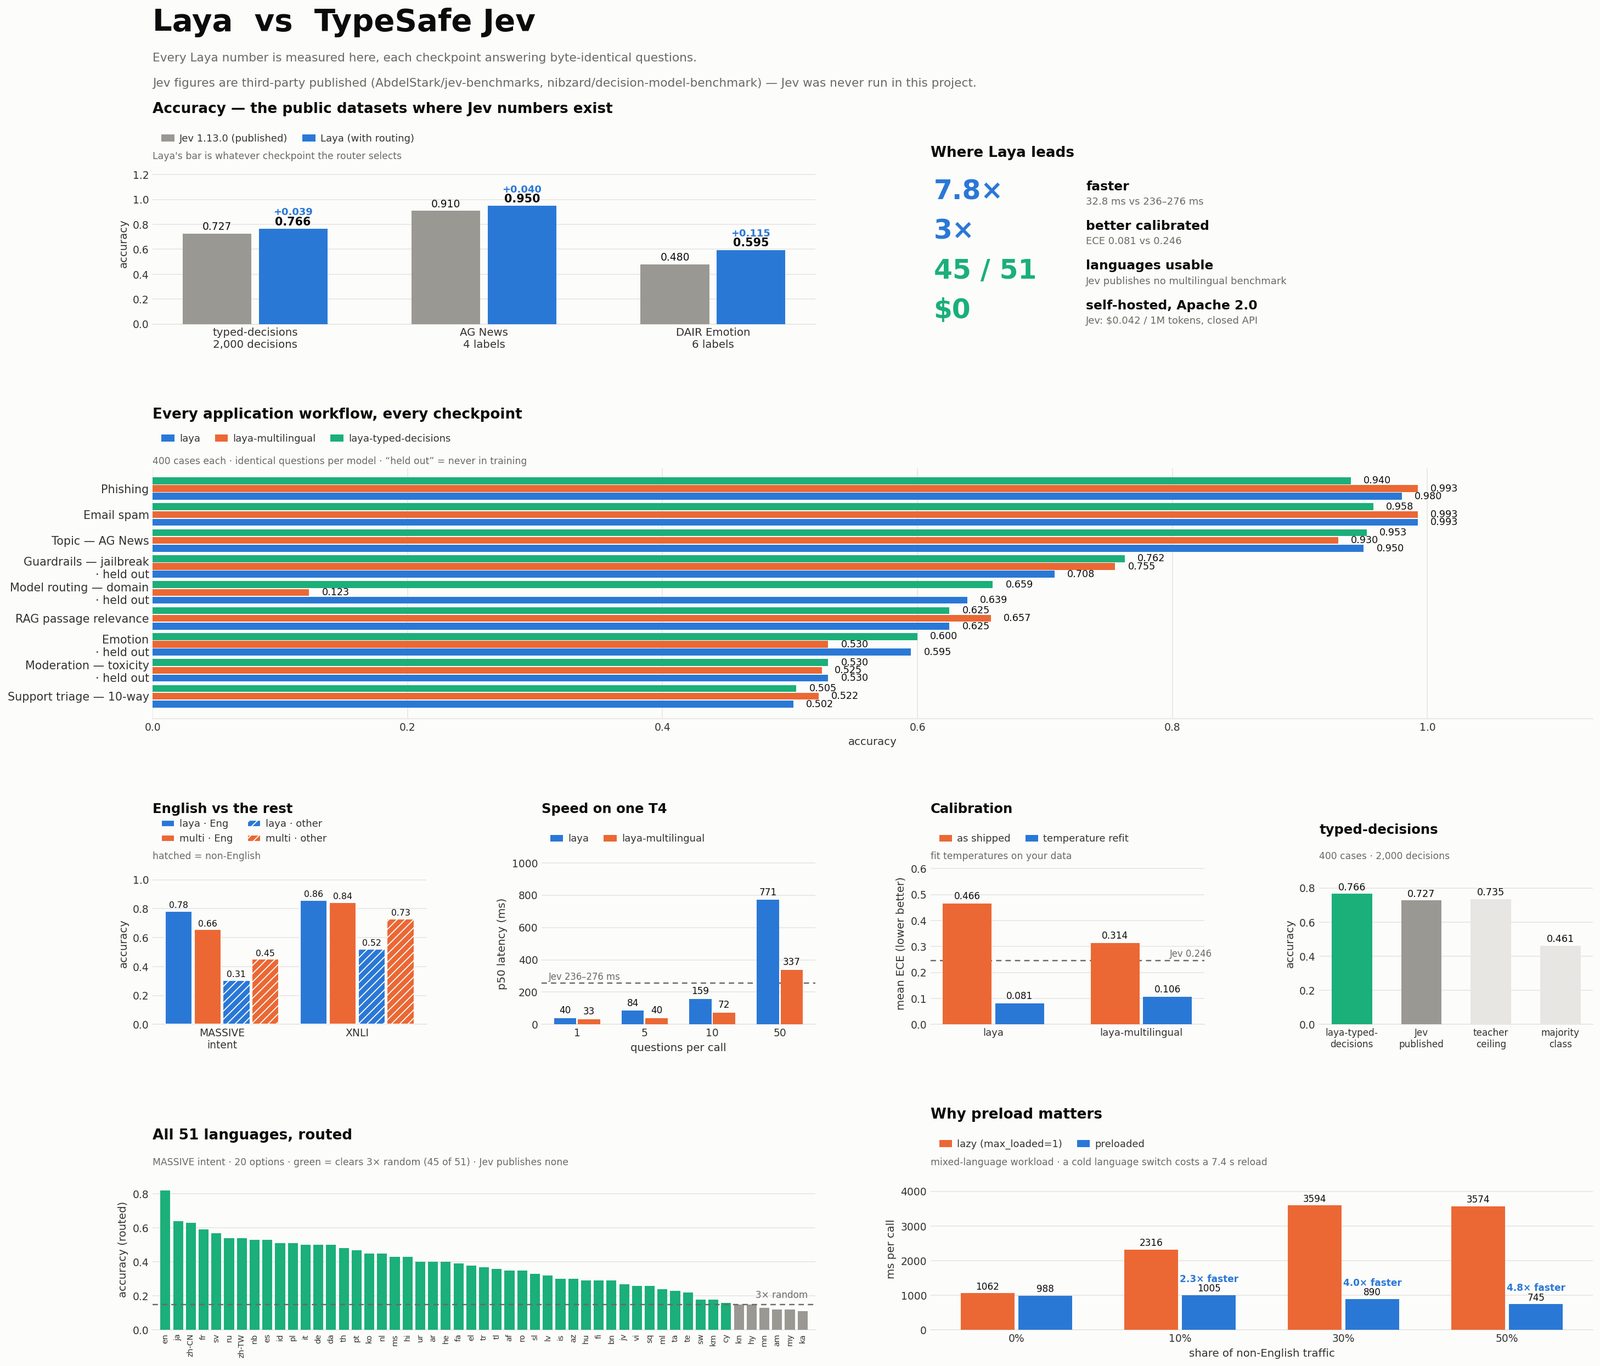
მას შემდეგ, რაც კარგად დაფინანსებულმა ლაბორატორიამ მსგავსი მოდელი გარღვევად წარმოადგინა, ინჟინერმა გამოუშვა Laya — ღია წონების System 1 გადაწყვეტილების ძრავი, რომელიც 32,8 მმწ-ში კალიბრირებულ ალბათობებს აბრუნებს.
ინჟინერმა, რომელმაც არაავტორეგრესიული გადაწყვეტილების მოდელები ერთი წლით ადრე გამოაქვეყნა, სრულად ღია ალტერნატივა გამოუშვა მას შემდეგ, რაც კარგად დაფინანსებულმა ლაბორატორიამ მსგავსი არქიტექტურა ახალ სამეცნიერო გარღვევად წარმოადგინა.
ერთი წლის წინანდელი იდეა ახალად
ნანდაკიშორ მუკუნოტი, ConvAI Innovations-ის დამფუძნებელი და CEO, წერს, რომ მიდგომა 2025 წლის მარტში ააგო: arXiv-ის სტატია მიმდევრობითი კონვერსიის ტრაექტორიებზე, მოდელის წონები და ღია მონაცემთა ნაკრები Hugging Face-ზე. 2026 წლის სექტემბერში TypeSafe AI-მ — რომელიც ChatGPT-ის თანაავტორმა დიოგო ალმეიდამ დააარსა — გამოუშვა Jev, რასაც ავტორი იმავე არაავტორეგრესიული გადაწყვეტილების კონცეფციად აღწერს, თუმცა ტექნიკური სტატიების, ღია წონებისა და ღია სასწავლო მონაცემების გარეშე. Jev პარალელურად იღებს ნიმუშებს RLCD-ის (Reinforcement Learning for Calibrated Decisions) საშუალებით და 1 მილიონ შემავალ ტოკენზე 0,042 დოლარს ითხოვს, პასუხის ტიპური დრო კი დაახლოებით 150 მილიწამია.
რა არის Laya
ნაცვლად იმისა, რომ გაბრაზებული დარჩენილიყო, მან იდეა თავიდან ააგო როგორც Laya — System 1 ტიპის გადაწყვეტილების ძრავი: ის ტექსტს არ აგენერირებს, მხოლოდ ალბათობის განაწილებებს აბრუნებს სტრუქტურირებულ სქემებზე. ის პასუხობს სამ პრიმიტივზე — choice, რომელიც ლექსიკონიდან ერთ გასაღებს ირჩევს და სრულ განაწილებასა და კალიბრირებულ სარწმუნოებას აბრუნებს; score, რომელიც დოკუმენტს რიგით სკალაზე ათავსებს; და noul — ბულის კითხვა P(true)-ით. რადგან გამომავალი სივრცე მხოლოდ რიცხვებია, მოდელი ვერ ჰალუცინირებს და არასწორი JSON შეუძლებელია, ამტკიცებს ავტორი. ორმხრივი ენკოდერებით ის ერთ GPU-ზე 32,8 მილიწამში პასუხობს, პარტიულ რეჟიმში კი 7,2 მილიწამში ერთ კითხვაზე — ავტორის თქმით, Jev-ზე ექვსიდან რვა ჯერ სწრაფად, Apache 2.0 ლიცენზიით და API-ის ხარჯის გარეშე.
სამი ჩეკპოინტი და როუტერი
ოჯახი ერთ Hugging Face რეპოზიტორიაში სამ ჩეკპოინტს აერთიანებს: laya (ModernBERT-large, 421 მლნ პარამეტრი, 512 ტოკენის კონტექსტი) ინგლისური კლასიფიკაციისთვის; laya-multilingual (mmBERT-base, 256 ათასი ტოკენის ლექსიკონი, 322 მლნ პარამეტრი) 100-ზე მეტი ენისთვის; და laya-typed-decisions აგენტური სცენარებისთვის 0,766 სიზუსტით. MASSIVE ბენჩმარკზე 51 ენის შემოწმებამ აჩვენა, რომ ინგლისურენოვანი მოდელები ლათინური დამწერლობის გარეთ იშლება: ქმერულზე მოდელმა 0,000 სიზუსტე აჩვენა 0,952 საშუალო სარწმუნოებით. სარწმუნოება არასოდეს ჩამოვიდა 0,885-ზე დაბლა, მიუხედავად იმისა, სიზუსტე 82% იყო თუ ნული — ამიტომ მხოლოდ სარწმუნოებაზე დაყრდნობა ვერ დაგვიცავს და მარშრუტიზაცია კადრს წინ უნდა მოხდეს. Laya-ს როუტერი 22 ანბანის Unicode დამწერლობას ამოწმებს: ინგლისურისთვის 0,09 მმწ, ინდური დამწერლობისთვის 0,54 მმწ, დიდი ჩადგმული JSON-ისთვის 0,73 მმწ.
ბენჩმარკები და გულახდილი შეზღუდვები
საერთო ბენჩმარკებზე როუტირებული სისტემა AG News-ზე 0,950-ს აჩვენებს Jev-ის 0,910-ის წინააღმდეგ, DAIR Emotion-ზე 0,595-ს 0,480-ის წინააღმდეგ, კალიბრაციის მოსალოდნელი შეცდომა 0,081-ია 0,246-ის წინააღმდეგ; მედიანური დაყოვნება 32,8 მმწ შედარებით 236–276 მმწ-თან. გვერდი შეზღუდვებსაც ჩამოთვლის: Banking77-ზე 77 ლეიბლით Laya-მ 0,425 აიღო Jev-ის 0,870-ის წინააღმდეგ; საბაზისო მოდელები დახვეწამდე დაახლოებით 0,35-ს აჩვენებენ; ხოლო კითხვის ტიპზე ერთი ტემპერატურის სკალარის მორგება კალიბრაციის შეცდომას 0,466-დან 0,081-მდე ამცირებს.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.