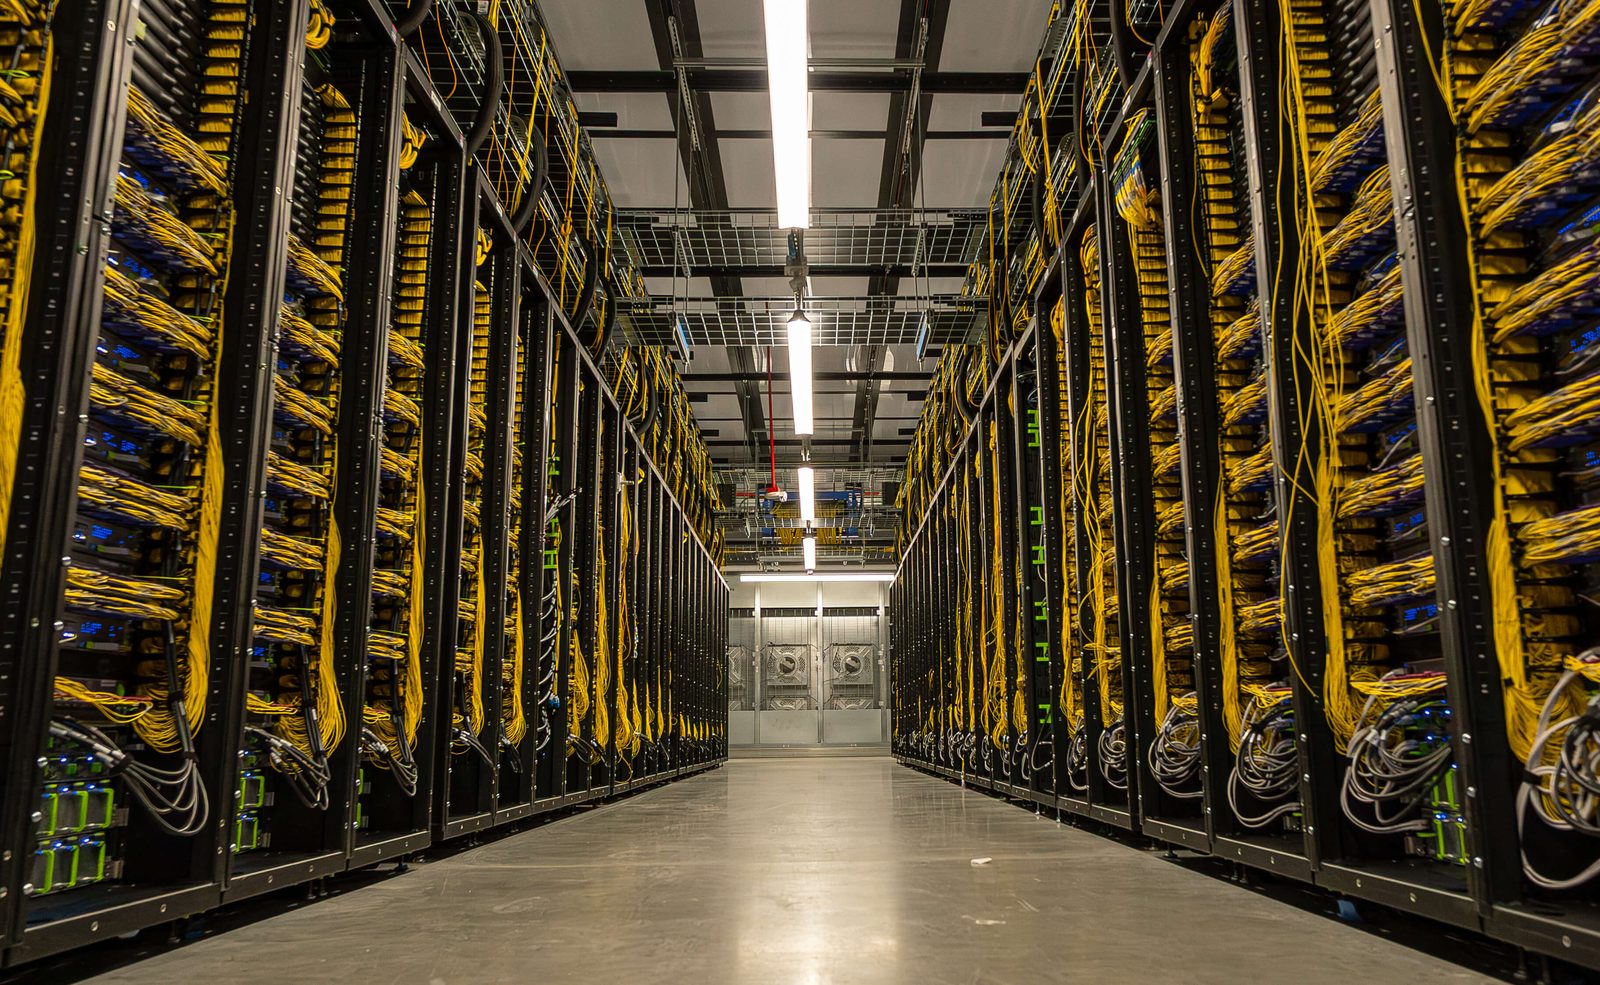
Prometheus-ის შიგნით: Meta-ს გიგავატიანი AI სუპერკლასტერი ნიუ-ოლბანიში
Meta-ს Prometheus სუპერკლასტერმა ნიუ-ოლბანიში (ოჰაიო) პირველი ეტაპი დაასრულა: Muse-ის ოჯახის საბაზისო მოდელები ასობით ათას GPU-ზე იწვრთნება, ხოლო სრული მასშტაბით სისტემა მილიონამდე GPU-ს მოიცავს.
Meta-მ ნიუ-ოლბანიში (ოჰაიო) მდებარე მონაცემთა ცენტრის ტერიტორიაზე თავისი გიგავატიანი მასშტაბის AI სუპერკლასტერის, Prometheus-ის, პირველი ეტაპი დაასრულა. ორი წლის წინ ეს ობიექტი ჩვეულებრივი ვებ-ტრაფიკის მონაცემთა ცენტრი იყო, ახლა კი მასში წამყვანი კლასის საბაზისო მოდელების, მათ შორის Muse-ის ოჯახის, წვრთნა მიმდინარეობს.
მილიონი GPU-ის მასშტაბი
Prometheus აერთიანებს ასობით ათას GPU-ს რამდენიმე ურთიერთდაკავშირებულ შენობაში, რომლებიც მილობით ოპტიკური ბოჭკოთია დაკავშირებული, რათა ერთიან სისტემად იმუშაონ. სრული მასშტაბით ის დაახლოებით მილიონ განაწილებულ GPU-ს მოიცავს. ამჟამად სისტემა NVIDIA-ს ორ პლატფორმაზე მუშაობს, ხოლო მესამე, Vera Rubin NVL72-ზე დაფუძნებული, მალე დაემატება. GB200 NVL72-ზე დაფუძნებული Catalina აღჭურვილია 72 GPU-ით, 13,4 ტბ HBM3e მეხსიერებითა და FP8 გამოთვლების 720 პიკური PFLOPS-ით, ხოლო GB300-ზე დაფუძნებული Clemente მეხსიერებას თითო GPU-ზე 288 გბ-მდე ზრდის და FP4 გამოთვლების პიკური სიმძლავრით ერთ exaFLOP-ს აღემატება.
ქსელი და საიმედოობა
სტანდარტული მონაცემთა ცენტრის ქსელის გარდა, არსებობს სპეციალური Ethernet Back-End ქსელი, რომელიც GPU-ებს შორის პირდაპირ კავშირს უზრუნველყოფს როგორც ერთი შენობის შიგნით, ისე სხვადასხვა შენობას შორის. შენობის დონეზე მოქმედი ქსელები 20 736-მდე GPU-ს აკავშირებს, ხოლო Backend Aggregation ქსელი 2 კმ-იდან 100 კმ-ზე მეტ მანძილს ფარავს და რეგიონულ დონეზე რამდენიმე Pbps გამტარობას იძლევა. Meta-ს ცნობით, pre-training-ის სესიებზე goodput-ის მაჩვენებელი 85%-ს აღემატება, reinforcement learning-ის დროს კი 90%-ს; firmware-ის გასწორებებმა შეფერხებებს შორის საშუალო დრო დაახლოებით 47 000-დან 54 000 GPU-საათზე მეტამდე გაზარდა.
სტაბილურობის ინჟინერია
2025 წლის შუაში შეფერხებების რაოდენობა პიკზე 8K GPU-ზე დღეში თითქმის 1000 შემთხვევას აღწევდა; ერთი წლის განმავლობაში სხვადასხვა ფუნქციური გუნდის ერთობლივმა მუშაობამ ეს მაჩვენებელი 99%-ით შეამცირა. მიზანმიმართულმა გასწორებებმა მოიცვა NVLink-ის სიგნალის მთლიანობა 600 000-ზე მეტ კავშირზე, HBM და LPDDR მეხსიერების ხარვეზები, switch-ების მდგომარეობა და backend ქსელის მოვლენები. NVL72-ის ყოველი 72-GPU-იანი დომენი მართავს 64-GPU-იან სლაისს, რვა სარეზერვო GPU-ით რეკის შიგნით, ხოლო ხარვეზების აღდგენა აერთიანებს პარალელიზმის გათვალისწინებულ ხარვეზებისადმი გამძლეობას და ასინქრონულ განაწილებულ checkpointing-ს. ენერგიის 30-40%-იან მოკლევადიან ნახტომებს აკონტროლებს Dynamo Dimmer-ის შემზღუდველი სისტემა, რომელსაც რეკის ბატარეები და ობიექტის ენერგოდაგროვებები უზრუნველყოფს, ხოლო ჰეტეროგენული პარკის გაგრილებას ჰაერით დამხმარე და ობიექტის თხევადი გაგრილების კომბინაცია ემსახურება.
წყაროები: Engineering at Meta
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.