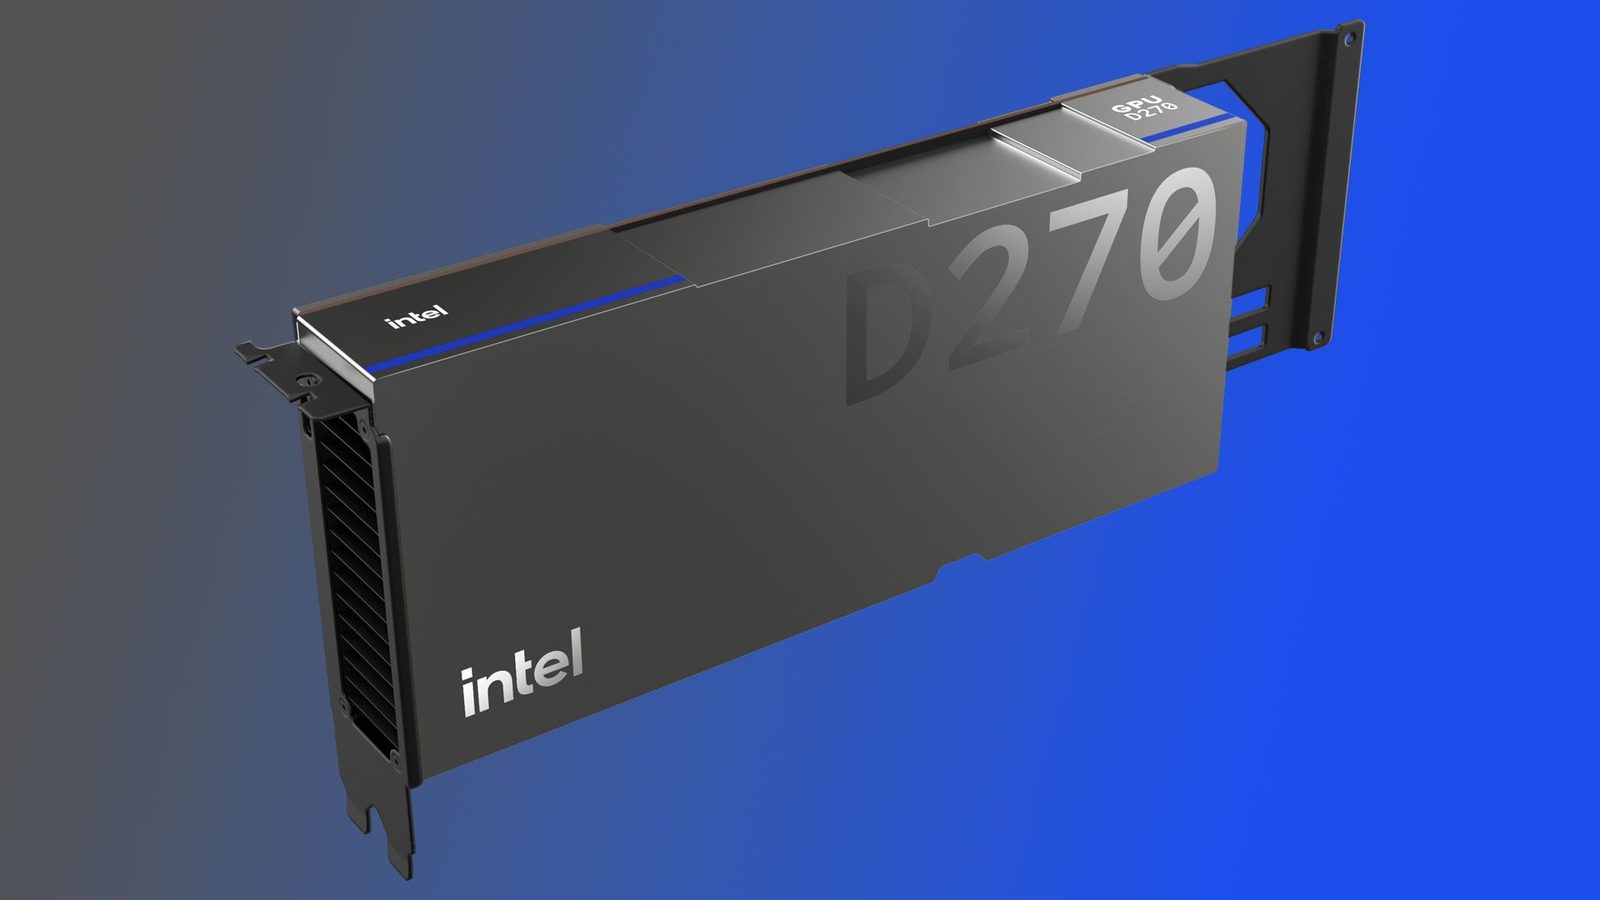
Intel-მა Crescent Island-ს ოფიციალურად GPU D-Series უწოდა, სამიზნე ჰაერით გაგრილებული AI ინფერენსია
OCP 2026-ზე Intel-მა Crescent Island აქსელერატორს Intel GPU D-Series უწოდა და გაამჟღავნა 1,3 PFLOPS პიკური FP8 გამოთვლები, 1,5 TB/s მეხსიერების გამტარობა, 350W ჰაერით გაგრილებული PCIe დიზაინი და 480GB-მდე LPDDR5X მეხსიერება.
Intel-მა Crescent Island-ს ოფიციალურად GPU D-Series უწოდა
დღეს OCP 2026-ზე Intel-მა თავის Crescent Island-ის AI აქსელერატორს ოფიციალური პროდუქტის სახელი მისცა: Intel GPU D-Series. განცხადებასთან ერთად კომპანიამ ასევე გაამჟღავნა ჩიპის თეორიული პიკური წარმადობის სამიზნე 1,3 PFLOPS FP8 გამოთვლებში და საბოლოო მეხსიერების გამტარობის მაჩვენებელი 1,5 TB/s ამ AI ინფერენსის აქსელერატორებისთვის.
გამჟღავნებული მონაცემები ემატება იმ ინფორმაციის თანდათანობით ნაკადს, რომელიც Intel-მა Crescent Island-ის შესახებ 2026 წლის განმავლობაში გამოაქვეყნა. Crescent Island არის პირველი ჩიპი, რომელიც Intel-ის Xe3P გრაფიკული არქიტექტურის საფუძველზეა აგებული. ეს არის მასიურად პარალელური გამოთვლითი დიზაინი, რომელსაც აკლია გრაფიკისთვის დამახასიათებელი ფუნქციური ბლოკების უმეტესი ან ყველა ნაწილი, რაც ნამდვილ GPU-ში გვხვდება.
ჰაერით გაგრილებული PCIe დიზაინი 480GB-მდე LPDDR5X მეხსიერებით
Intel გამოუშვებს GPU D-Series პროდუქტებს ჰაერით გაგრილებული PCIe ფორმ-ფაქტორით, 350W TDP-ით და 480GB-მდე LPDDR5X მეხსიერებით. ეს ჩიპებს საკმაოდ დაბლა აყენებს Nvidia-ს Rubin GPU-ებთან შედარებით: Nvidia-ს Vera Rubin NVL72 რაკის მასშტაბის სისტემაში 72 Rubin GPU-იდან თითოეული თეორიულად 17,5 PFLOPS FP8 გამტარუნარიანობას იძლევა, მაგრამ თითოეულ ჩიპს თხევადი გაგრილება სჭირდება და, სავარაუდოდ, კილოვატებში გაზომილი TGP აქვს.
იმის ნაცვლად, რომ ამ სეგმენტში კონკურენცია გაწიოს, Intel სამიზნედ ტრადიციულ ჰაერით გაგრილებულ რაკ-სერვერებს ირჩევს, რომლებიც რვა GPU-მდე მასშტაბირდება, Nvidia-ს HGX სისტემების მსგავსად. ასეთ კონფიგურაციაში, Intel-ის თქმით, GPU D-Series ჩიპებს შეუძლიათ უზრუნველყონ ინფერენსი მოდელებზე, რომლებიც ერთ ტრილიონზე მეტ პარამეტრს მოიცავს. კომპანიამ ასევე გამოკვეთა ჩიპის შესაბამისობა დიდი ენობრივი მოდელებისთვის, გრძელი კონტექსტის ინფერენსისთვის და ერთდროული ინფერენს სერვისებისთვის, რაც საფუძველს ქმნის მრავალმომხმარებლიანი AI სერვისებისთვის, რობოტიკისთვის და სხვა დაბალი ლატენტურობის მგრძნობიარე დატვირთვებისთვის.
პროგრამული სტეკი და ეკოსისტემა
განაწილებული ინფერენსის განლაგებისთვის, სადაც მრავალი GPU ერთიანად მოქმედებს, Intel-ს სჭირდება მყარი პროგრამული სტეკი. კომპანია მიუთითებს საერთო Xe პროგრამულ საფუძველზე, რომელიც მან უკვე ააგო AI-სთვის თავის Xe Cores-ებში ინტეგრირებულ და დისკრეტულ GPU პროდუქტებში. Xe აქსელერატორების მონაცემთა ცენტრში მოსაყვანად Intel აცხადებს, რომ მუშაობს ფართო ეკოსისტემასთან, მათ შორის OEM-ებთან, ODM-ებთან, ნეოკლაუდებთან, დამოუკიდებელ პროგრამული უზრუნველყოფის მწარმოებლებთან, აპლიანსების მომწოდებლებთან და AI-ნატიურ კომპანიებთან.
GPU D-Series პროდუქტების მომხმარებლის ნიმუშების აღება უკვე მიმდინარეობს, თუმცა Intel-მა ფართო გაშვების დეტალები არ მოგვცა. პროდუქტი წარმოადგენს Intel-ის მცდელობას, მოიპოვოს AI აქსელერატორის საფუძველი Data Center GPU Max ოჯახის, კოდური სახელით Ponte Vecchio, წარუმატებლობის, მისი გაყინული მემკვიდრეების და სილიციუმის იმ შესყიდვების შემდეგ, რომლებიც არასოდეს შეკრულან თანმიმდევრულ AI სტრატეგიად. გაურკვეველია, მოიპოვებს თუ არა GPU D-Series აღიარებას, მაგრამ დადასტურებული არქიტექტურული ფორმა, რომელიც პირდაპირ ინფერენსზეა მიმართული ხელმისაწვდომ თერმულ და ელექტრულ კონვერტში, შესაძლოა იყოს ის, რაც Intel-ს სჭირდება მოდელების განვითარების და აგენტური სამუშაო ნაკადების მნიშვნელობის ზრდის პირობებში.
წყაროები: Tom'S Hardware
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.