Apple-მა LensVLM-9B გამოაქვეყნა — მოდელი შეკუმშული სურათებით კითხულობს და მხოლოდ საჭირო გვერდებს აღადგენს
Apple-მა Hugging Face-ზე გამოაქვეყნა LensVLM-9B — 9 მილიარდი პარამეტრის მქონე ვიზუალურ-ენობრივი მოდელი, რომელიც დოკუმენტებს შეკუმშული გვერდების სურათებად კითხულობს და მხოლოდ საჭირო გვერდებს აღადგენს.
Apple-მა Hugging Face-ზე გამოაქვეყნა LensVLM-9B — 9 მილიარდი პარამეტრის მქონე ვიზუალურ-ენობრივი მოდელი, რომელიც დოკუმენტებს შეკუმშული გვერდების სურათებად კითხულობს და მხოლოდ საჭირო გვერდებს აღადგენს. მოდელის ბარათს თან ახლავს ოფიციალური კოდი და arXiv-ზე 7 მაისს გამოქვეყნებული სტატია.
როგორ მუშაობს
ვიზუალურ-ენობრივ მოდელებს ტექსტი გრძელ ტოკენთა მიმდევრობად დაყოფის ნაცვლად სურათადაც შეუძლიათ დაამუშაონ. ვინაიდან ენკოდერი ფიქსირებული ზომის სურათს ფიქსირებულ რაოდენობის ვიზუალურ ტოკენად აქცევს, რენდერის გარჩევადობა შეკუმშვის ზუსტ „ჩამრთველად“ მუშაობს. პრობლემა ისაა, რომ შეკუმშვის ზრდასთან ერთად სიზუსტე სწრაფად ეცემა — სიმბოლოები ენკოდერის ეფექტურ გარჩევადობაზე პატარა ხდება და მოდელი ვეღარ არჩევს.
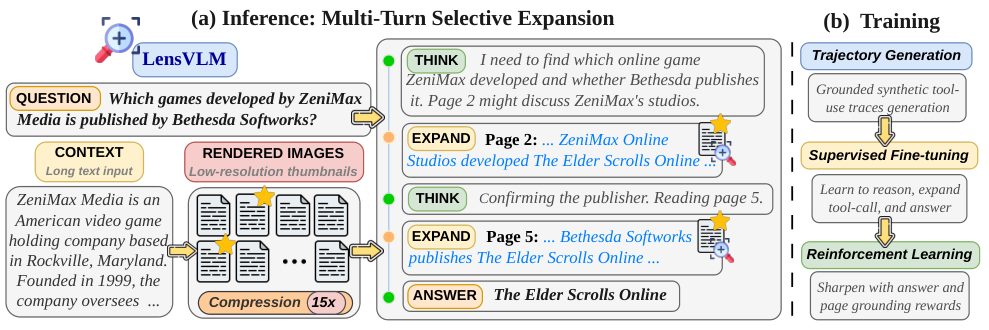
LensVLM სწორედ ამ შეზღუდვას გვერდს უვლის: მოდელი შეკუმშულ დოკუმენტს სკანირებს (5x, 10x და 15x რეჟიმები), შემდეგ კი ნასწავლი ხელსაწყოებით, მაგალითად read_page-ით, ნაბიჯ-ნაბიჯ მხოლოდ შესაბამის გვერდებს აღადგენს სრულ ფორმაში. Apple-მა მოდელი სამ ეტაპად გაწვრთნა: რთული მაგალითების გაფილტვრა, SFT-ისთვის ხელსაწყოთი სარგებლობის სინთეტიკური ჩანაწერები და გაძლიერებითი სწავლება (RL). LensVLM-9B Qwen3.5-9B-Base-ზეა აგებული.
შედეგები
სტატიის მიხედვით, 4,3x ეფექტური შეკუმშვისას LensVLM სიზუსტით სრული ტექსტის ზედა ზღვარს უტოლდება, შვიდ ტექსტურ QA ბენჩმარკზე კი retrieval-ზე დაფუძნებულ, ტექსტური და ვიზუალური შეკუმშვის ბაზისურ მიდგომებს 10,1x-მდე აღემატება. მოდელი მულტიმოდალურ დოკუმენტებსა და კოდის გაგებაზეც მუშაობს, შეკუმშვის ზრდასთან ერთად კი უპირატესობაც იზრდება.
ანალიზი მიზეზსაც ხსნის: გაწვრთნის შემდეგ ვიზუალური შეკუმშვა რენდერის პარამეტრების მიმართ მდგრადი ხდება, მაღალი შეკუმშვისას კი მოდელი უფრო მეტად აღდგენილ შიგთავსს ეყრდნობა და არა შემცირებული პიქსელების წაკითხვას. ავტორები პრაქტიკულ რჩევასაც აძლევენ: დარენდერებული ტექსტისთვის ტექსტის გაფართოება ჯობია, მშობლიური დოკუმენტებისთვის კი, სადაც განლაგებას მნიშვნელობა აქვს, მაღალი გარჩევადობის სურათი.
დემო და გამოშვება
დემო მოკლეა: მოდელი 15 შეკუმშულ გვერდს ასკანერებს, მე-10 გვერდს შესაბამისად ცნობს, read_page-ით კითხულობს და Shirley Temple-ს, Corliss Archer-სა და Chief of Protocol-ს ორ ნაბიჯში აკავშირებს. რეპოზიტორიაში ასევე შედის HotpotQA-ს, NQ-ისა და Musique-ისთვის მონაცემთა მომზადება და შეფასების კოდი.
მოდელის წონები Apple Machine Learning Research Model License-ის პირობებით, კოდი კი Apple Sample Code License-ით გამოქვეყნდა. Hugging Face-ის ჩანაწერში მითითებულია 9B პარამეტრი BF16 სიზუსტით, გასული თვის 233 ჩამოტვირთვა და უკვე ხელმისაწვდომი ორი კვანტიზაცია.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.