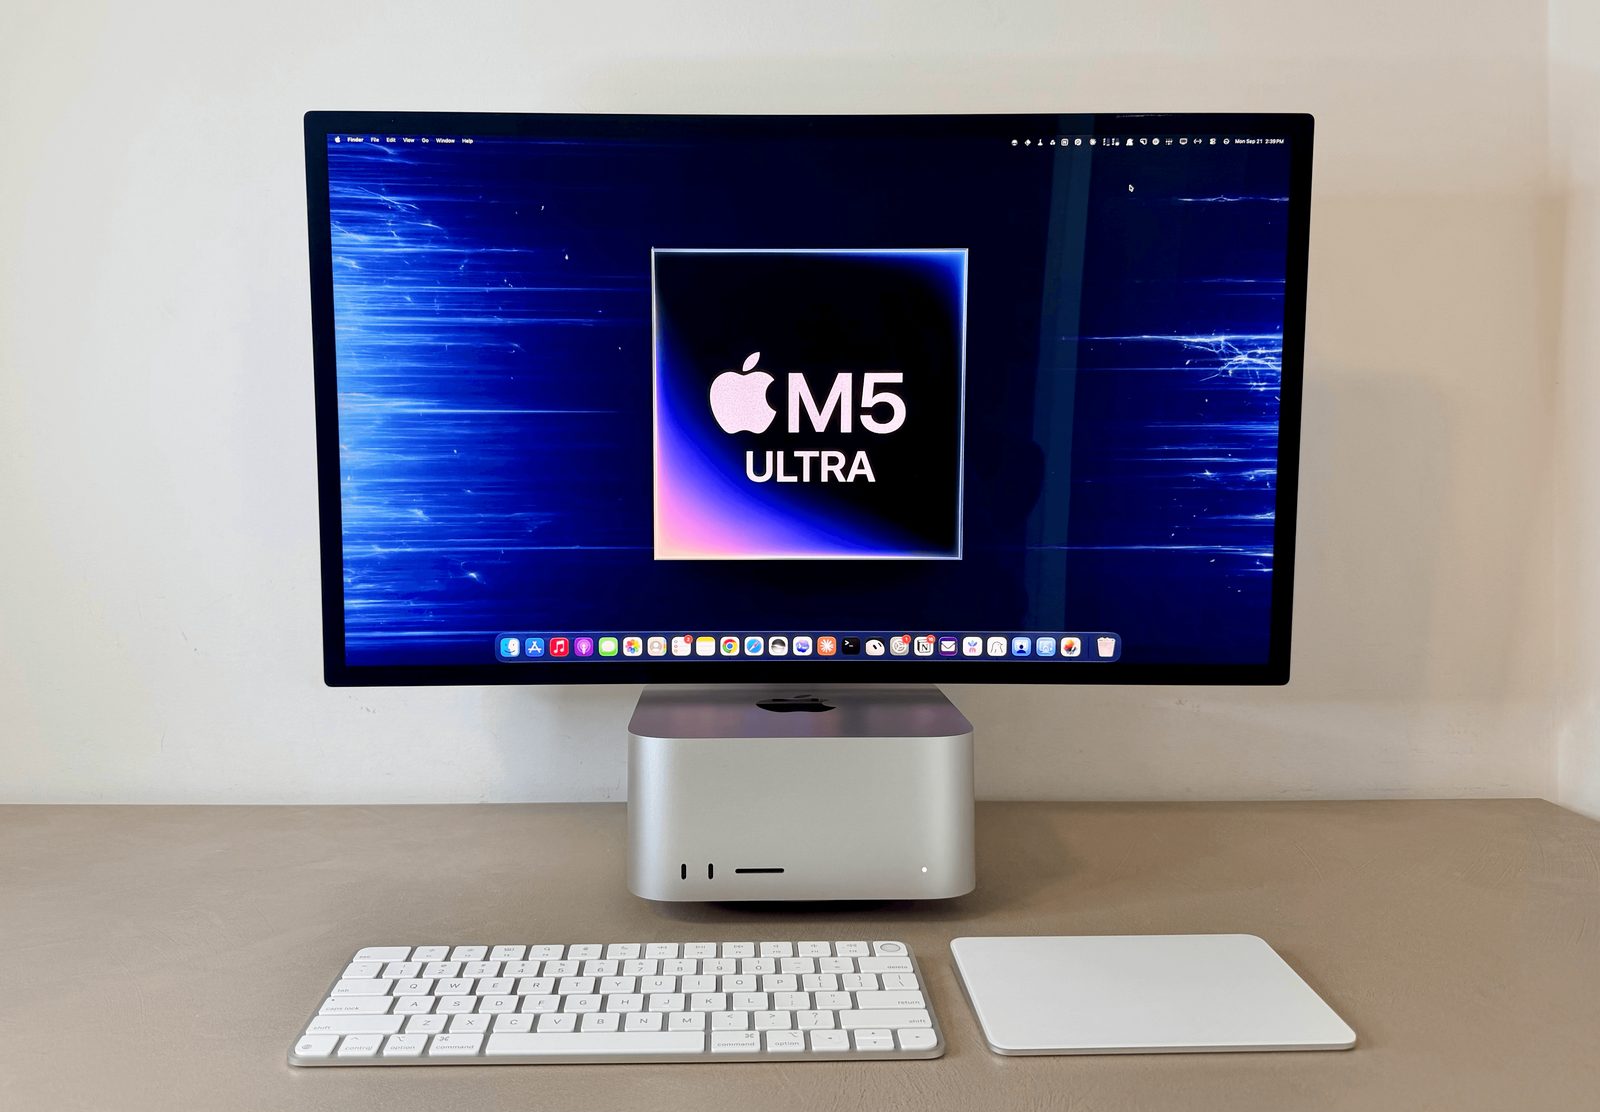
M5 Ultra Mac Studio-ის მიმოხილვა: ნახტომი ლოკალური AI-აგენტებისთვის
MacStories-მა ოთხი დღის განმავლობაში გამოსცადა 256 GB-იანი M5 Ultra Mac Studio M3 Ultra-სა და RTX 5090-იანი კომპიუტერის წინააღმდეგ. მიმოხილვის მიხედვით, პრომპტის დამუშავება საშუალოდ 150%-ით გაუმჯობესდა.
MacStories-მა გამოაქვეყნა M5 Ultra Mac Studio-ს მიმოხილვა — ამჟამად Apple-ის სამაგიდო Mac-ების ხაზში უმაღლესი მოდელი. ავტორმა ფედერიკო ვიტიჩიმ ოთხი დღის განმავლობაში გამოსცადა 256 GB ოპერატიული მეხსიერებით აღჭურვილი კონფიგურაცია, შეადარა რა წინამორბედ M3 Ultra-ს (512 GB) და RTX 5090-იან სათამაშო კომპიუტერს. დასკვნა: ეს პირველი Mac-ია, რომელიც ლოკალურ AI-ასისტენტებს ექსპერიმენტიდან პრაქტიკულ ხელსაწყოდ აქცევს.
ახალი არქიტექტურა უცვლელ კორპუსში
გარეგნულად M5 Ultra იდენტურია იმ M3 Ultra-სი, რომელსაც ანაცვლებს, თუმცა ჩიპი ახალია: Apple UltraFusion-ის საშუალებით ორ დაწყვილებულ M5 Max ჩიპს ერთ ოთხბირთვიან სტრუქტურაში აერთიანებს — კომპანიის ისტორიაში პირველად. GPU-ს 80 ბირთვი აქვს და თითოეული მათგანი Neural Accelerator-თანაა შეწყვილებული, რაც M3 Ultra-სთან შედარებით AI-ისთვის პიკურ გამოთვლით სიმძლავრეს 4,5-მდე ჯერ ზრდის. ერთიანი მეხსიერება, რომელსაც MLX-ზე დაფუძნებული ლოკალური მოდელები ეყრდნობა, კვლავ 256 და 512 GB ვარიანტებშია ხელმისაწვდომი, თუმცა გამტარუნარიანობა 819 GB/წმ-დან 1,2 TB/წმ-მდე გაიზარდა — 50%-ით მეტი. 512 GB მოდელი ოქტომბრის ბოლოს უნდა გამოვიდეს.
გაზომილი შედეგები
macOS 27-ზე, oMLX 0.7.0.dev2-ისა და Qwen3.8-Flash-Next მოდელის გამოყენებით ოთხდღიანი ტესტებისას, მოთხოვნის (პრომპტის) დამუშავება საშუალოდ 150%-ით გაუმჯობესდა — დაახლოებით 2,5-ჯერ მეტი, ვიდრე ავტორის წინა სისტემა; 16 ათასი ტოკენის მოთხოვნა წამში 2887 ტოკენის სიჩქარით იკითხებოდა, M3 Ultra-ზე კი 1143. იმავე შედარებაში გენერაციის სიჩქარე დაახლოებით 70%-ით მაღალი იყო, ხოლო გრაფიკები აჩვენებს წამში 91-დან 75 ტოკენამდე დაცემას კონტექსტის 4K-დან 256K-მდე ზრდისას. ცივი ქეშით 256K პრომპტის შემთხვევაში M3 Ultra პირველ თვალსაჩინო ტოკენს დაახლოებით 245 წამს ელოდა, M5 Ultra კი 102 წამს. სამი ერთდროული მოთხოვნისას (თითოეული ~6,5 ათასი ტოკენი) ახალმა Mac-მა სულ წამში 81,5 ტოკენი გამოიმუშავა — ერთ მოთხოვნასთან შედარებით 23%-ით მეტი; M3 Ultra-მ კი მხოლოდ 4% მოიმატა.
RTX 5090 კვლავ წინაა, მაგრამ საზღვრებით
NVIDIA-ს ბარათი უფრო სწრაფი რჩება, სანამ მოდელი მის მეხსიერებაში ჯდება: 6 ათასი ტოკენის პრომპტზე მან წამში დაახლოებით 3000 ტოკენი წაიკითხა, M5 Ultra-მ კი დაახლოებით 1700; 1,79 TB/წმ გამტარუნარიანობა 1,2 TB/წმ-ის წინააღმდეგ გენერაციაში 25%-იან უპირატესობას იძლევა. ბარათის ზღვარი 32 GB VRAM-ია: 8-ბიტიანი ყურადღების ქეშით მან გრძელი კონტექსტები 64K, 128K და 256K-ზე წამში 49,6, 40,4 და 30 ტოკენით დაასრულა, თუმცა როგორც კი PCIe-ის მეშვეობით სისტემური მეხსიერების სესხება მოუწია, ეს მაჩვენებლები 4,6-მდე, 2,9-მდე და 1,5-მდე დაეცა. ავტორი აღნიშნავს, რომ კომპიუტერი გაცილებით დიდი, ხმაურიანი და ცხელია, Mac Studio-ს ვენტილატორი კი ჩვეულებრივი მუშაობისას არ ისმის.
რატომ არის ლოკალური აგენტები ავტორისთვის მნიშვნელოვანი
ვიტიჩის ინტერესი პრაქტიკულია. ზაფხულის iOS-ისა და iPadOS 27-ის მიმოხილვის კვლევითი სისტემა დაფუძნებული იყო აგენტებზე, რომლებიც 310 დოკუმენტისგან შემდგარ პროექტზე 99 დღის განმავლობაში უწყვეტად მუშაობდნენ და საერთო ჯამში $0 ღირდა; მისი თქმით, ეს დატვირთვა ღრუბლოვანი API-ებით შეუძლებელი იქნებოდა. ლოკალური მოდელი მან ნაგულისხმევად აქცია iOS-ის Open Minis აპში. 256 GB ვარიანტისთვის საუკეთესო ბალანსად 5-ბიტიან კვანტიზაციას მიიჩნევს.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.