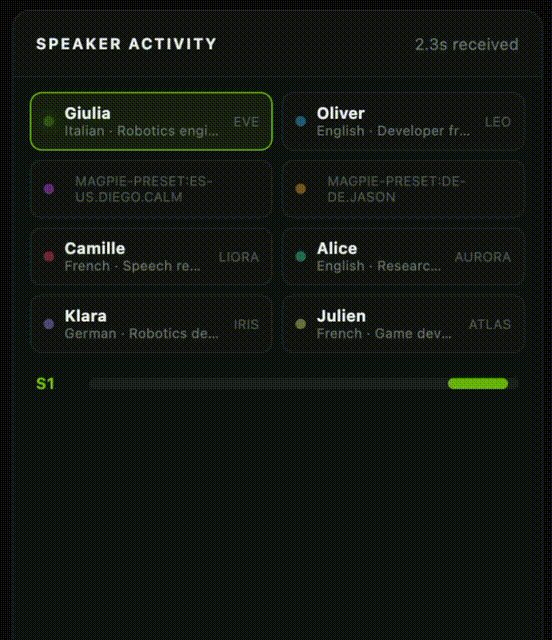
NVIDIA-მ ღია მოდელი Nemotron-3-Diarization გამოაქვეყნა, რომელიც ჩანაწერში სპიკერებს 8-მდე ამოიცნობს
NVIDIA-მ ღია წონების მოდელი Nemotron-3-Diarization გამოაქვეყნა, რომელიც ხმის ჩანაწერზე ერთ კითხვას პასუხობს: ვინ და როდის ლაპარაკობდა. ერთი მოდელი ოფლაინ დამუშავებასაც და სტრიმინგსაც უჭერს მხარს და 8 სპიკერამდე მუშაობს.
NVIDIA-მ ღია წონების მოდელი Nemotron-3-Diarization გამოაქვეყნა, რომელიც ხმის ჩანაწერზე პასუხობს კითხვას, ვინ და როდის ლაპარაკობდა. HackerNoon-ის მიმოხილვის თანახმად, გამოქვეყნება 2026 წლის 23 სექტემბერს მოხდა, ხოლო ჩამოტვირთვების რაოდენობამ 4282-ს მიაღწია. ერთი მოდელი ერთდროულად ოფლაინ დამუშავებასაც და სტრიმინგსაც უჭერს მხარს და 8 სპიკერამდე მუშაობს.
მოდელი Sortformer-ის ოჯახს მიჰყვება და გამომავალ არხებს სპიკერების პირველი გამოჩენის მიხედვით ალაგებს: პირველად გაჟღერებული ხმა პირველ არხს იღებს, რითაც გადანაცვლების პრობლემა ვინაობის წინასწარი ცოდნის გარეშე წყდება. სტრიმინგის დროს Arrival-Order Speaker Cache და FIFO რიგი სპიკერის ინფორმაციასა და ბოლო ფრეიმების კონტექსტს ნაწილებს შორის გადააქვს.
სტრიმინგი რეგულირებადი დაყოვნებით
დოკუმენტაცია ოთხ რეკომენდებულ კონფიგურაციას აღწერს. ოფლაინ რეჟიმის ვარიანტი 30,4 წამიან შემავალ ბუფერს იყენებს და კონტექსტს ამჯობინებს, სტრიმინგის რეჟიმები კი 1,04, 0,64 და 0,32 წამიან დაყოვნებას გვთავაზობს. ეს ციფრები მხოლოდ ბუფერის დაყოვნებას ეხება: ისინი (CHUNK_LEN + RIGHT_CONTEXT) × 80 მილიწამის ტოლია და არ ითვალისწინებს გამოთვლის დროს, გადაცემასა და დეკოდირებას. მოდელი 80 მილიწამამდე დაყოვნებას აღწევს, თუმცა რეკომენდებული მინიმუმი 0,32 წამია.
გამომავალი გარჩევადობა 10 მილიწამის ჯერადებით რეგულირდება, ნაწილებად დამუშავება კი ხანგრძლივობას არ ზღუდავს. მოდელი აბრუნებს სეგმენტებს დაწყებისა და დასრულების დროით და სპიკერის ინდექსით; Transformers-ის ოფლაინ რეჟიმში გამომავალს სპიკერის 8 არხი აქვს, თითო ფრეიმი ყოველ 10 მილიწამში.
ინსტრუმენტები, ლიცენზია და ღია კითხვები
ძირითადი Python ჩარჩოა NVIDIA NeMo Speech, სადაც მოდელი SortformerEncLabelModel კლასით არის წარმოდგენილი; ის Transformers-ის AutoModelForAudioFrameClassification კლასითაც მუშაობს. მსუბუქი C++ რანთაიმი NeMo-Speech.cpp ტრანსკრიფციას დიარიზაციასთან აერთიანებს და სიტყვებზე მიბმულ სპიკერის ტეგებს JSON-ის სახით გამოსცემს. NeMo-ს რეკომენდებული გარემო მოითხოვს Python 3.12-ს, Cython-ს, PyTorch-ს, libsndfile-სა და ffmpeg-ს.
მოდელი openmdw-1.1 ლიცენზიით ვრცელდება, დოკუმენტაციის თანახმად კი კომერციული და არაკომერციული გამოყენებისთვის მზადაა. პარამეტრების რაოდენობა, სასწავლო მონაცემები, VRAM-ის მოთხოვნა, სიჩქარე და DER-ის შედეგები არ არის მითითებული, ამიტომ მათი გაზომვა საკუთარ მოწყობილობასა და აუდიოზე მოგიწევთ. სპიკერის ინდექსები ვინაობას კი არა, გამოჩენის რიგს აღნიშნავს, მოდელი კი 8 სპიკერზე ჩერდება.
რატომ არის მნიშვნელოვანი
შეხვედრების ტექსტად გადაქცევისას დიარიზაცია ხშირად გამოტოვებული რგოლია: ASR აფიქსირებს, რა ითქვა, დიარიზაცია კი იმას, ვინ თქვა. ერთი ღია მოდელი, რომელიც არქივის ჩანაწერებსაც და ცოცხალ შეხვედრებსაც ერთნაირად ფარავს და დაყოვნების დოკუმენტირებული რეჟიმები აქვს, გუნდებს საშუალებას აძლევს, სპიკერზე მიბმული ტრანსკრიპტები ორი ცალკე მოდელის შეერთების გარეშე გამოსცადოს. გამოქვეყნებული სიზუსტის ბენჩმარკები კი არ არსებობს, ამიტომ გადაწყვეტილება მაინც საკუთარ გაზომვებს ეყრდნობა.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.