ანალიზი: OpenAI მზადაა Jev-ის ტექნოლოგია სწრაფად გაიმეოროს
Arcturus Labs-ის ანალიზის მიხედვით, OpenAI-ს შეუძლია TypeSafe-ის მოდელი Jev სწრაფად გაიმეოროს ან კლასიფიკაცია საკუთარ LLM-ებში ჩააშენოს. ღია რჩება მხოლოდ ერთი კითხვა: რამდენად ღრმაა TypeSafe-ის დაცვითი ბარიერი.
TypeSafe-ის Jev — მოდელი, რომელიც ტექსტის გენერაციის ნაცვლად კალიბრირებულ გადაწყვეტილებებს აბრუნებს — სწრაფად გავრცელდა: Vercel-ის თქმით, ის „AI Gateway-ის ისტორიაში ყველაზე სწრაფად ათვისებული მოდელი“ გახდა. Arcturus Labs-ის 21 სექტემბრის ანალიზის ავტორი ამტკიცებს, რომ OpenAI მალე შეძლებს მის გამეორებას.
LLM-ები კლასიფიკატორებად უკვე წლებია გამოიყენება
ანალიზი დაშვებიდან იწყება: Jev ჩვეულებრივი დიდი ენობრივი მოდელის ტიპზეა აგებული — Latent Space-ის ცნობით, მისი ადრეული კლონებიც LLM-ებზეა. ამ ლოგიკით, Jev ერთ საფეხურზე მომდევნო ტოკენის ალბათობის განაწილებას კითხულობს: „დიახ/არა“ კითხვისას true და false ტოკენების შეფარდებას ადარებს, არჩევანის კითხვისას — დასახელებულ ვარიანტებს.
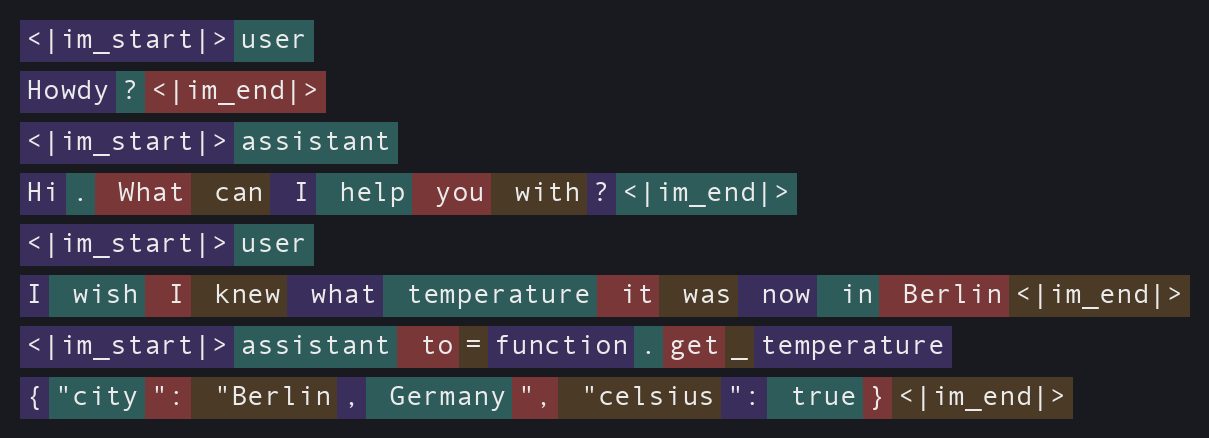
OpenAI ამ მიდგომის უფრო ვიწრო ვერსიას tool calling-ის გამოჩენიდან იყენებს: assistant-ის ჰედერის შემდეგ გამოსული პირველი ტოკენი კლასიფიკატორივით წყვეტს, გამოიძახოს თუ არა ინსტრუმენტი, მომდევნო ტოკენები კი ირჩევენ, რომელი. განსხვავება ისაა, რომ ეს კლასიფიკატორები სპეციალისტები არიან — Jev-ისა კი ზოგადი უნდა იყოს.
ბარიერი: სასწავლო მონაცემები და RL
ანალიზის ავტორის აზრით, არქიტექტურა TypeSafe-ს თითქმის ვერ იცავს; ნამდვილი ბარიერი სასწავლო მონაცემები და მათი დამუშავების პროცესია. X-ზე TypeSafe-ის თანადამფუძნებელმა Diogo Almeida-მ თქვა, რომ კომპანია თავს „მონაცემთა კვლევით ლაბორატორიად“ მიიჩნევს, მისი მონაცემები კი „ჭეშმარიტად ზოგადი“ (ერთგვარი „კოგნიტური ბირთვი“) და „100% სინთეტიკურია“.
ავტორი ვარაუდობს, რომ ასეთ მონაცემებში სიტუაციები ცნობილ შედეგებთანაა დაკავშირებული, რომ მოდელმა დომენური ცოდნის ნაცვლად ზოგადი კალიბრაცია ისწავლოს. ავტორი აფრთხილებს, რომ ეს ყველაფერი ბარიერი მხოლოდ მაშინაა, თუ Jev მართლაც ზუსტია — მან უკვე იპოვა სფეროები, სადაც მისი ალბათობები ვერ უძლებს შემოწმებას.
OpenAI-ის სავარაუდო შემდეგი ნაბიჯი
ცხადი გზა Jev-ის კოპირებაა — OpenAI-ს ამისთვის უნარიც, აპარატურაც და ფინანსებიც აქვს. უფრო საინტერესო ვარიანტი კლასიფიკაციის ჩვეულებრივ LLM-ში ჩაშენებაა: მოდელს შეუძლია აზროვნების პროცესში < prediction>-ის ტიპის ტეგი ჩასვას, სერვინგის სტეკი კი true და false ტოკენების logits-ებს წაიკითხავს და შედეგს ტექსტად დააბრუნებს.
ეს მოდელს საშუალებას აძლევს, ფიქრის დროს საკუთარი დაშვებები შეამოწმოს, დროულად შეამჩნიოს სახიფათო ხელსაწყოს გამოძახება ან prompt injection-ის მცდელობა და დავალებები დიდ მოდელსა თუ პატარას შორის გადაანაწილოს.
რას ნიშნავს ეს TypeSafe-ისთვის
თუ ბარიერის გადალახვა მართლაც რთულია, TypeSafe გადარჩება და შესაძლოა OpenAI-მ ის იყიდოს კიდეც, კონკურენციაში დამარცხების ნაცვლად; თუ ბარიერი სუსტია, TypeSafe-ის ფანჯარა მალე დაიხურება. Almeida Latent Space-თან ამბობს: „თუ მოდელის ხარისხს მნიშვნელობა აქვს, ჩვენ კიდევ დიდხანს ვიქნებით ძალიან კარგ პოზიციაზე“.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.