Qwen3.6 27B — ლოკალური განვითარების პრაქტიკული ოპტიმუმი
Quesma-ს ბლოგის ავტორის აზრით, მკვრივი 27B მოდელი ლეპტოპზე კარგად მუშაობს, რეალურ ამოცანებში უფრო სწრაფ ექსპერტთა ნარევის ვარიანტს ჯობია და 2025 წლის შუა პერიოდის ფრონტირის დონეს აღწევს.
ლოკალური ენის მოდელები ყოველდღიური მუშაობისთვის იშვიათად გამოიყურებოდა სერიოზულ ვარიანტად, თუმცა Quesma-ს ბლოგის ავტორი ამტკიცებს, რომ Qwen3.6 27B პირველი ლოკალური მოდელია, რომლის რეგულარულად გამოყენებაც ღირს. მოდელი ორი სახით გამოდის: ექსპერტთა ნარევის Qwen3.6 35B A3B — უფრო სწრაფი — და მკვრივი Qwen3.6 27B, რომელსაც ავტორი უფრო ნელი, მაგრამ უფრო ძლიერი უწოდებს და რეკომენდაციას უწევს.
რა გამოსცადა ავტორმა
ჩვეულებრივი შემოქმედებითი ტესტების გარდა, მოდელს OpenCode-ის მეშვეობით pnpm-ზე ექვსკუთხა საპერის აწყობა დაევალა. მან ერთი მოთხოვნიდან, პირველივე ცდაზე, სწორი Node პაკეტით მუშა პროექტი შექმნა. უფრო სწრაფმა 35B A3B-მა პაკეტის შექმნის ინსტრუქცია უგულებელყო და ყველაფერი ერთ index.html ფაილში მოათავსა. სანთლის მაღაზიის სადესანტო გვერდის უფრო გრძელი მოთხოვნა რამდენიმე წუთს მუშაობდა და ადეკვატური ნაგულისხმევი პარამეტრებით ადაპტირებადი გვერდი დააბრუნა. ავტორის დასკვნა: ფრონტირის სტანდარტებით არაფერი განსაკუთრებული, მაგრამ პრაქტიკული სამუშაო უკვე შესრულებულია.
ლოკალურად გაშვება
კონფიგურაცია Ollama-ს ნაცვლად llama.cpp-ს ეყრდნობა და Hugging Face-იდან 8-ბიტიან კვანტიზაციას იღებს: unsloth-ის Qwen3.6-27B-MTP-GGUF Q8_0 ვერსიას, რომელსაც მრავალტოკენიანი პროგნოზირება (MTP) მხარს უჭერს. ერთი llama-server ბრძანება მოდელს MTP-ით, ყველა ფენით GPU-ზე, ჩართული flash attention-ით, 64k კონტექსტითა და მიბმული პორტით უშვებს; მოდელის ბუნებრივი კონტექსტი 256k-ია. 8-ბიტიანი კვანტიზაცია BF16 ვერსიის მოცულობას ნახევრად ამცირებს თითქმის ხარისხის დანაკარგის გარეშე, ხოლო 4-ბიტიანი ვერსია 18 გბ-ზე ნაკლებია და 32 გბ-იან მოწყობილობაზეც ეტევა.
წარმადობა და შედარება
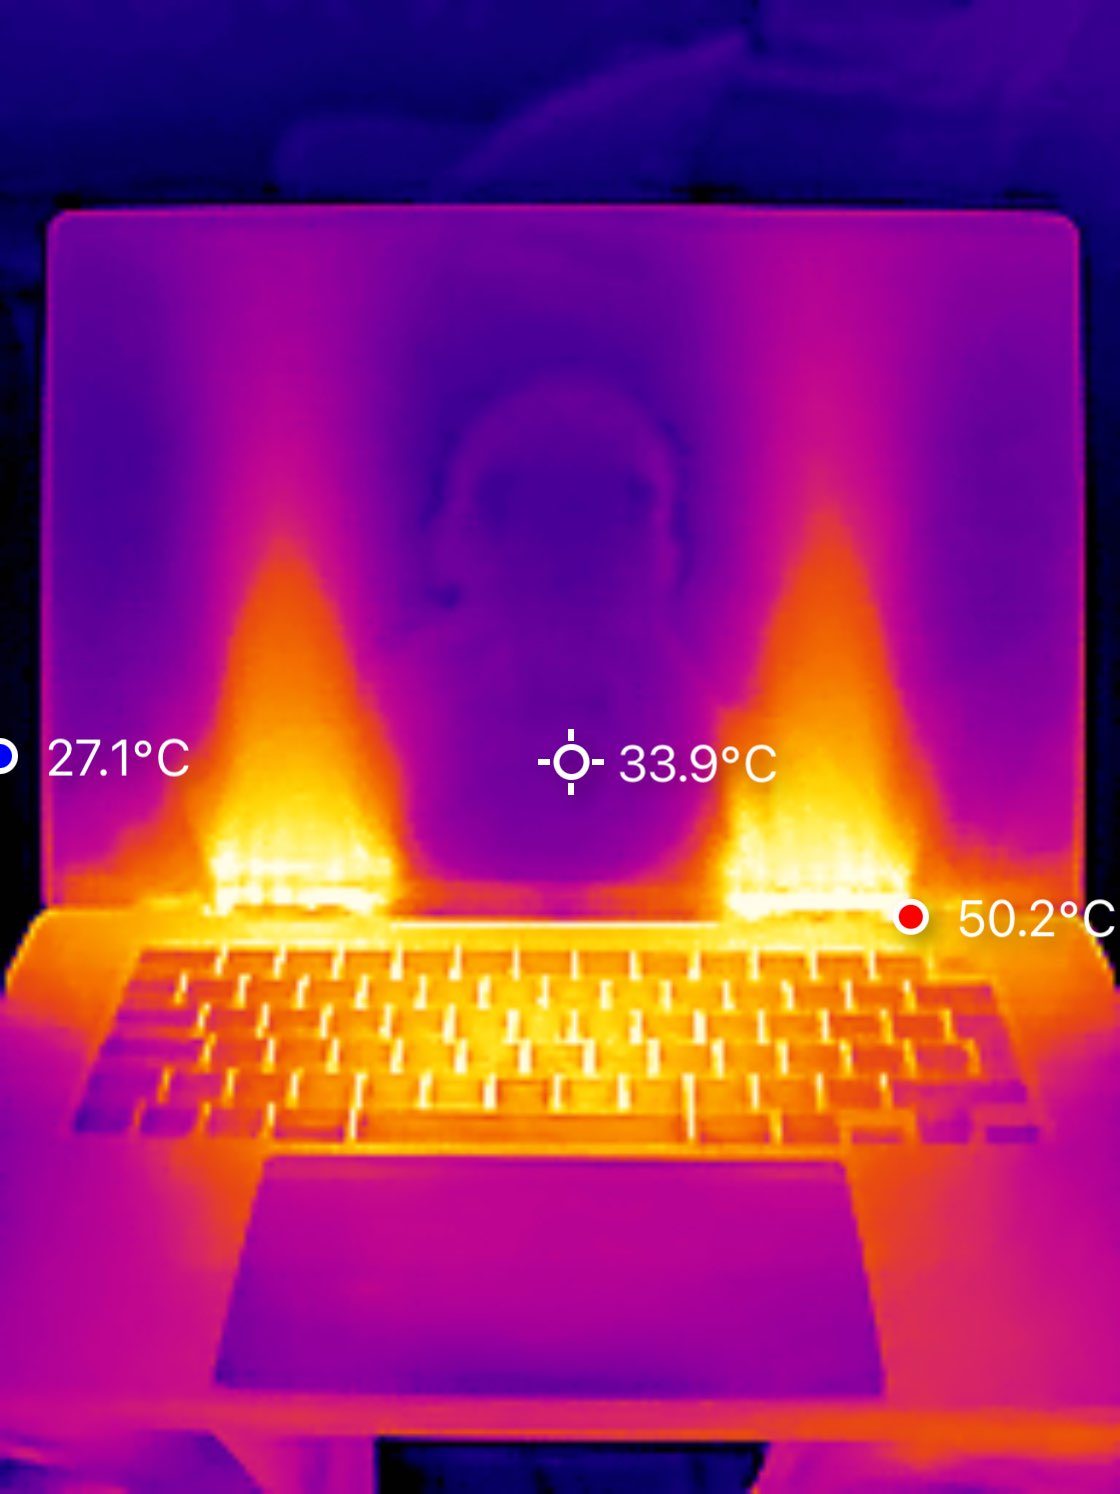
128 გბ ერთიანი მეხსიერების MacBook M5 Max-ზე მოდელი წამში დაახლოებით 30 ტოკენს გამოიმუშავებს — ფრონტირის API-ების ტიპურ დიაპაზონში — და GPU-ს დაახლოებით 95 პროცენტს იყენებს. llama.cpp უფრო სწრაფი აღმოჩნდა, ვიდრე mlx-lm, მიუხედავად იმისა, რომ ეს უკანასკნელი Apple-ის ჩიპებისთვისაა გათვლილი; ორივე Qwen3.6 ვარიანტი 48 გბ მეხსიერების ფარგლებში ჯდება. სამომხმარებლო Nvidia RTX 5090-ზე Hacker News-ის ერთმა მომხმარებელმა Q6_K კვანტიზაციითა და Q4_0 KV ქეშით 123k კონტექსტზე წამში დაახლოებით 50 ტოკენი დააფიქსირა. Artificial Analysis-ის ინდექსზე 27B 37 ქულას იღებს, რასაც ავტორი 2025 წლის შუა პერიოდის ფრონტირის დონეს ადარებს — 35B A3B-ის 32 და Gemma 4 31B-ის 29 ქულის წინ. ავტორი მაინც 27B-ს ანიჭებს უპირატესობას: სამჯერ ნაკლები კოდი, მაგრამ უფრო მაღალი ხარისხით. მისი მთავარი არგუმენტია, რომ ლოკალური მოდელების დახვეწა შესაძლებელია, მათ ვერავინ წაართმევს და ისინი მგრძნობიარე მონაცემებისთვისაც გამოდგება.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.