Qwen 3.8 27B: შესანიშნავი 17 გბ-ში, თუმცა ნაგულისხმევად ზედმეტად ფიქრობს
ალიბაბას Qwen-ის ლაბორატორიამ Apache 2.0 ლიცენზიით გამოუშვა 27-მილიარდიანი მოდელი ხედვის უნარით. ის ჩვეულებრივ კომპიუტერზე მუშაობს, თუმცა ნაგულისხმევი reasoning-ის პარამეტრი ზედმეტ რესურსს ხარჯავს.
14 აგვისტოს ალიბაბას Qwen-ის კვლევითმა ლაბორატორიამ გამოაქვეყნა Qwen 3.8 27B — 27 მილიარდი პარამეტრის მქონე, სურათების აღქმის უნარის მქონე მოდელი Apache 2.0 ლიცენზიით. წონები ხელმისაწვდომია Hugging Face-ზე, ხოლო მოდელის ლოკალურად გაშვება შესაძლებელია LM Studio-ს ან llama.cpp-ის მეშვეობით.
მაჩვენებლები და პირველი შთაბეჭდილებები
Qwen-ის მიერ გამოქვეყნებული შედეგები ახალ მოდელს აშკარად წინ აყენებს როგორც წინამორბედ Qwen 3.6 27B-თან, ისე დახურულ Qwen 3.7-Plus-თან შედარებით — მოდელთან, რომელიც მაისისთვის Qwen-ის ერთ-ერთ ყველაზე ძლიერ სისტემად ითვლებოდა. დამოუკიდებელი შეფასებები ჯერ არ გამოქვეყნებულა. დეველოპერმა საიმონ უილისონმა, რომელმაც მოდელი 128 გბ-იან M5 Max MacBook Pro-ზე და NVIDIA DGX Spark-ზე გამოსცადა, 27B „იდეალურ ზომად" შეაფასა ჩვეულებრივ ლეპტოპზე ძლიერი მოდელის გასაშვებად.
ჭარბი ფიქრი ნაგულისხმევად
მოდელს აქვს reasoning_effort პარამეტრი, რომლის ნაგულისხმევი მნიშვნელობაა „xhigh", და LM Studio-ს GGUF ვერსია ამ პარამეტრს ინარჩუნებს. პრაქტიკაში ეს ნიშნავს, რომ უმარტივესი მოთხოვნაც კი ათასობით მსჯელობის token-ს ხარჯავს: LM Studio-ს სტანდარტული 8 192 token-იანი კონტექსტი სწრაფად ივსებოდა, და პრობლემა მხოლოდ სრული 262 144 token-იანი კონტექსტის ჩატვირთვის შემდეგ გაქრა.
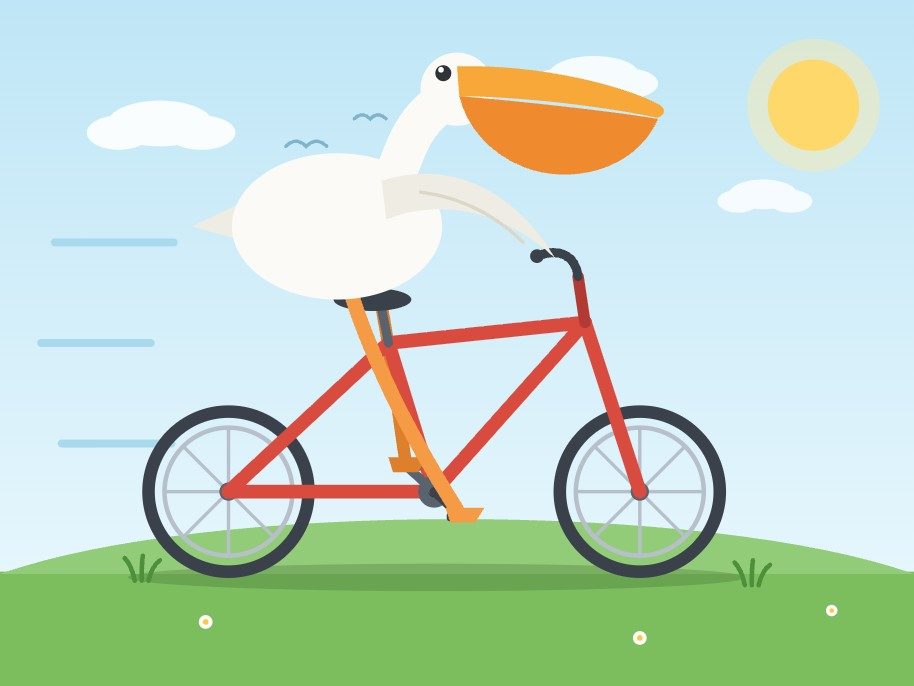
ტესტში მოდელს 21 წუთი და 22 276 მსჯელობის token დასჭირდა იმისთვის, რომ ველოსიპედზე მჯდომი პელიკანის SVG 3 223 token-ად შეექმნა. მსჯელობის გამორთვით იგივე დავალება 137 წამში და 3 715 token-ში დასრულდა. მარტივ მოთხოვნაზე — „დახატე წრის SVG" — მოდელმა რთული, ანიმაციური კომპოზიცია შემოგვთავაზა. ავტორის პრაქტიკული რჩევაა, მოდელი თავიდან დაბალ დონეზე ან სრულად გამორთული reasoning-ით გაუშვათ.
ხედვა, ხელსაწყოები და სიჩქარე
მოდელი ძლიერი აღმოჩნდა ვიზუალურ ამოცნობაში: ფოტოზე პელიკანებისთვის 0–1000 შკალაზე JSON ჩარჩოების მოთხოვნისას მან ობიექტების საზღვრები ზუსტად დააბრუნა. ერთი მოთხოვნით მან ასევე ააწყო პატარა HTML ხელსაწყო, რომელიც სურათზე ასეთ ჩარჩოებს ხატავს და სრულად ოფლაინ მუშაობს; შედეგი გადაჭარბებით რთული, მაგრამ ფუნქციური იყო.
მთავარი ნაკლი სიჩქარეა. LM Studio-მ დაახლოებით 15–30 token/წმ მოგვცა, მაშინ როცა Artificial Analysis-ის გაზომვებით OpenAI-ის ჰოსტინგზე მყოფი 5.6 Sol და 5.6 Luna 74 და 184 token/წმ-ს აღწევენ. საზოგადოებრივი ოპტიმიზაცია არსებობს: Qwen მხარს უჭერს Multi-Token Prediction-ს, და llama.cpp-ის სერვერი draft-mtp დეკოდირების ოფციით DGX Spark-ზე ჩატარებულ ტესტში LM Studio-ს სტანდარტულ ვერსიას დაახლოებით 72%-ით აჯობა.
მთავარი დასკვნა ისაა, რასაც 17 გბ-იანი ფაილი ახლა აჩვენებს: გრძელი კონტექსტი, ხელსაწყოების გამოძახება, ხედვა და კოდის წერა — ყველაფერი იმ აპარატურაზე, რომელიც დეველოპერს უკვე აქვს. ღია რჩება მხოლოდ ის, მოასწრებს თუ არა inference-ის სიჩქარე ამ შესაძლებლობებს.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.