Qwen3.8-27B ერთ და ორ RTX 3090-ზე: +20% decode, +14% ცივი prefill, 3x ქეშირებულ prompt-ებზე
Qwen3.8-27B-ის ტესტი vLLM-ში: ერთი RTX 3090 ორ ბარათს ედარება tensor parallelism-ში. მეორე ბარათი decode-ს 15–30%-ით, ცივ prefill-ს კი საშუალოდ 14%-ით აჩქარებს; დანარჩენი ნაწილი prefix cache-ის დამსახურებაა.
Qwen3.8-27B — 27.8B პარამეტრიანი მკვრივი მოდელი, რომელიც 14 აგვისტოს გამოვიდა — W4A16 კვანტიზაციით ერთ 24-გიგაბაიტიან ბარათზე ეტევა. Arsen Apostolov-მა გაზომა, რას იძლევა პრაქტიკაში მეორე RTX 3090 tensor parallelism-ის რეჟიმში.
სატესტო გარემო
ორივე სერვერი vLLM-ზე მუშაობს prefix caching-ით, ერთი იმიჯიდან და იმავე Qwen3.8-27B-W4A16-AutoRound-fast წონებით. ერთ ბარათს 22.6 გბ VRAM და 131,072 ტოკენის კონტექსტი აქვს; წყვილი წონებს ორ ბარათზე ყოფს — 21.7 გბ თითოეულზე — და კონტექსტს 262,144 ტოკენამდე აორმაგებს. მანქანას სამი RTX 3090, ორი Xeon E5-2660 v4, 60 გბ RAM და Ubuntu 26.04 აქვს.
გაზომვა 150-სტრიქონიანი სკრიპტით ხდება: მოთხოვნები ოთხი ზომის prompt-ით (600-დან 9,300 ტოკენამდე), თითოეული სამჯერ, მედიანით, max_tokens=256 და temperature=0. ცივ მოთხოვნას უნიკალური პირველი ხაზი აქვს, რომ ქეშირებული prefix ვერ დაემთხვეს.
Decode: მეორე ბარათი 15–30%-ს იძლევა
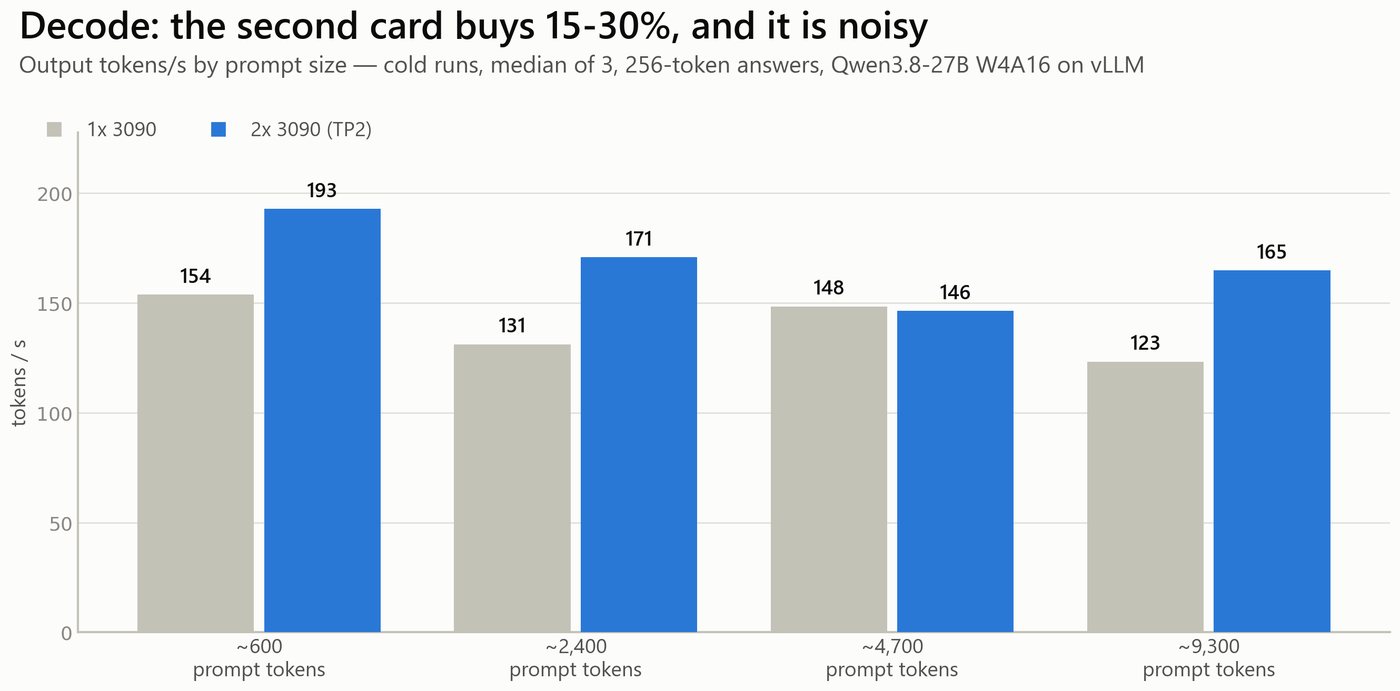
ერთი ბარათი წამში 123–154 ტოკენს ინარჩუნებს, წყვილი — 146–193-ს. მატება ამ გაშვებაში საშუალოდ +22% იყო, საათით ადრე — +13%, რადგან ერთნაკადიანი decode საათის ინტერვალში დაახლოებით 10%-ით იცვლება. ავტორი შედეგს განზრახ არამრგვალებს: 15–30%, ქვედა ზღვრისკენ.
Prefill: ცივი ბარათების, თბილი — ქეშის
ცივი prefill გამოთვლებზეა დამოკიდებული: ერთი ბარათი წამში 1,100–1,220 ტოკენს ამუშავებს, წყვილი — 1,230–1,360-ს. პირველ ტოკენამდე დრო 0.53-დან 8.5 წამამდე იზრდება ერთ ბარათზე, როცა prompt 600-დან 9,300 ტოკენამდე იზრდება, ორ ბარათზე კი 0.50-დან 6.9 წამამდე — 6% სხვაობა 600 ტოკენზე, 23% 9,300-ზე, საშუალოდ 14%.
თბილი მოთხოვნების სურათი სხვაა: გამეორებული prompt წყვილზე 0.5–0.75 წამში ბრუნდება, ერთ ბარათზე — 0.5–1.7 წამში; ეს 2–3-ჯერადი სხვაობა prefix cache-ს ეკუთვნის და არა რკინას. მინიშნება არითმეტიკაშია: 8,600 ტოკენი 0.56 წამში წამში 15,000 ტოკენია — ათჯერ მეტი, ვიდრე ორი 3090 იძლევა 27B მოდელზე.
რა ღირს
ორივე კონტეინერის მუშაობისას მანქანა კედლიდან 620 ვატს მოიხმარს. წამში 150 ტოკენის ტემპით მილიონი ტოკენი დაახლოებით 6,667 წამს, ანუ 1.15 კვტ/სთ-ს მოითხოვს — ბულგარეთის ორტარიფიანი სისტემით დღისით 0.34 BGN, ღამით 0.21 BGN, დაახლოებით $0.20 ან $0.12. DeepInfra Qwen3.8-27B-ს მილიონ გამომავალ ტოკენზე $3.00-ად ყიდის.
Apostolov არ ამბობს, რომ ამის გამო API ცუდი არჩევანია: მის ფასში დატაცენტრის ენერგია, გაგრილება და უმოქმედო სიმძლავრეც შედის. უფრო ვიწრო დაკვირვებაა, რომ უკვე ჩართულ მოწყობილობაზე ყოველი მოწოდებული ტოკენი თითქმის სუფთა მარჟაა. ტესტის შეზღუდვასაც აღნიშნავს: ერთმოთხოვნიანი გაზომვაა და continuous batching არ შემოწმდა.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.