Qwen3.8-Flash-Next: Alibaba-ის Qwen გუნდმა Qwen4-ის არქიტექტურის ექსპერიმენტული ვერსია წარადგინა
Qwen-ის გუნდმა 26 აგვისტოს წარადგინა 125-მილიარდიანი პარამეტრიანი მოდელი ღია წონებით, რომელიც Qwen4-ის არქიტექტურას იკვლევს და 262 144 ტოკენის კონტექსტს მხარს უჭერს.
Alibaba-ს Qwen გუნდმა 26 აგვისტოს გამოაქვეყნა Qwen3.8-Flash-Next — ღია წონებით ხელმისაწვდომი ექსპერიმენტული მოდელი, რომელიც კომპანიის თქმით Qwen4-ის არქიტექტურის საფუძველი უნდა გახდეს. წონები Hugging Face-ზეა გამოქვეყნებული Qwen-community-1.0 ლიცენზიით და თავსებადია Transformers, vLLM, SGLang და TokenSpeed ინფრასტრუქტურასთან.
ჰიბრიდული ყურადღება და QSA
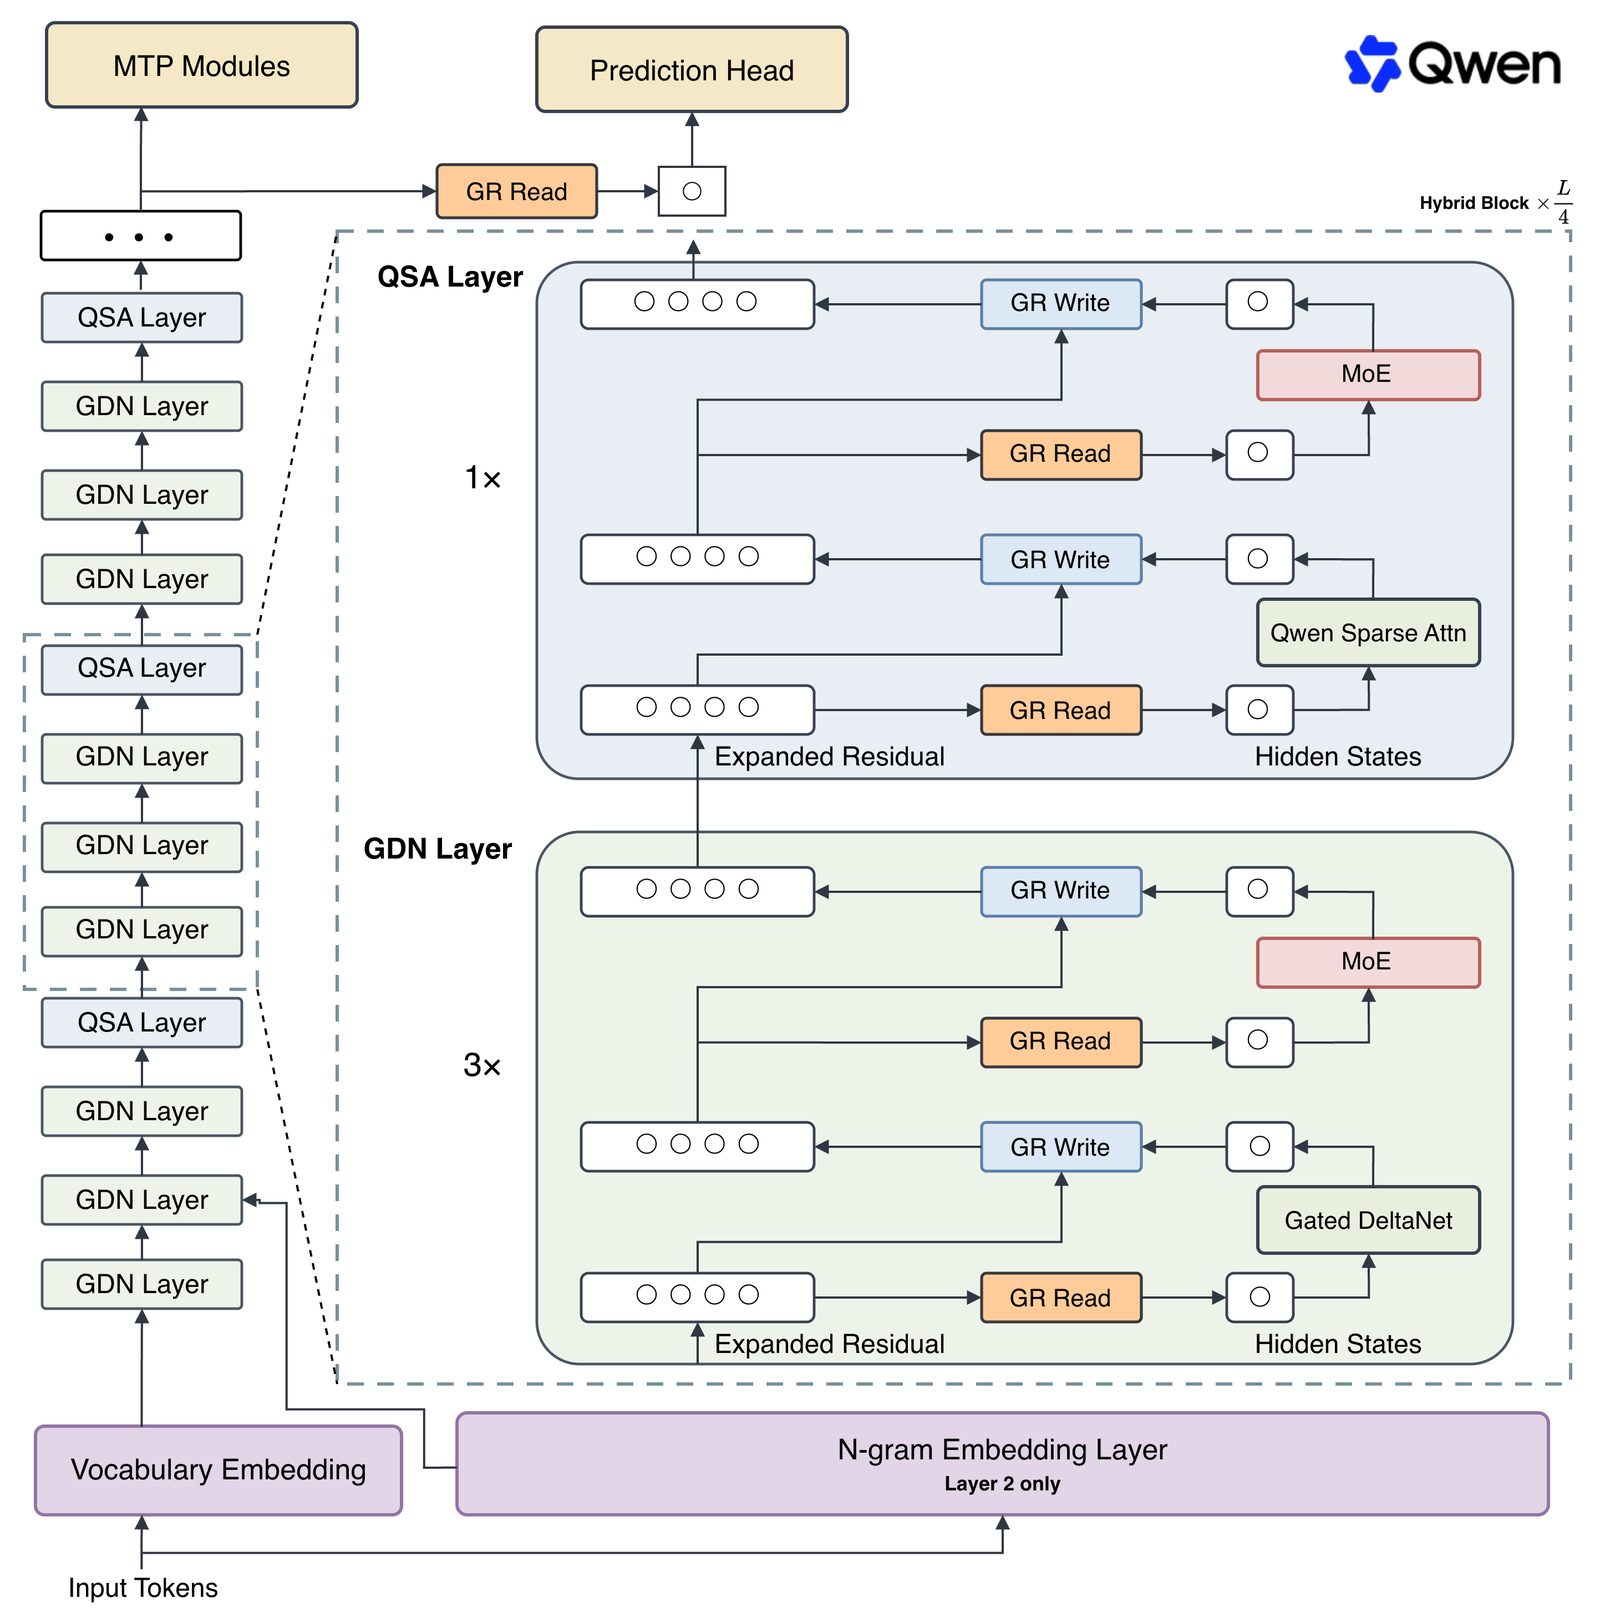
გამოცემის ცენტრში არქიტექტურული ცვლილებაა: Gated DeltaNet-ისა და Gated Attention-ის წყვილი შეცვალა Gated DeltaNet-მა და Qwen Sparse Attention-მა (QSA). QSA ცალკეული ტოკენების ნაცვლად მიკრობლოკების დონეზე ირჩევს მნიშვნელოვან კონტექსტს, რაც გრძელ კონტექსტში დაყოვნებას მკვეთრად ამცირებს — ეს კრიტიკულია აგენტური დატვირთვებისთვის, რომლებიც სულ უფრო მეტს იკავებენ რეალურ გამოყენებაში.
Gated Residual და N-gram ჩანერგვა
Gated Residual არეგულირებს ინფორმაციის ნაკადს გაფართოებულ residual ნაკადებში ელემენტურ, მონაცემებზე დამოკიდებულ წაკითხვის კარიბჭესა და თითო ტოტის სკალარული ჩაწერის კარიბჭის მეშვეობით. N-gram ჩანერგვა კი პარამეტრების ზრდის დამოუკიდებელი ღერძია: ის MoE-ზე ნაკლებ გამოთვლას მოითხოვს და მეხსიერებით შეზღუდულ ამაჩქარებლებზე გადატანას უფრო ადვილად ექვემდებარება.
მასშტაბი და ტესტების შედეგები
მოდელს 125 მილიარდი პარამეტრი აქვს, საიდანაც ერთდროულად მხოლოდ 6 მილიარდია აქტიური; დამატებით 51 მილიარდი n-gram ჩანერგვისა და 4 მილიარდი MTP პარამეტრი. ქსელი 48 ფენისგან შედგება და 512 ექსპერტს მოიცავს (10 მარშრუტირებული და 1 საერთო). კონტექსტის ფანჯარა ბუნებრივად 262 144 ტოკენია და 1 მილიონ ტოკენამდეა გაფართოებადი. გამოქვეყნებულ შედეგებში SWE-bench Pro-ში მოდელმა 62.5 ქულა აიღო, DeepSWE 1.1-ში — 58.7, SWE-bench Multilingual-ში — 81.0, NL2Repo-Bench-ში — 48.1, ხოლო CoWorkBench-ში — 73.9.
რას ნიშნავს ეს დეველოპერებისთვის
ტრენინგზე Qwen აცხადებს, რომ Muon და AdamW ოპტიმიზატორები კონკრეტულ წონით კატეგორიებზე იხარჯება, batch-size-ის ტრადიციული გახურება კი გაუქმდა — სწავლება პირდაპირ სამიზნე ზომით იწყება. პარალელურად, იგივე არქიტექტურის პროდუქციული ვერსია Qwen3.8-Flash ღრუბელში 1 მილიონი ტოკენის კონტექსტითა და ჩაშენებული ხელსაწყოებით მუშაობს, ღია წონები კი დამოუკიდებელ გაშვებას რჩება. ტექნიკური დოკუმენტი Qwen-ის GitHub-ის რეპოზიტორშია გამოქვეყნებული.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.