AWS-მა MoE მოდელების RL სწავლება EKS-ზე EFA-სა და DeepEP-ის მეშვეობით 40%-ით დააჩქარა
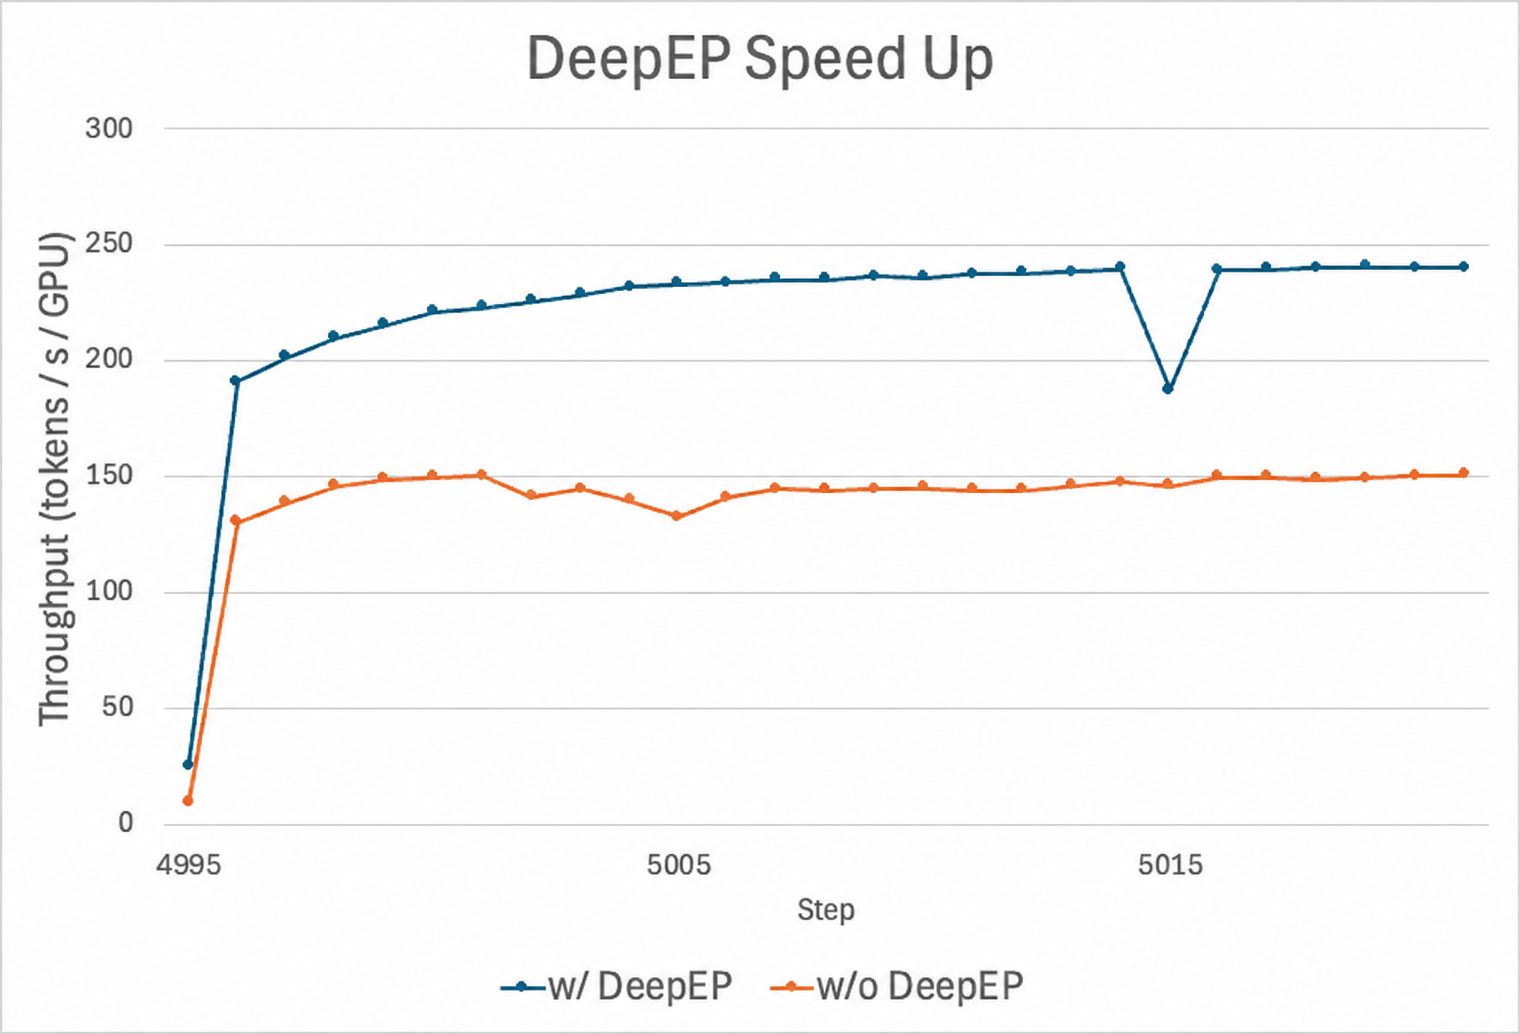
AWS-მა MoE მოდელების დიდი მასშტაბის RL სწავლების არქიტექტურა წარმოადგინა, რომელიც Amazon EKS-ს, EFA-ს და DeepEP-ს აერთიანებს. ტესტში 48 P5en ინსტანციაზე DeepEP-ის EFA-ზე ჩართვამ rollout-ის გამტარუნარიანობა 40%-ით გაზარდა.
AWS-მა არქიტექტურა წარმოადგინა, რომელიც MoE (Mixture-of-Experts) მოდელების დიდი მასშტაბის RL სწავლებას Amazon EKS-ზე EFA-სა და DeepEP-ის მეშვეობით აწყობს. Machine Learning ბლოგზე 25 სექტემბერს, 2026 წელს გამოქვეყნებული ტექსტის ავტორების თქმით, DeepEP-ის EFA-ზე ჩართვამ rollout-ის გამტარუნარიანობა 40%-ით გაზარდა.
რატომ არის MoE-ის RL სწავლება კომუნიკაციაზე მიბმული
ინფერენსის გაიაფებისთვის უფრო იშვიათი არქიტექტურები სწავლებას კომუნიკაციაზე მიბამს და არა გამოთვლებზე. ამ ხარჯის მთავარი წყარო Expert Parallelism (EP) არის: Tensor, Data და Pipeline პარალელიზმის სქემებს ემატება ტოკენების დინამიური all-to-all მარშრუტიზაცია.
ასინქრონული RL სამუშაო ერთდროულად ორ დატვირთვას ატარებს: rollout გენერაცია განაწილებული ინფერენსია და გამტარუნარიანობას ზრდის, პოლიტიკის სწავლება კი სინქრონულ პროცესებს მოითხოვს, სადაც ერთი ჩამორჩენილი worker მთელ სამუშაოს აჩერებს ან NCCL-ის დროის ამოწურვას იწვევს. ერთი ინსტანციის მიღმა ტრაფიკი კვანძის შიგნით არსებული NVLink-იდან კვანძთაშორის არხებზე გადადის.
როგორ გადააქვს DeepEP ტოკენები EFA-ზე
DeepEP ზოგად all-to-all კოლექტივებს ორი kernel-ით ცვლის: dispatch ტოკენებს დისტანციურ ექსპერტებთან აგზავნის, combine შედეგებს აგროვებს; კვანძის შიგნით ისინი NVLink-ს იყენებს, კვანძებს შორის libfabric-ს. AWS-მა upstream-ში ცვლილებები შეიტანა, რომლებიც DeepEP-ის პრიმიტივებს libfabric-ზე გადააქვს, ამიტომ DeepEP v2-მ EFA-ს მშობლიური მხარდაჭერა მიიღო, NCCL 2.31-მა კი EFA-ს უახლესი ოპტიმიზაციები დაამატა. P5-ისა და P6-ის ინსტანციებზე EFA NVIDIA GPUDirect RDMA-სთან ერთად მონაცემებს პირდაპირ GPU-ს მეხსიერების ბუფერებს შორის გადააქვს.
რა აჩვენა ბენჩმარკმა და რა არის საჭირო
P5en-ის 48 ინსტანციაზე, საიდანაც 16 სწავლებას და 32 ინფერენსს მიეკუთვნა, იმავე super-sparse MoE მოდელზე DeepEP-ის EFA-ზე ჩართვამ rollout-ის გამტარუნარიანობა 40%-ით გაზარდა, ხოლო მასშტაბი ათასამდე ამაჩქარებელს მიაღწია. საბაზისო ვარიანტი Slime-ზე აგებული სტეკი იყო (CUDA 12.9, PyTorch 2.9.1, NCCL 2.27, SGLang 0.5.9, Slime 0.2.4), გაუმჯობესებული კი DeepEP-over-EFA სტეკი (CUDA 13.0, PyTorch 2.12, NCCL 2.31, EFA 1.49, DeepEP 2.0, SGLang 0.5.17, Miles 0.1.0).
ტექსტში ჩამოთვლილია Amazon EKS 1.31 ან უფრო ახალი ვერსია, EFA installer 1.49 AWS OFI NCCL plugin-ით და ინსტანციები p5.48xlarge ან p6-b200.48xlarge; კვანძები ერთ Availability Zone-ში უნდა იყოს. rollout-ისთვის Amazon EC2 Spot ინსტანციები ჯდება, შეწყვეტილი დავალებები რიგში ბრუნდება, სწავლება კი სტაბილურ სიმძლავრეს ინარჩუნებს. სამუშაოები TorchX-ით იგზავნება, checkpoint-ები Amazon S3-ში ინახება.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.