WhisperX SageMaker AI-ზე: AWS-მა მოსაუბრეთა გარჩევის კონტეინერი გამოაქვეყნა
AWS-მა გამოაქვეყნა ინსტრუქცია WhisperX-ის Amazon SageMaker AI-ზე გაშვების შესახებ. კონტეინერი OpenAI-ს Whisper-ს სიტყვების დონის დროის ნიშნებსა და მოსაუბრეთა გარჩევას ამატებს.
AWS-მა გამოაქვეყნა ინსტრუქცია, როგორ უნდა გაუშვას WhisperX, OpenAI-ს Whisper-ზე დაფუძნებული ღია კოდის მეტყველების ტრანსკრიფციის პროექტი, Amazon SageMaker AI-ზე. პოსტში აღწერილია AWS WhisperX Deep Learning Container-ი და მისი გაშვების ორი გზა.
რას ამატებს WhisperX Whisper-ს
Whisper ბევრ ენაზე ზუსტად გადაიყვანს მეტყველებას ტექსტად, მაგრამ დროის ნიშნებს ფრაზის დონეზე აბრუნებს და არ ამბობს, ვინ საუბრობს. WhisperX სამ რამეს ამატებს: ჯგუფურ დამუშავებას, რაც ტრანსკრიფციას აჩქარებს, wav2vec2-ის იძულებით გასწორებას სიტყვების დონის დროის ნიშნებისთვის და მოსაუბრეთა გარჩევას.
კონტეინერში უკვე შედის Whisper, გასწორების მოდელები და მოსაუბრეთა გარჩევის წონები, ამიტომ Hugging Face-ის ტოკენი საჭირო არ არის. სერვისი 8080 პორტზე მუშაობს, იყენებს POST /invocations-სა და GET /ping-ს, იღებს multipart/form-data-ს აუდიო ფაილით და ველებით language და diarize, პასუხს კი json, verbose_json, srt ან vtt ფორმატში აბრუნებს.
რეალური დროისა და ასინქრონული endpoint-ები
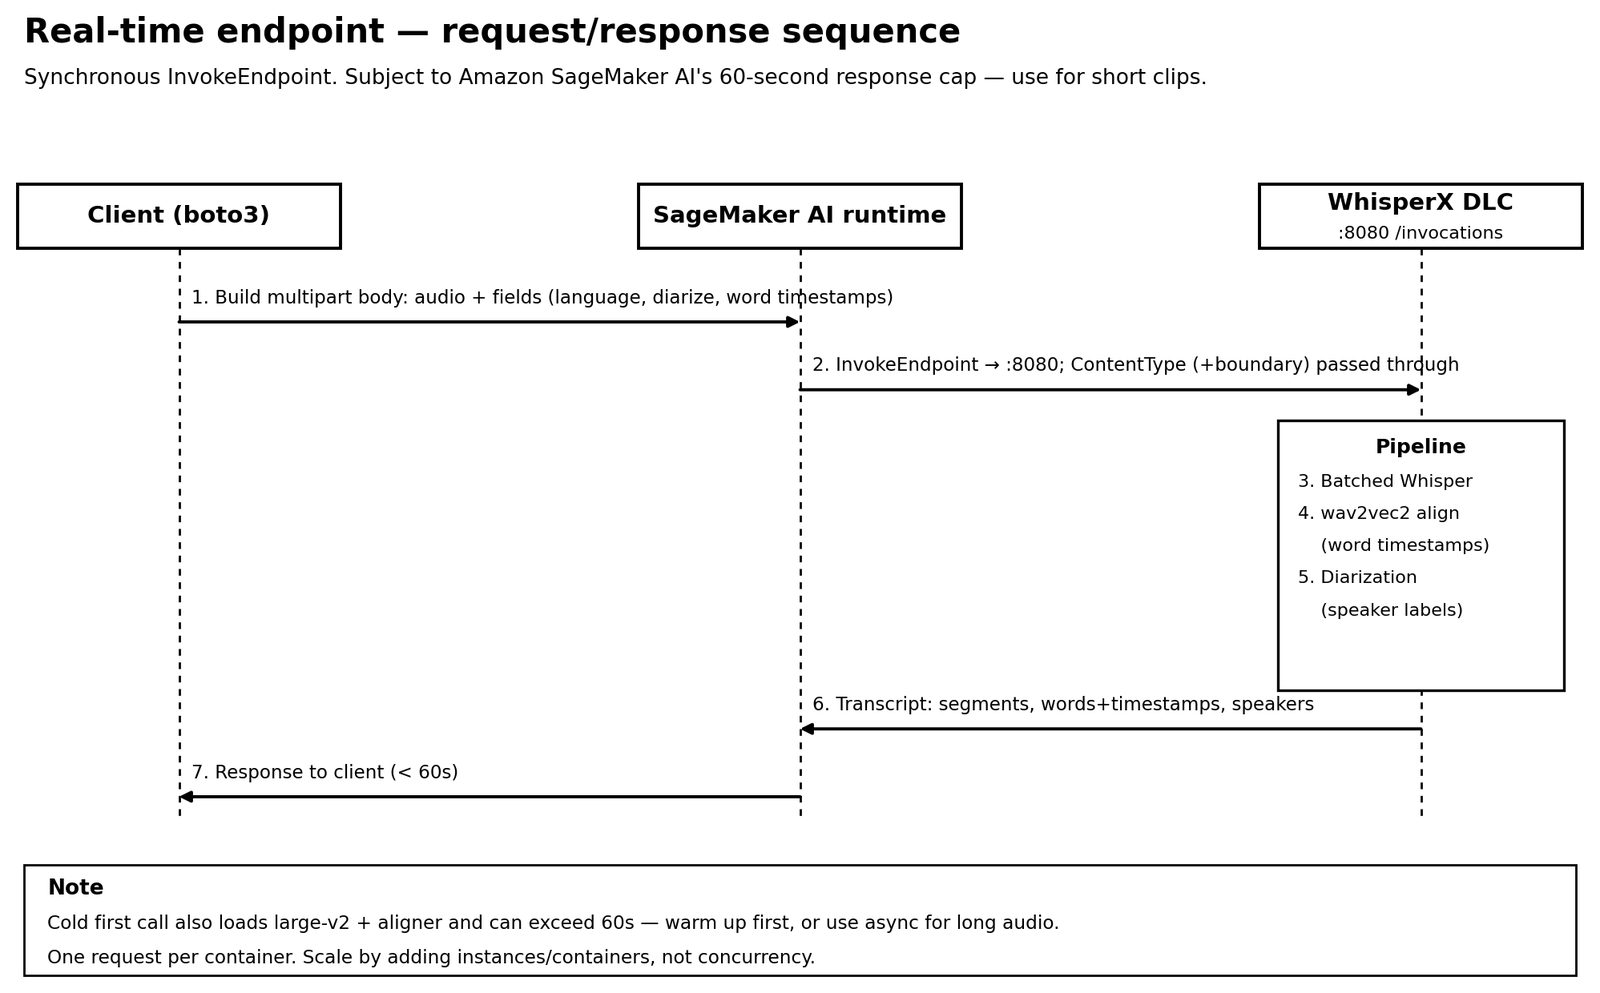
რეალური დროის endpoint სინქრონულია: აუდიო მოთხოვნაში გადაეცემა და ტრანსკრიპტი იმავე პასუხში ბრუნდება, ამიტომ ჩანაწერი SageMaker AI-ის 60-წამიან ლიმიტს უნდა ჩაეტიოს. ის ფასიანია მანამ, სანამ ჩართულია.
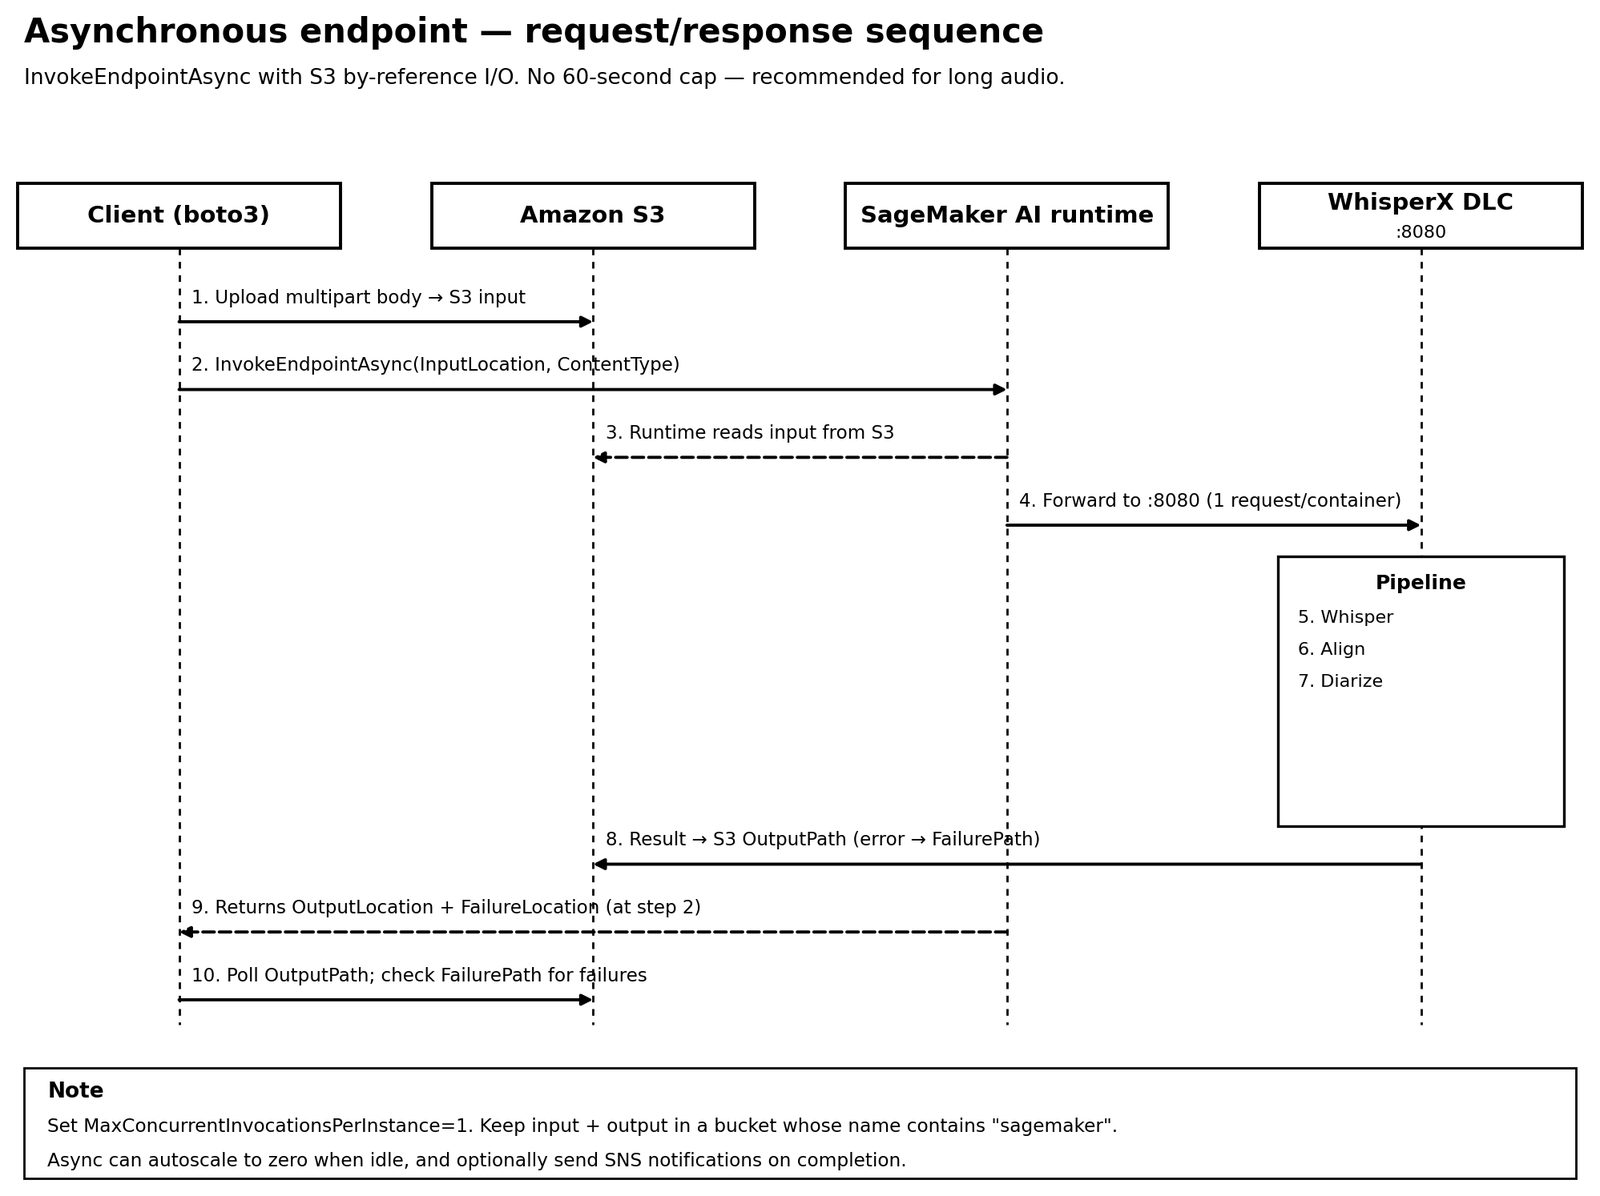
ასინქრონული endpoint აუდიოს Amazon S3-ში ატვირთავს, InvokeEndpointAsync-ს ობიექტის ბმულით იძახებს და შედეგს გამოტანის გზაზე ელოდება, წარუმატებელი დავალებისთვის კი ცალკე failure გზაა. პასუხის ლიმიტი არ არსებობს, ამიტომ გრძელი ჩანაწერებისა და დიდი პარტიებისთვის AWS სწორედ ამ ვარიანტს გირჩევთ, უმოქმედობისას კი endpoint ნულამდე მცირდება.
წარმოების დეტალები და Flight 1549-ის ტესტი
ორივე ვარიანტს ერთი და იგივე პარამეტრები სჭირდება: ხარჯისთვის ml.g4dn.xlarge, მეტი რესურსისთვის ml.g5.2xlarge და GPU AMI-ის al2-ami-sagemaker-inference-gpu-3-1 ვერსიაზე მიბმა, რომლის გარეშე CUDA 12.8-ის იმიჯი CannotStartContainerError-ს აბრუნებს ცარიელი ლოგით. ერთ კონტეინერზე ერთი მოთხოვნა მუშავდება, ამიტომ გამტარობა ინსტანციებით იზრდება, ასინქრონული რეჟიმის S3 bucket-ის სახელში კი სიტყვა sagemaker უნდა იყოს.
საჩვენებელი notebook US Airways Flight 1549-ის რადიოსაუბრის საჯარო ჩანაწერს ამუშავებს, 2009 წლის გადაუდებელი დაშვების ისტორიიდან, ხმაურითა და სწრაფი კოდებით სავსეს. სამი წუთი ასინქრონულ endpoint-ს გადაეცემა, 40 წამი კი რეალური დროისას. AWS ასევე აღნიშნავს, რომ SNS-ის შეტყობინებები ხშირ polling-ს სჯობს, ინსტანციების pool ხუთ ტიპამდე მუშაობს, პირადი ინფორმაცია კი სიტყვების დონის დროის ნიშნებით იფილტრება. GPU endpoint ფასიანია გაუქმებამდე.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.