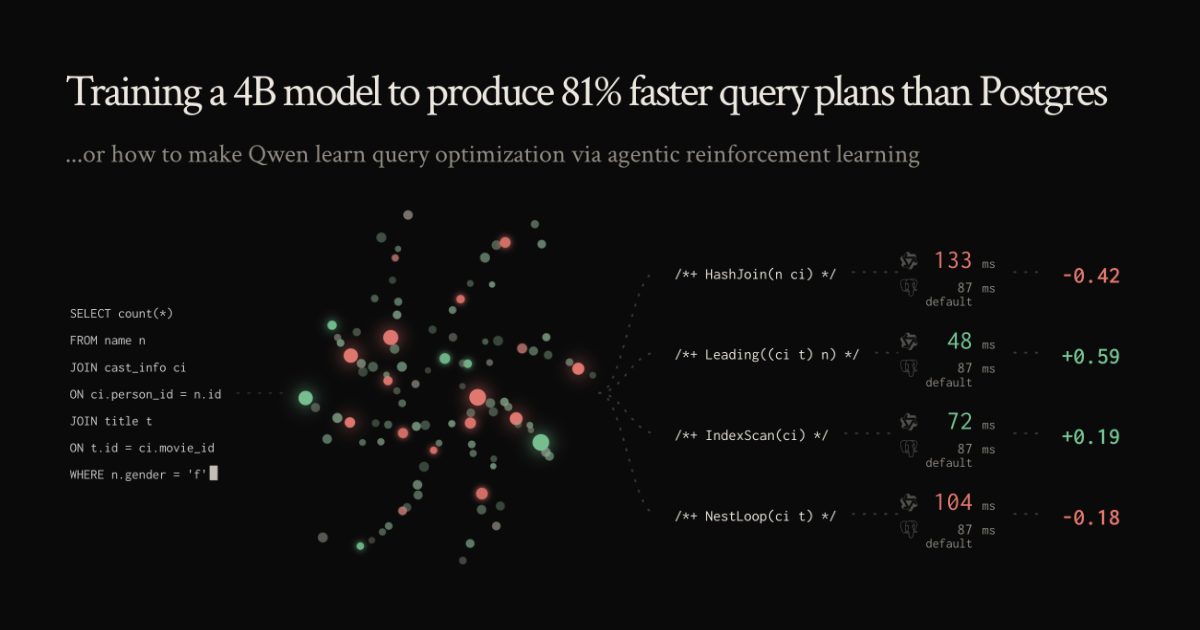
RL-ით გაწვრთნილი 4B მოდელი Postgres-ზე 81%-ით სწრაფ გეგმებს აწარმოებს
როჰან ბანსალმა 4-მილიარდიანი ღია მოდელი გაწვრთნა, რომელიც PostgreSQL-ის ოპტიმიზატორს pg_hint_plan-ის მინიშნებებით მართავს. 113 სამფეხა შეერთების მოთხოვნაზე ჯამური დაყოვნება 44.7%-ით შემცირდა.
პატარა მოდელი Postgres-ის ოპტიმიზატორის წინააღმდეგ
როჰან ბანსალმა გამოაქვეყნა ექსპერიმენტი, რომელიც აჩვენებს, რომ პატარა, ღია წონების ენობრივი მოდელი შეიძლება ისე გაწვრთნას, რომ PostgreSQL-ისთვის უკეთესი მოთხოვნის გეგმები შექმნას, ვიდრე თავად ბაზა აკეთებს. Join Order Benchmark-ზე (JOB) — 113 შეერთებებით დატვირთული SQL მოთხოვნა IMDb-ის მონაცემებზე — გაწვრთნილმა 4B მოდელმა, საუკეთესო კანდიდატის არჩევისას, გეომეტრიული საშუალოთი 1.81x სიჩქარის მატება მიაღწია, ხოლო მთელი დატვირთვის ჯამური დაყოვნება 44.7%-ით შემცირდა. იმავე checkpoint-მა 68 მოგება და ნულოვანი რეგრესია დააფიქსირა.
საწყისი მდგომარეობა ნუგეშისმცემელი არ იყო: გაუწვრთნელ მოდელს 113 მოთხოვნიდან 99-ისთვის გამოსადეგი გეგმა ვერ შეექმნა და მხოლოდ 14 ცდამ გამოიღო ვალიდური კანდიდატი. ავტორის არგუმენტია, რომ მოთხოვნების ოპტიმიზატორები რთულია — შეერთებების თანმიმდევრობის ამოცანა NP-რთულია, პლანერი კი კარდინალობას სტატისტიკით აფასებს და არა რიგების დათვლით — თუმცა გეგმის შემოწმება მარტივია, რადგან ერთადერთი კრიტერიუმი შესრულების დროა. სწორედ ეს ასიმეტრია ხდის ამოცანას გაძლიერებითი სწავლისთვის მოსახერხებელს.
მინიშნებები, გარემო და დისტილაცია
მოდელი პლანერს არ ცვლის — ის მას მართავს. ბანსალმა გამოიყენა pg_hint_plan, მესამე მხარის გაფართოება, რომელიც SQL კომენტარებში სტრუქტურირებულ მინიშნებებს იღებს, და ააგო ექვსინსტრუმენტიანი აგენტური გარემო qo-agent. აგენტი ათვალიერებს ცხრილებს, კითხულობს ნაგულისხმევ გეგმას და აგზავნის კანდიდატ გეგმის მოქმედებებს; თითოეული კანდიდატი სრულდება და დროის მიხედვით ედარება ნაგულისხმევ გეგმას.
ვარჯიში ორ ეტაპად წარიმართა. თავდაპირველად — ზედამხედველობითი დახვეწა off-policy დისტილაციით, 500 GPT-6 Astra აგენტური ტრაექტორიიდან, სადაც განახლდებოდა მხოლოდ 42.5 MB-იანი LoRA ადაპტერი 21.2 მილიონი ვარჯიშვადი პარამეტრით 4.66-მილიარდიანი Qwen-ის წარმოებულზე. ორმა ეპოქამ შედეგი გააუმჯობესა, მესამემ კი გააუარესა, მიუხედავად იმისა, რომ ვალიდაციის დანაკარგი აღარ იცვლებოდა.
ჯილდოები ხმაურიან გარემოში
მეორე ეტაპი აგენტური გაძლიერებითი სწავლა იყო GRPO-ს მოდიფიცირებული ვარიანტით. სიჩქარის კოეფიციენტი ითვლებოდა როგორც სამი ნაგულისხმევი გაზომვის მედიანის შეფარდება სამი კანდიდატის გაზომვის მედიანასთან, და საზომი სტენდი განსაკუთრებით ფრთხილად უნდა აშენებულიყო: ერთ მანქანაზე გაშვებული ოთხი PostgreSQL კონტეინერი ქმნის page cache-ის კონკურენციას, რაც გაზომვებს ამახინჯებს. ვარჯიში ორ ადგილზე გაიყო — vLLM და trainer დაქირავებულ 2x H100 კვანძზე, ბაზის კონტეინერები კი ავტორის მაგიდაზე. ჯილდოს საწყისი ფორმულირება მოდელს Postgres-ის ნაგულისხმევ გეგმისკენ უბიძგებდა; გამოსავალი იყო rollout-ების ერთმანეთთან შედარება აბსოლუტური ქულების ნაცვლად.
რა ისწავლა მოდელმა
1200 განახლების შემდეგ მიღებული checkpoint-ის ანალიზი აჩვენებს, რომ ძიებათა უმეტესობა ჯერ ცხრილს, სვეტის სტატისტიკას ან ნაგულისხმევ გეგმას ამოწმებდა. პროექტი დაახლოებით 1200 დოლარი დაჯდა: 2x H100 კვანძის დაახლოებით 95 საათი Lambda-ზე და 400 დოლარი OpenAI-ის API-ის საფასური დემონსტრაციის ტრაექტორიებისთვის. ბანსალის დასკვნა არ არის, რომ დიდი მოდელები მოძველდა — პირიქით, Astra-დან დისტილაციაა მიზეზი, რომ პატარა მოდელი საერთოდ მუშაობს — არამედ ის, რომ პატარა მოდელები სერიოზულ ყურადღებას იმსახურებენ ვიწრო და ადვილად შემოწმებად ამოცანებში.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.