Databricks-ის Lakebase: როგორ იშლება კედელი OLTP-სა და OLAP-ს შორის
HackerNoon-ზე გამოქვეყნებული ანალიზის ავტორის აზრით, Databricks-ის Lakebase — ღია lakehouse-ზე აგებული serverless Postgres — აუქმებს OLTP-სა და OLAP-ს შორის სამი ათწლეულის განმავლობაში არსებულ განცალკევებას და AI აგენტებს მუდმივი მდგომარეობის საცავს აძლევს.
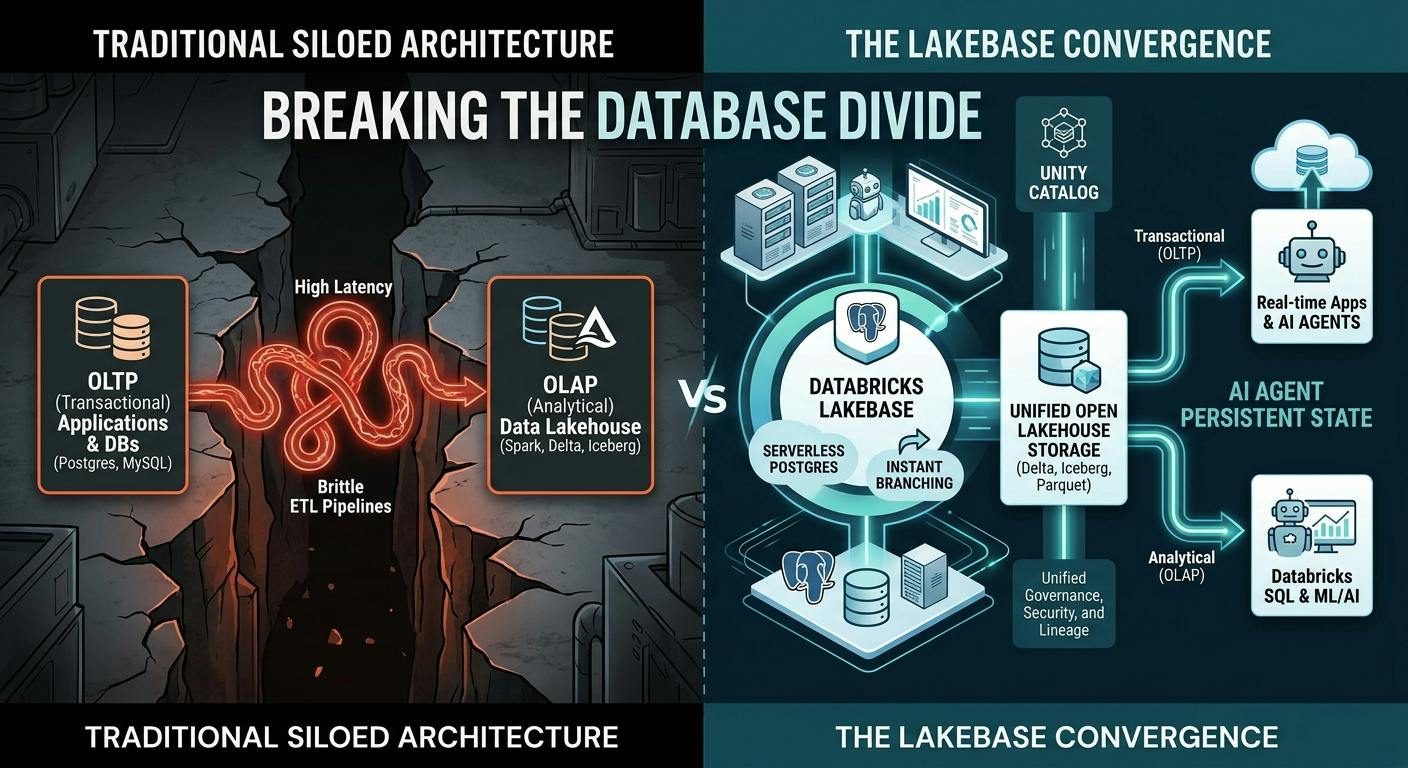
სამი ათწლეულის განმავლობაში კორპორაციული მონაცემთა არქიტექტურა მკაცრ შრომის დანაწილებას ექვემდებარებოდა: ტრანზაქციული სისტემები — PostgreSQL, MySQL და Oracle — დაბალი შეყოვნებით აპლიკაციის მდგომარეობას ამუშავებდნენ, ანალიტიკური ძრავები — Apache Spark, Snowflake და Delta Lake — ისტორიულ მონაცემებს ინახავდნენ და მძიმე ტრანსფორმაციებს ასრულებდნენ.
მათ შორის მყიფე და ძვირი ETL პაიპლაინები რჩებოდა: კომპანიები ოპერაციული მონაცემების ანალიტიკურ lakehouse-ში გადასატანად რთულ სინქრონიზაციას აშენებდნენ, შემდეგ კი feature მონაცემების აპლიკაციებში დაბრუნებას უჭირდათ. HackerNoon-ზე გამოქვეყნებულ ანალიზში ავტორი ამტკიცებს, რომ Databricks-ის Lakebase — Neon ტექნოლოგიაზე დაფუძნებული ოპერაციული serverless Postgres ღია lakehouse-ზე — სწორედ ამ კედელს ამსხვრევს.
მონაცემთა ბაზების მესამე თაობა
ავტორი Lakebase-ს ახალ კატეგორიად განიხილავს და არა რიგით კიდევ ერთ managed Postgres ინსტანციად. ადრინდელი ბაზები მონოლითები იყო ან საცავს კერძო ფორმატში ინახავდნენ. Lakebase მესამე თაობად არის აღწერილი: ღია ფორმატის საცავი ტბაზე, serverless და ეფემერულ Postgres გამოთვლასთან ერთად.
დაშტოება, scale-to-zero და zero-ETL
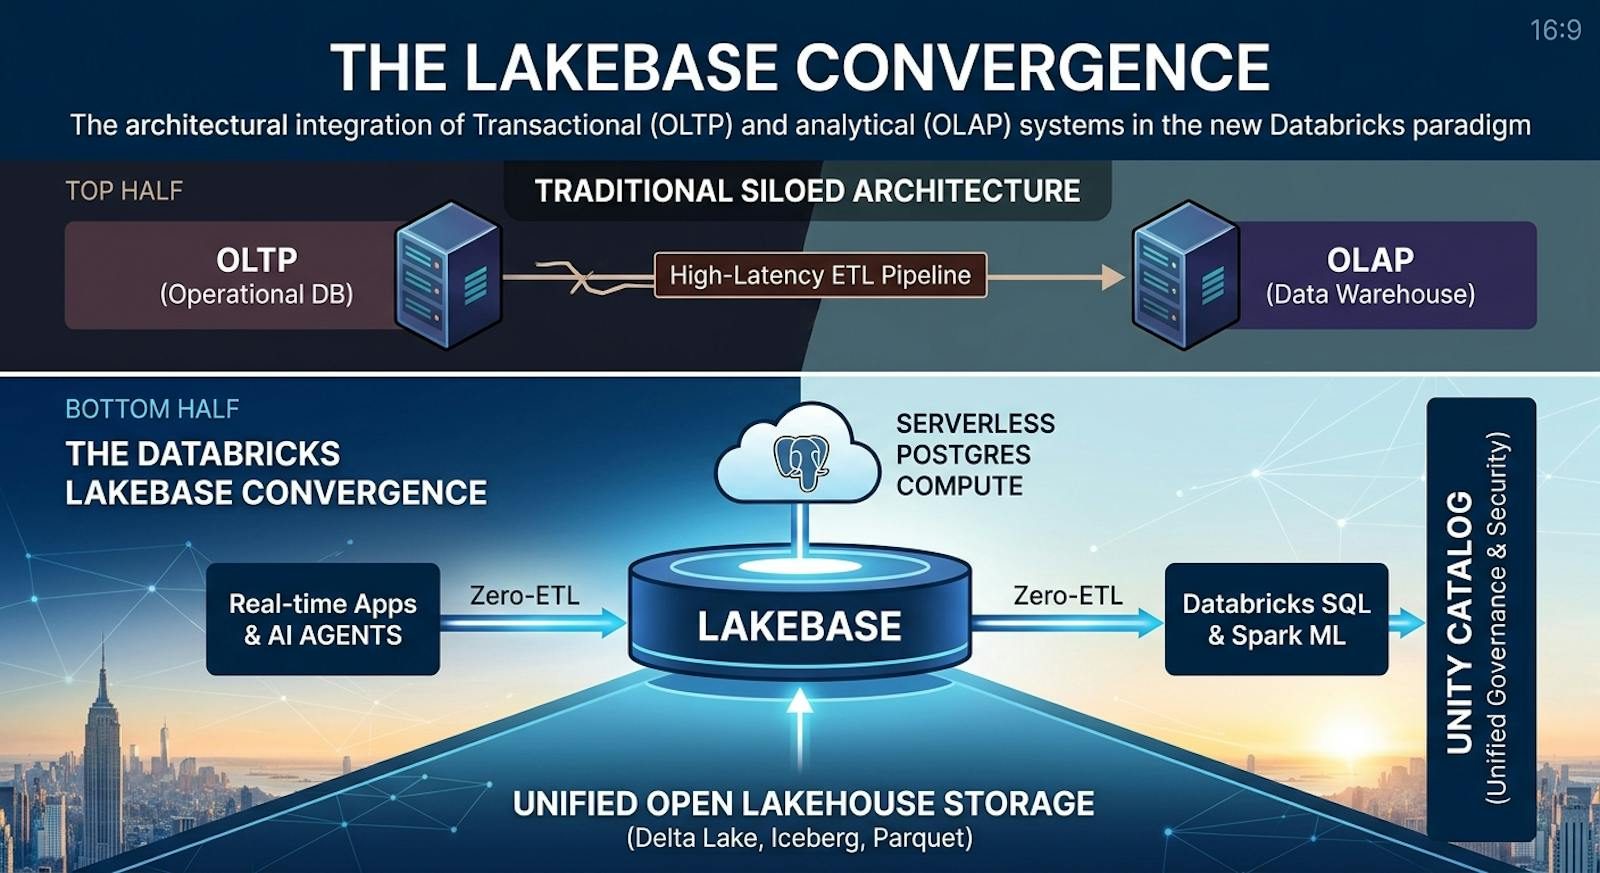
სამი თვისება გამოირჩევა. copy-on-write დაშტოება სრულფასოვან, იზოლირებულ კლონებს მილიწამებში ქმნის იმ საათების ან დღეების ნაცვლად, რაც production მონაცემების კლონირებას სჭირდება — დეველოპერებსა და AI აგენტებს გარემოს მყისიერად გაშვება და წაშლა შეუძლიათ.
გამოთვლის გამოყოფა ინსტანციებს წამზე ნაკლებ დროში ჩართვის და უქმად ყოფნისას ნულამდე ჩამოშლის საშუალებას აძლევს, რაც აგენტების პიკურ დატვირთვებს მოხმარებაზე დაფუძნებულ მოდელზე გადაიყვანს. რადგან ტრანზაქციული მონაცემები lakehouse-ისთვის წაკითხვად ფორმატში იწერება, ანალიტიკისთვის ან LLM-ებისთვის feature store-ის კვებაზე CDC და ETL პაიპლაინები აღარ სჭირდება: Spark, Databricks SQL და Delta Lake ცოცხალ მონაცემებს პირდაპირ იკითხავენ.
რას ნიშნავს ეს მონაცემთა და AI ინჟინრებისთვის
ერთიანი მმართველობის პირობებში ტრანზაქციული და ანალიტიკური ცხრილები Unity Catalog-ის მეშვეობით ერთსა და იმავე წვდომის კონტროლს, უსაფრთხოების პოლიტიკასა და lineage მონიტორინგს ექვემდებარება. ავტორი AI აგენტების მეხსიერებასაც გამოყოფს: აგენტებს სჭირდებათ მდგომარეობის მართვა, ვექტორული ძიება pgvector-ით და სწრაფი ტრანზაქციული მოთხოვნები.
დასკვნა მიმართულებაა და არა მზა პროდუქტი: როცა კომპანიები მარტივი ML ინფერენსიდან ავტონომიურ აგენტებზე გადადიან, ბაზაც უნდა განვითარდეს — ღია, რეალური დროის, serverless და AI-ნატიური პლატფორმებისკენ.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.