„თქვენი ლოკალური LLM უფრო ჭკვიანია, ვიდრე გგონიათ“ — როგორ კარგავს ხარისხს ინფერენსის სტეკი
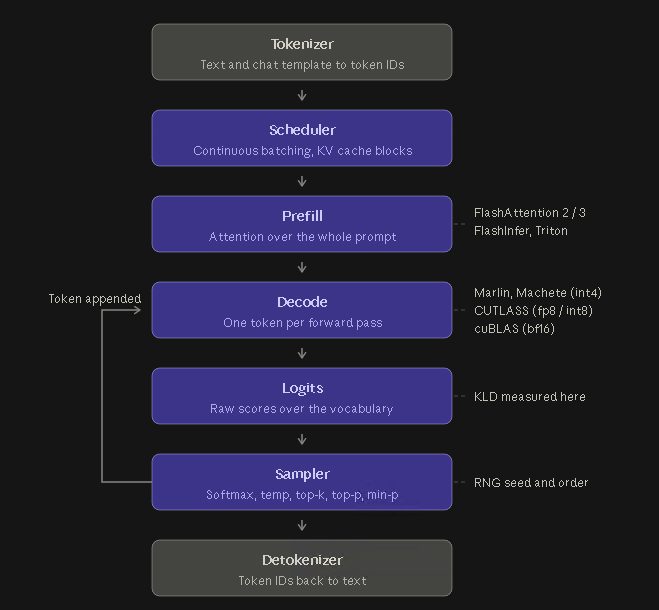
Level1Techs-ის ფორუმზე გამოქვეყნებული ექსპერიმენტების სერია აჩვენებს, რომ ლოკალური მოდელის „სისულელე“ ხშირად attention backend-ის, KV cache-ის კვანტიზაციისა და პარალელიზაციის ბრალია, და არა მოდელის.
Level1Techs-ის ფორუმზე გამოქვეყნებული ექსპერიმენტების სერია აჩვენებს, რომ ლოკალურად გაშვებული მოდელი ხშირად უფრო სუსტი ჩანს, ვიდრე სინამდვილეშია — და მიზეზი ხშირად თავად ინფერენსის სტეკია, არა მოდელი. თემის ავტორი, მომხმარებელი thr3e, აღწერს ტესტებს, რომლებშიც ერთი და იმავე წონების მქონე მოდელი სხვადასხვა runtime-ის პარამეტრით განსხვავებულ შედეგს იძლევა.
ყველა იმპლემენტაცია განსხვავდება
ავტორის თქმით, „რეფერენს იმპლემენტაცია“ — ეს არის ლაბორატორია, რომელიც მოდელს აქვეყნებს და პირველად თვითონ ჰოსტავს. მისი ტექნიკა და პროგრამული უზრუნველყოფა განსხვავდება თქვენისგან, ხოლო სახლის პირობებში ხშირად სხვადასხვა თაობის GPU-ები ერთ სისტემაში მუშაობს: ჩიპების ინსტრუქციათა სიმრავლეები მათემატიკას ერთი და იმავე წონებზეც კი სხვანაირად ითვლიან. ტესტებში გამოყენებულ vLLM-ის nightly კონტეინერს 734 პაკეტი ჰქონდა, მათგან 252 Python პაკეტი — ანუ 734 კოდური ბაზა საკუთარი შეცდომებით.
სამი ტესტი: backend-ები, KV cache, კვანტიზაცია
პირველ ტესტში შეადარეს სამი attention backend — FlashAttention 2, Flash Inference და Triton Attention — Qwen3.6-27B-ის BF16 ვერსიაზე RTX PRO 6000 Blackwell-ზე. სხვა ყველაფერი ერთი და იგივე იყო, ხოლო დატვირთვად გამოიყენეს რეალური სამუშაო ნაკადის ~100 ათასი token-ის კონტექსტი tool call-ებით. პირველი რამდენიმე ათასი token-ის განმავლობაში ყველა backend ერთმანეთს ეთანხმებოდა, შემდეგ დაიწყო განსხვავებები; ერთიდაიმავე backend-ის განმეორებითი გაშვებები ბიტ-ბიტ იდენტური იყო — ანუ განსხვავება მათემატიკიდან მოდის და არა შემთხვევითობიდან.
მეორე ტესტში მხოლოდ KV cache-ის კვანტიზაცია შეიცვალა: int8 ვერსია შეცდომას აღადგენდა, int4 — ვერა. მესამეში ხუთი წონითი კვანტიზაცია შეადარეს ერთმანეთს: INT8 W8A16 საუკეთესო აღმოჩნდა, ხოლო NVIDIA-ს NVFP4 ბოლო ადგილზე — 88 ათას token-ის კონტექსტზე token-ების დაახლოებით 50% „გადაბრუნდა“. NVFP4-მა და AWQ W4A16-მა Cisco-ს მოწყობილობაზე არასწორი ბრძანება გაუშვეს — ამოქმედდა show run იქ, სადაც საჭირო იყო show arp.
ერთი token-ის გადაბრუნება, ერთი ჩავარდნილი დავალება
მეორე ნაწილში ავტორმა tool call-ების დროს მთელი logits-ები ჩაიწერა და diverging გაშვებები გაანალიზა. ერთ შემთხვევაში FlashAttention 2-ის გამო მოდელმა GigabitEthernet0/1/4 მიუთითა GigabitEthernet0/0/1.201-ის ნაცვლად და შემდეგ show mac address table-ის ნაცვლად ისევ show run შეასრულა; სხვა შემთხვევაში ინტერფეისის აღწერა ვერ დაყენდა. ტენზორული პარალელიზაციის ტესტში TP1-ზე დავალება შესრულდა, TP2-ზე ჩავარდა, TP4-ზე კვლავ შესრულდა — ავტორის აზრით, ხშირად მიზეზი NCCL-ია.
როგორ გავზომოთ სწორად
ავტორის რეკომენდაციაა ისეთი ბენჩმარკები, რომლებიც რეალურ დატვირთვას შეესაბამება: temperature-ის ნულზე დაწევა და სამი სატესტო პრომპტი არ არის აგენტური ამოცანების კარგი ანალოგი — საჭიროა ხანგრძლივი კონტექსტის tool calling და დომენური ცოდნის ტესტები. ასევე მნიშვნელოვანია მოდელის ბარათში მითითებული sampler-ის პარამეტრები და chat template; ძალიან დაბალი temperature იწვევს მოდელის „ჩარჩენას“ THINK-ის გამოტანაში. KLD მეტრიკაზე კი ფორუმის მონაწილეები აღნიშნავენ, რომ ის დისტრიბუციის ცვლილებას ზომავს და არა სისწორეს: BF16 არის სიზუსტის რეფერენსი, არა „ორაკული“, და დაბალი KLD ავტომატურად „ჭკვიანს“ არ ნიშნავს.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.