ეფექტური C++ კოდის წერა: რას წყვეტს მონაცემების განლაგება მეხსიერებაში
პროგრამისტი Adam Sawicki ხსნის, რატომ არ არის საკმარისი მხოლოდ C++-ის არჩევა: წარმადობას წყვეტს მონაცემების განლაგება მეხსიერებაში, ქეშის გამოყენება და ალოკაციის ხარჯი. სტატია 2013 წელს, პოლონურ ჟურნალ Programista-ში გამოქვეყნდა.
სწრაფი პროგრამისთვის C++-ის არჩევა თავისთავად საკმარისი არ არის. სტატიაში „Writing Efficient C++ Code“ პროგრამისტი Adam Sawicki ხსნის, რა წყვეტს, რამდენად კარგად იყენებს კოდი აპარატურას: როგორ ლაგდება მონაცემები მეხსიერებაში და რამდენად ხშირად ელოდება პროცესორი ქეშს. ტექსტი პირველად, 2013 წელს, პოლონურ ჟურნალ Programista-ში დაიბეჭდა.
C++ თავისთავად სიჩქარეს არ იძლევა
C++ მაღალი დონის ენაა ობიექტზე ორიენტირებული დიზაინისა და მზა კონტეინერებისთვის, მაგრამ ამავდროულად საკმარისად დაბალი დონისაა, რომ კოდსა და ოპერაციულ სისტემას შორის არც ვირტუალური მანქანა დგას და არც garbage collector: მეხსიერებას პროგრამისტი ათავისუფლებს.
მონაცემებზე ორიენტირებული დიზაინი
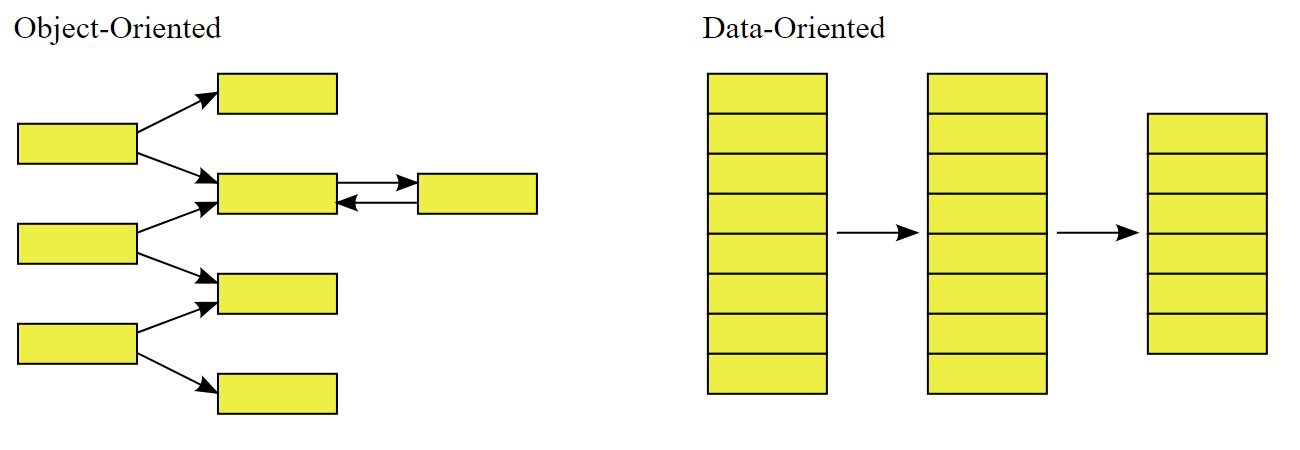
Data-Oriented Design, რომელიც თამაშების დეველოპერებში გავრცელდა, ჯერ მონაცემებით იწყება: როგორ განლაგდება ისინი მეხსიერებაში და რომელი სტრუქტურები შეინახავს, ალგორითმები კი შემდეგ ირჩევა. მიდგომა კლასებს არ კრძალავს, მაგრამ აფრთხილებს მეხსიერებაში მიმოფანტული და მაჩვენებლებით დაკავშირებული ბევრი პატარა ობიექტის წინააღმდეგ: ასეთი განლაგება ხშირად აიძულებს პროცესორს RAM-ს მიმართოს და პარალელიზაციას ართულებს. რეგულარული მასივი, პირიქით, ელემენტ-ელემენტ მუშავდება და მისი დიაპაზონი ნაკადებზე ადვილად ნაწილდება.
მეხსიერების იერარქია ფასს განსაზღვრავს
3 გჰც სიხშირის პროცესორზე ერთი არითმეტიკული ოპერაცია დაახლოებით 0,33 ნანოწამს იკავებს, ანუ ერთ ციკლს. L1 ქეშში მყოფი მნიშვნელობა დაახლოებით 1 ნანოწამში იკითხება, L2-ში 4,7-ში, ხოლო RAM-ში 83 ნანოწამში, რაც 250 ციკლის ტოლია. მონაცემები 64-ბაიტიანი ხაზებით გადაადგილდება, ამიტომ ერთად გამოსაყენებელი მნიშვნელობები მეხსიერებაში ერთმანეთის გვერდით უნდა იდოს.
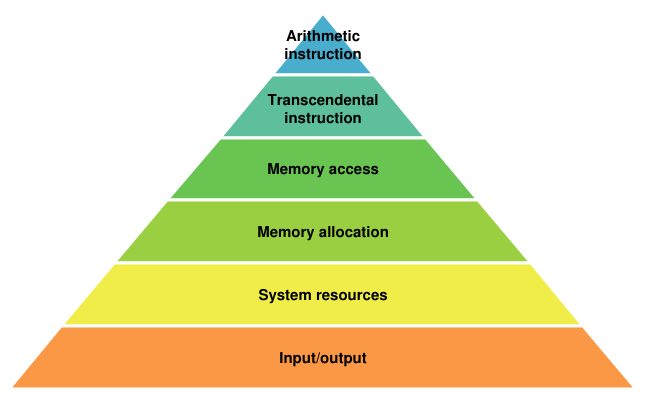
ამიტომ უწყვეტ სტრუქტურებს, როგორიცაა ჩვეულებრივი მასივი ან STL-ის vector, უპირატესობა აქვს დაკავშირებულ სიებთან და ხეებთან. სტატია აღწერს წარმადობის პირამიდას: ყველაზე სწრაფი არითმეტიკაა, ტრანსცენდენტული ოპერაციები, მაგალითად სინუსი ან გაყოფა, გაცილებით ნელია, RAM-ზე წვდომა ქეშის გამოტოვების შემდეგ ასობით ციკლია, დინამიკური ალოკაცია ძვირი, შეტანა-გამოტანა კი ყველაზე ნელი.
AOS, SOA და კომპილატორის საზღვრები
ნაწილაკების სისტემა ამ არჩევანს ნათლად აჩვენებს. Array of Structures თითოეული ნაწილაკის პოზიციას, სიჩქარესა და ფერს ერთად ინახავს, Structure of Arrays კი თითოეული თვისებისთვის ცალკე მასივს ქმნის: ასე ერთ ციკლში საჭირო მნიშვნელობები ახლოს რჩება, გამოუყენებელი ველები კი ქეშში არ შედის.
კომპილატორი ყველაფერს ვერ ასწორებს. როცა მაჩვენებელს მასივის ელემენტებზე მითითება შეუძლია, მნიშვნელობა ყოველ გამეორებაზე თავიდან იკითხება, რასაც ლოკალურ ცვლადში კოპირება ან __restrict ხსნის. STL-ის string-ის ციკლიდან გატანამ და ყოველ ჯერზე გასუფთავებამ ტესტი 0,36 წამიდან 0,27 წამამდე შეამცირა, ანუ 25%, რადგან ობიექტი ალოკირებულ ბუფერს ინახავს.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.