AMD, MEXT'in yarı DRAM ile sunucu performansının %95'ini koruyabileceğini söylüyor
AMD, MEXT'in soğuk sayfaları flaşa taşıyıp yapay zekâyla geri getirerek sunucu DRAM kullanımını %20-%75 azaltabileceğini ve performansın çoğunu koruyabileceğini söylüyor. 145 sunucuda dağıtım yapıldı; gelecek yıl 2.000'e ulaşılacak.
AMD, öngörülü bir bellek motoru olan MEXT'in sunucularda gereken fiziksel DRAM'i azaltırken performansın büyük kısmını koruyabileceğini açıkladı. MEXT, tam DRAM'li bir sistemin performansının %99'undan fazlasını sunduğunu iddia ediyor ve bunu fiziksel DIMM'lerin yalnızca %25'iyle çalışırken başarıyor. Teknoloji soğuk bellek sayfalarını flaş depolamaya taşır ve gerektiğinde geri getirmek için bir yapay zekâ modeli kullanır.
MEXT belleği flaşa nasıl taşır
MEXT, soğuk bellek sayfalarını flaş depolamaya boşaltır; eksik kalan bellek yine de işletim sistemine kurulu DRAM olarak kaydedilir. Flaş DRAM'dan daha yavaş olduğu için MEXT, hangi sayfaların gerekeceğini öngörmek ve bunları gereksinim duyulmadan önce geri taşımak için bir yapay zekâ modeli kullanır. AMD, modelin ilk dağıtımda bir saniyeden kısa sürede eğitilebildiğini, GPU olmadan tek bir EPYC çekirdeğinde çalıştığını ve iş yükü ilerledikçe eğitime devam ettiğini söylüyor. MEXT, herhangi bir Linux dağıtımıyla çalışan bir Linux çekirdek modülü olarak dağıtılır ve başında transformer tabanlı büyük dil modeli bulunan bir yapay zekâ modeli topluluğu kullanır.
AMD'nin iç performans iddiaları
Synopsys PrimeTime gibi bazı iç iş yüklerinde AMD, %50 DRAM kapasitesinde çalışan sunucuların tam sunucunun performansının %95'ini koruduğunu, %25 kapasitenin ise %80 performans sağladığını söylüyor. 5. nesil EPYC CPU'lu üç düğümlü bir Azure kümesinde AMD, TPC-DS kıyaslamasının Spark SQL iş yükünde %50 DRAM kapasitesinde tam küme performansının %99'unu sunduğunu söylüyor. Ajan tabanlı yapay zekâ için AMD, beş ajanın eşzamanlı çalıştığı durumda geometrik ortalama üzerinden %50 bellek kapasitesinde tam sunucu performansının %99'unu, %25 kapasitede ise %85'ini iddia ediyor. Bellek açısından aç bir ajan için AMD, %50 kapasitede %90 performans ve %25 kapasitede %88 performans iddia ediyor.
Dağıtım ve yaygınlaştırma
AMD, MEXT'i dahili olarak 145 sunucuda dağıttı ve gelecek yıl 2.000 sunucuya genişleteceğini söylüyor. Ayrıca MEXT'i müşterilere getirmek için HPE ile ortaklık duyurdu. 1. Aşama, boşaltma için ayrılmış bir NVMe sürücüsü veya yuvası ile MEXT Ready rozeti taşıyan bazı EPYC Venice sunucularını içerir. 2. Aşama bu sunuculara MEXT lisanslarını ve RAM View uygulamasını getirecek, ancak AMD 2. Aşamanın ne zaman başlayacağını söylemedi.
İş yükleri ve sınırlar
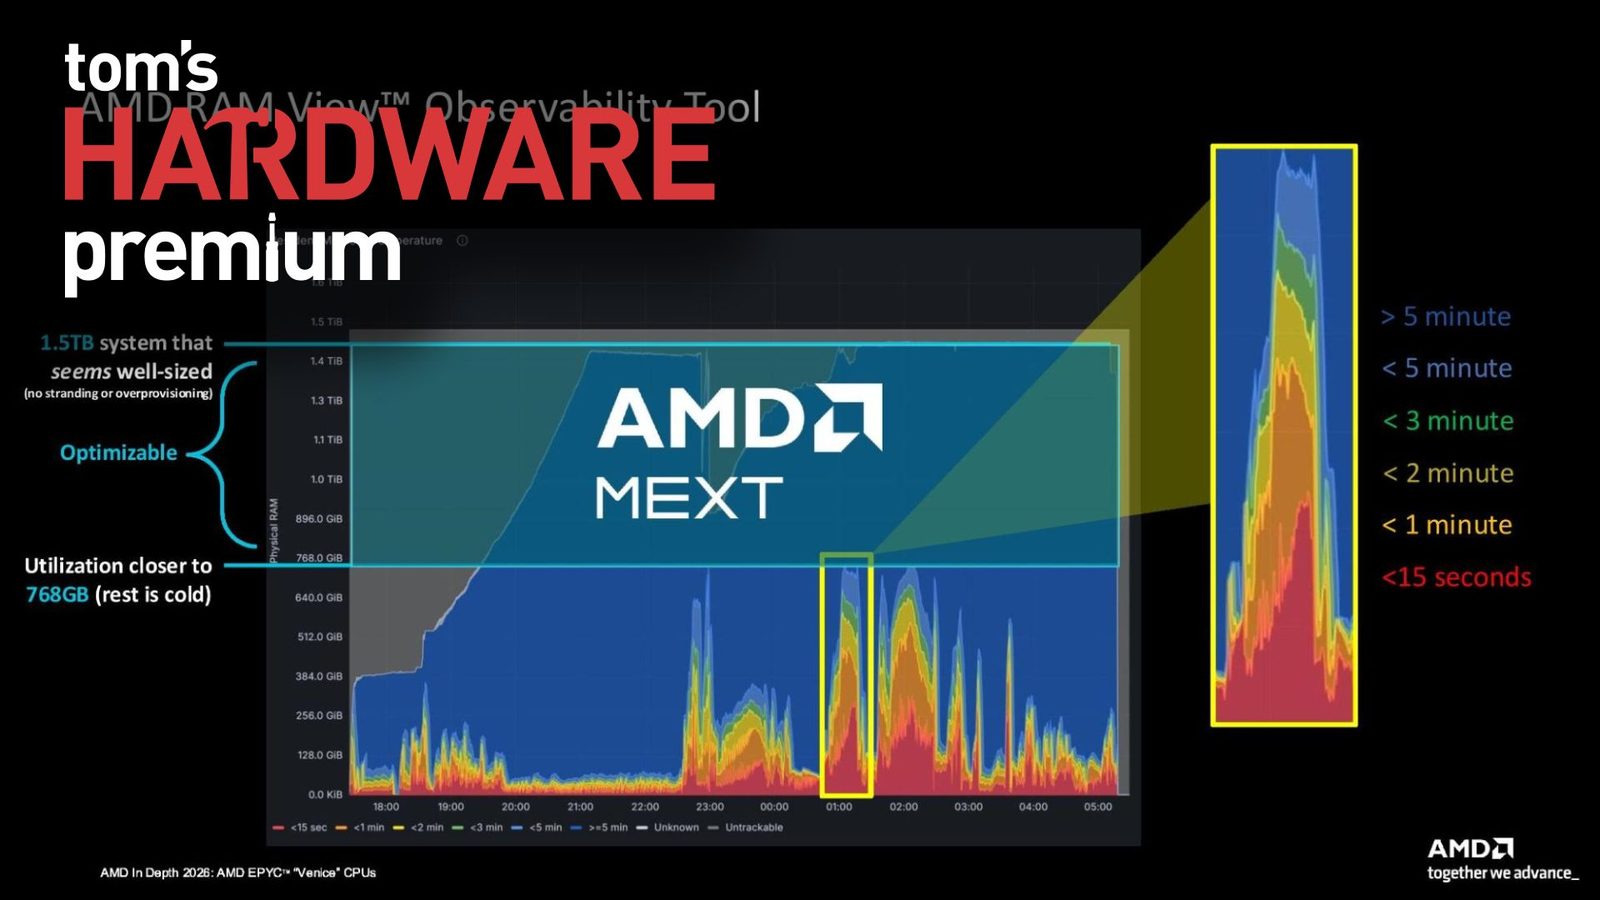
AMD başlangıçta dahili olarak kullandığı kritik EDA uygulamalarına, Synopsys PrimeTime dahil, MEXT uyguluyor; ayrıca ajan tabanlı yapay zekâ, veritabanı ile medya ve eğlence iş yüklerini de optimize ediyor. Şirket birçok iş yükünün kapasiteyi yaklaşık %20 ile %25 azaltabildiğini, daha büyük azaltmalarda uygulamaların daha uzmanlaşmış hale geldiğini ve performans farklarının büyüdüğünü söylüyor. AMD, RAM View'in hangi sayfaların sıcak ve soğuk olduğunu gösterdiğini; genelleştirilmiş bir örnekte 1,5 TB belleğe sahip bir sistemin neredeyse tam kullanım gösterdiğini, herhangi bir anda sayfaların yaklaşık yarısına beş dakika veya daha uzun süre dokunulmadığını söylüyor. AMD bu örnek için iş yükünü netleştirmedi ve bazı kıyas slaytları için dipnot paylaşmadı.
Kaynaklar: Tom's Hardware · The Register
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.