Cerebras, Trilyon Parametreli AI Modellerini Wafer-Ölçekli Çiplere Nasıl Dağıttığını Açıklıyor
Cerebras, büyük sınır modellerini WSE-3T waferları arasında nasıl böldüğünü, Kimi K3 örneğiyle çip içi bellek, işlem hattı ve eşzamanlı istek yönetimini anlatıyor.
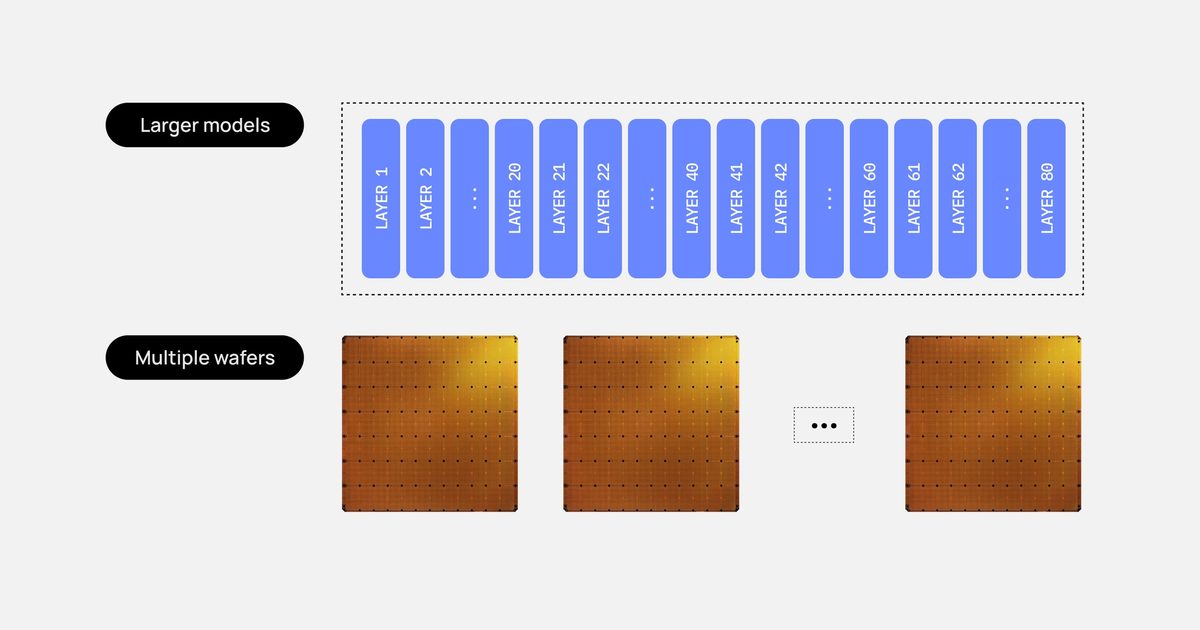
Cerebras, trilyon parametreli sınır modellerini kendi wafer-ölçekli çipleri üzerinde nasıl dağıttığını açıklayan bir yayın yaptı. Tek bir Cerebras WSE-3T waferı 44 GB çip içi belleğe sahiptir, halbuki trilyon parametreli modeller yalnızca ağırlıkları için terabaytlar gerektirir. Şirket, büyük bir modeli birden fazla WSE-3T waferı arasında bölerek, çoklu trilyon parametreli modelleri saniyede 1000-2000+ token hızında çalıştırdığını belirtiyor.
Kimi K3 örneği olarak
Cerebras, açık kaynaklı Kimi K3 modelini illüstratif bir örnek olarak kullanıyor. Kimi K3 yaklaşık 3 trilyon parametreye, 69 linear-attention katmanına ve 24 dense katmanına sahiptir. Cerebras, Kimi K3'ün Terminal-Bench 2.1'de %88.3, GPT-5.6 Sol ise %88.8; BrowseComp'te %91.2, GPT-5.6 Sol ise %90.4 puan aldığını söylüyor. Cerebras, bu sonuçların modelin kodlama ve agentik yeteneklerde frontier düzeyinde performans gösterdiğini, bazı kıyaslamalarda önde gelen tescilli modelleri geçtiğini ifade ediyor.
Örnek için Cerebras, ortalama 256k istek boyutu, 4-bit ağırlık nicemlemesi ve 8-bit KV önbelleği varsayıyor. Her model katmanının boyutunu hesaplıyor, ardından modeli 93 katmana bölüyor. Sonuç her katman için yaklaşık 16 GB oluyor.
Katmanları Waferlara Eşleme
Her WSE-3T waferının 44 GB kapasitesi, bir wafera kaç katmanın sığacağını belirler ve cevap katman türüne bağlıdır. Yoğun (dense) katmanlar, her yoğun tam-dikkat katmanı her etkin istekteki her token için anahtar ve değer sakladığı için KV önbelleği için ek alan gerektirir. Bu nedenle Cerebras, her wafera bir yoğun katman yerleştirir ve kalan SRAM'i onun KV önbelleği için ayırır.
Linear-dikkat (linear-attention) katmanları KV önbelleği için ek alan gerektirmez. Her token için anahtar ve değer saklamak yerine, bir linear-dikkat katmanı bağlam uzunluğundan bağımsız olarak istek başına küçük, sabit boyutlu bir durum tutar. Bu, wafer başına iki linear katman için yer bırakır: 2 x 16 GB = 32 GB. 69 linear katman ve 24 yoğun katman ile eşleme, linear katmanlar için 35 wafer, yoğun katmanlar için 24 wafer, toplam 59 wafer üretir.
İşlem Hattı Yürütme ve Eşzamanlılık
Cerebras modelleri bir işlem hattında (pipeline) yürütür. Derleyici model katmanlarını wafer bölgeleri arasında eşler ve çalışma zamanı tokenlerin waferlar arasında akması için yolu eşler. Yalnızca aktivasyonların waferlar arasında geçmesi gerekir ve bu, Ethernet üzerinden RDMA ile yaklaşık 2 mikrosaniyede bir atlama ile yapılabilir. Her wafer 44 GB çip içi SRAM'e ve her katman yaklaşık 16 GB'ye sahip olduğundan, bütün katmanlar genellikle çip üzerinde doğrudan sığar. Çoğu durumda model ağırlıkları hiç taşınmak zorunda kalmaz ve katmanlar waferlar arasında bölünmez.
Her wafer bir montaj hattındaki bir aşama gibi davranır. Örneğin, Wafer 1 katmanları 1-2'yi çalıştırır ve aktivasyonları Wafer 2'ye gönderir; Wafer 2 katmanları 3-4'ü çalıştırır ve sonuçları ileri iletir, son wafer bir sonraki tokeni üretir. Birçok isteği sunmak için Cerebras, işlem hattını farklı isteklerle dolu tutar. Her aşama aynı anda farklı bir istek üzerinde çalışabilir ve her aşama tek bir istek yerine bir mikro-partiyi (micro-batch) işleyebilir. Daha küçük mikro-partiler her isteği hızlandırırken, daha büyük mikro-partiler toplam iş hacmini artırır.
KV önbelleğine ayrılan çip içi bellek miktarı, eşzamanlı istek sayısının maksimumunu belirler. Uçuşta olan her istek, her yoğun-katman waferında kendi KV önbelleğine ihtiyaç duyar. Cerebras, eşzamanlılık ve parti boyutunun tek başına çıkarım verimliliğini göstermediğini; daha anlamlı bir metrik birim güç başına toplam token iş hacminin, aynı çıktı üretim hızı ölçülerek hesaplanması olduğunu belirtiyor.
Kaynaklar: cerebras.ai
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.