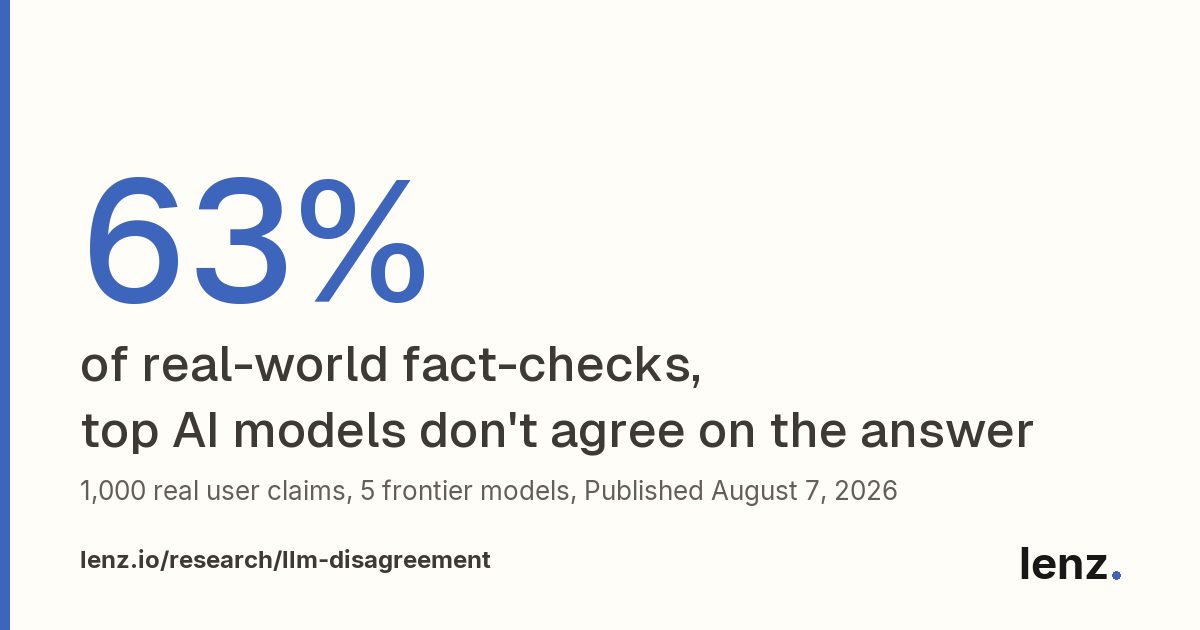
Araştırma: frontier LLM'ler gerçek doğrulamaların %67'sinde ayrışıyor
Lenz, beş üst düzey modele 1.000 gerçek kullanıcı iddiası verdi: iddiaların %67'sinde panel bölünüyor, %34'ünde kararlar arasındaki fark iki kademeye ve fazlasına çıkıyor — yani en az bir model yanılıyor.
Fact-checking platformu Lenz, önde gelen frontier dil modellerinin gerçek dünya doğrulamalarında ne sıklıkla anlaşmazlığa düştüğünü ölçen bir araştırma yayımladı. Şirket, kullanıcıların gönderdiği 1.000 güncel iddiayı beş üst düzey modele — GPT-5.4, Claude Opus 4.7, Gemini 3 Pro, arama destekli Gemini 3 Pro ve Perplexity'nin Sonar Pro'su — verdi ve her birinden dört karardan birini seçmesini istedi: doğru, çoğunlukla doğru, yanıltıcı veya yanlış.
İddiaların üçte ikisinde panel bölünüyor
İddiaların %67'sinde (1.000'de 672; %95 güven aralığı 64-70) en az bir model çoğunluk kararına katılmadı ya da hiç çoğunluk oluşmadı. İddiaların %34'ünde (343) en çok ayrışan ikili arasında iki veya daha fazla kademe fark vardı — bu, güven düzeyindeki kaymadan çok yanıtın kendisine ilişkin esaslı bir anlaşmazlık.
Modeller arası uyum kayda değer ama sınırlı çıktı: sıralı ölçekte Krippendorff alfası 0.639. Panel kesin kararlarda birleşiyor, ölçeğin ortasında ise dağılıyor: beş modelin de anlaştığı 328 iddianın yalnızca dördünde "yanıltıcı" kararında oybirliği vardı, "çoğunlukla doğru"da ise hiç yoktu.
Modeller nerede örtüşüyor
En yakın ikili, iddiaların %75'inde anlaşan Gemini 3 Pro ile arama destekli sürümüydü — yazarlara göre bu şaşırtıcı değil, çünkü aynı temel modeli paylaşıyorlar. En ayrışan ikililer %53 ile Claude Opus 4.7'nin iki Gemini sürümüne ve Gemini 3 Pro'nun Sonar Pro'ya karşı olduğu eşleşmelerdi. Modellerin panelin geri kalanıyla uyumu %69 ile %81 arasında değişiyor.
Her iddiada dört karardan yalnızca biri doğru olabileceği için araştırma hata için bir alt sınır da veriyor. Panelin en popüler kararının doğru olduğu varsayılırsa — en iyimser okuma — en az bir model iddiaların %67'sinde yanıldı, en az iki model %45'inde, en az üç model ise hiçbir kararın çoğunluğa ulaşmadığı %13'ünde.
Araştırmanın söylemedikleri
Lenz, modellerin çoğunluğunun mutlak doğru olmadığını vurguluyor: çoğunluk bazen yanılır, karşı görüşteki model bazen haklıdır; şirket çoğunluğu yalnızca yapısal bir referans noktası olarak kullanıyor. Lenz'in kendi kararları analize dahil edilmedi. Derlem dışında bırakılanlar arasında özel iddialar, çalışan gönderimleri, neredeyse aynı kayıtlar ve herhangi bir modelin ayrıştırılabilir bir karar üretemediği durumlar var.
Çalışma, verileri 21 Mayıs 2026 itibarıyla geçerli olan 1.0 sürümüyle dondurulmuş bir anlık görüntü; iddia bazlı CSV kamuya açık. Gelecek araştırma her iddiayı insan etiketiyle işaretleyip bu etiketleri referans doğru olarak kullanacak ve frontier panellerinin ve Lenz'in insan uzlaşısından nerede saptığını haritalayacak.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.