NVIDIA ve IIT Madras, 2,8 trilyon tokenlık Indic ön eğitim veri setini yayımladı
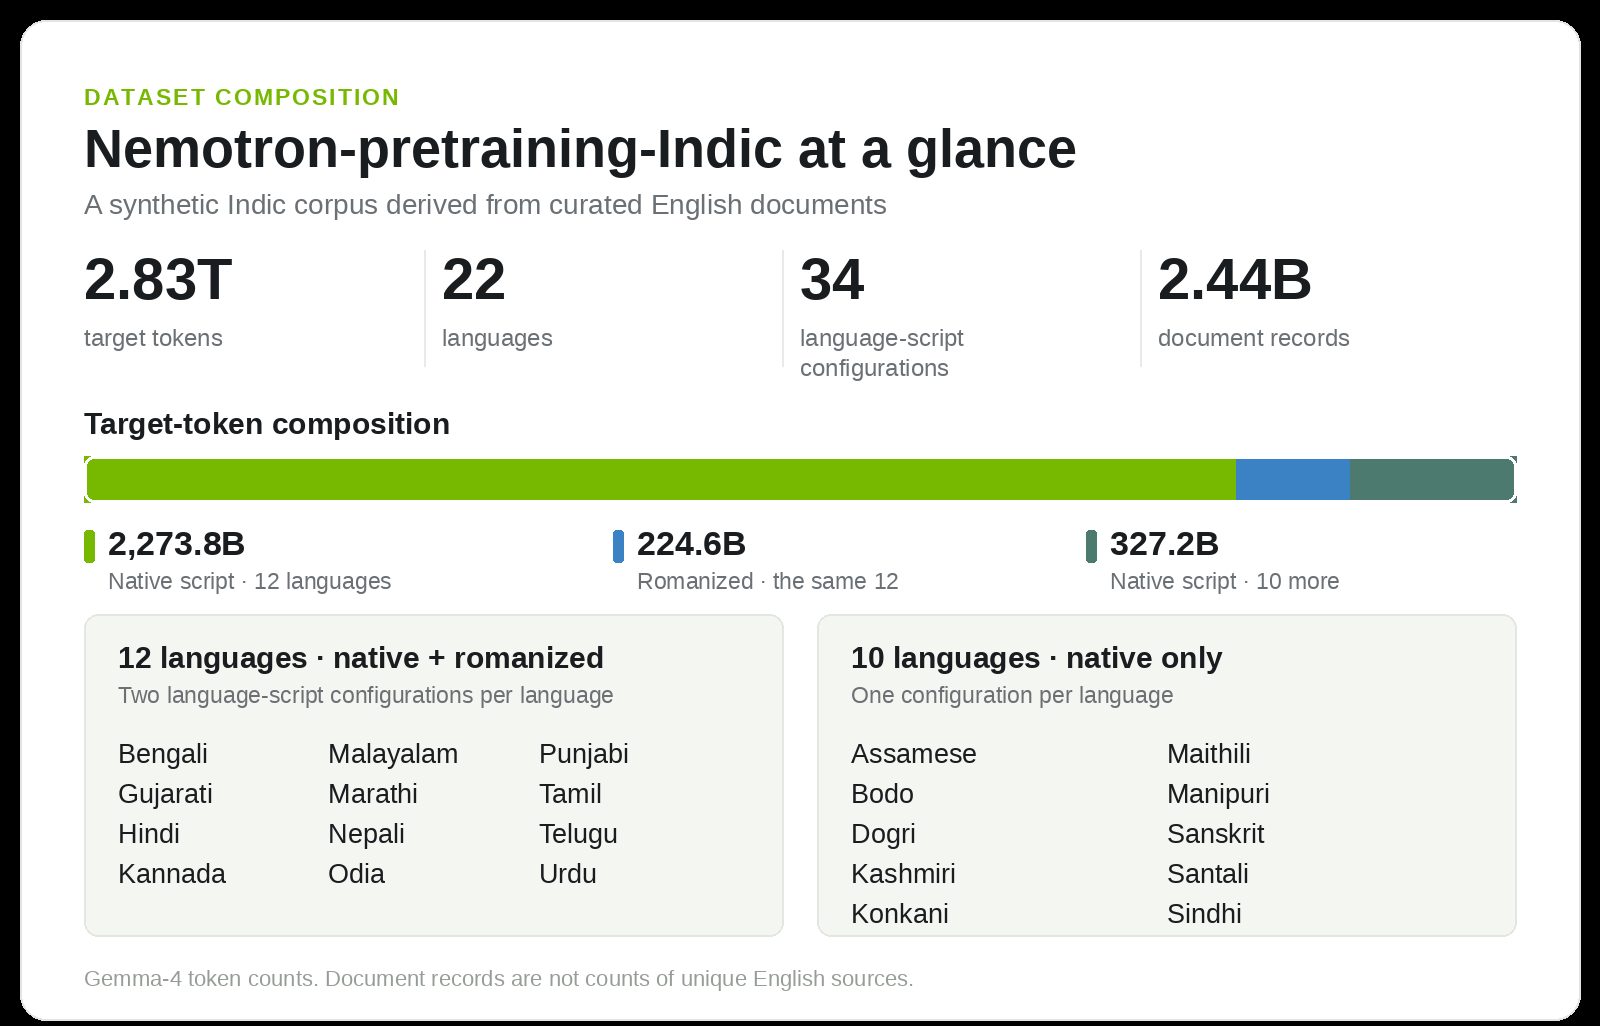
NVIDIA, IIT Madras ve AI4Bharat, 22 Hint dilinde yaklaşık 2,8 trilyon token içeren Nemotron-pretraining-Indic-v1 veri setini ve oluşturmak için kullanılan açık, GPU hızlandırmalı hattı tanıttı.
22 Hint dili için veri seti
NVIDIA, IIT Madras ve AI4Bharat laboratuvarıyla birlikte, Hindistan anayasasında sayılan 22 dilde yaklaşık 2,8 trilyon token içeren Nemotron-pretraining-Indic-v1 ön eğitim veri setini tanıttı. Sürüm ayrıca bunu oluşturmak için kullanılan ve çeviri, kalite değerlendirmesi ve düzeltme içeren açık, GPU hızlandırmalı veri üretim hattını da kapsıyor.
Veri seti, Gemma-4 tokenizer ile sayılmış 2 601,0 milyar yerel yazı tipi tokeni ve 224,6 milyar romanize token içeriyor. 34 dil-yazı tipi yapılandırması kapsar: 22 dilin tümü için yerel yazı tipi verileri ve bunların on ikisi için Latinize metin. Her kayıt, düzenlenmiş bir kaynak belgeyle ilişkilendirilir ve her çıktı girdisiyle karşılaştırılarak doğrulanır; böylece sentetik metin gerçek bilgiye dayanır.
İngilizce kaynaklardan Hint alıştırma verilerine
Hattı, web metinlerini, soru-cevap malzemesini, matematiği, kodu ve diğer uzmanlaşmış içerikleri kapsayan 15 Nemotron-CC-v2 alt grubundan gelen belgelerle başlar. NVIDIA'nın açık kaynaklı NeMo Data Designer çerçevesi çeviriyi, kalite kontrollerini ve hedefe yönelik düzeltmeleri yürütür, çıktıların orijinal belgelerine kadar izlenebilir olması için kaynak tanımlayıcılarını korur.
On iki dil için belgeler, modellerin tam belgeler üzerinde karşılaştırılmasının ardından seçilen Gemma-4-31B-it kullanılarak tamamen çevrilir. Multidimensional Quality Metrics'ten ilham alan rubrik, anlamı, doğruluğu, terminolojiyi, stili ve biçimlendirmeyi kapsar ve yalnızca 100 üzerinden en az 75 puan alan çıktılar korunur. Düşük puanlı çıktılar, değerlendirme geri bildirimi kullanılarak düzeltilir ve yeniden değerlendirilir; bu işlem 438,4 milyar token geri döndürdü. Elde edilen yerel yazı tipi çevirileri ayrıca Latinize kısmı için Latin yazı tipine dönüştürülür.
Kalan on dil, Bodhan AI'nın belge düzeyinde çeviri modeli olan Indic Translate'e dayalı ayrı bir iş akışı kullanır. Daha uzun Santali belgeleri için örtüşen pencereler çevrilir ve yeniden yapılandırılır; Manipuri için metin Bengal yazı tipinde çevrilir, ardından Meitei Mayek'e dönüştürülür.
Nemotron modellerindeki etki
Nemotron 3.5 Super VL'nin uzatılmış ön eğitimi, veri setinin on iki alt grubundan ve doğal Hint metinlerinden alınan 10 milyar Hint tokeni ekledi. Skorlar, bahsedilen beş Hint bilgi ve muhakeme kıyaslamasında, varyansı 4,98'den 9,82 yüzde puanına kadar artırdı. Yayımlanan model ayrıca, Nemotron 3 Super üzerinde altı Hint görev kıyaslamasından beşinde daha yüksek puan alır ve IndiVibe'in dört boyutunun tamamında üstün gelir; ancak IFEval 1.5'te talimat takibi 2,04 puan düşüş gösterir.
Ekip, gelecekteki Nemotron modellerinde bu veri setini kullanmayı planlıyor ve doğal olarak yazılmış Hint metinleriyle yerel bilgi ve kültürel bağlam için karıştırılmasını öneriyor.
Kaynaklar: Hugging Face Blog
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.