Stanford وNVIDIA تطرحان CLM-8B: نموذج System One سريع لاتخاذ القرار
قدّم فريق من Stanford University وNVIDIA Research نموذج Contrastive Language Models الذي يربط الحالات بالأفعال في فضاء تمثيلي مشترك. ويقدّم CLM-8B أداءً مماثلاً لـJev في مهام استخدام الحاسوب والألعاب واستدعاء الأدوات، لكنه أسرع بما يصل إلى 9 أضعاف.
ما هو Contrastive Language Model
قدّم فريق من Stanford University وNVIDIA Research، بقيادة جاكي كووك، في 23 سبتمبر نموذج Contrastive Language Models (CLM). ويصف المؤلفون CLM بأنه صنف جديد من نماذج System One: فبدلاً من التفكير خطوة بخطوة يتخذ قرارات سريعة وانعكاسية، عبر ربط مُرمِّز الحالات بمُرمِّز الأفعال في فضاء تمثيلي مشترك، مع تدريب بدالة تباين ثنائية الاتجاه InfoNCE.
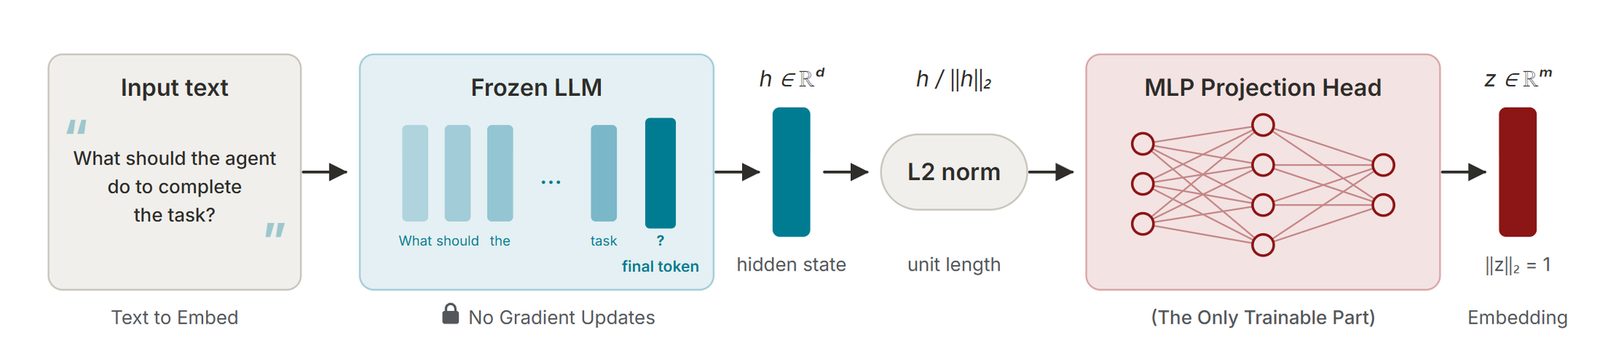
عند الاستخدام يعمل المُرمِّزان معاً كمصنّف أفعال بلا تدريب مسبق (zero-shot): فعند إعطائه الحالة الراهنة ومجموعة من الأفعال المرشحة، يقيّم CLM كل مرشح بالتشابه الجيبي مع تمثيل الحالة ويختار الأعلى. يجمع كل مُرمِّز نموذج LLM مجمّداً مع رأس إسقاط قابل للتدريب بـ20 مليون معامل، فلا تتلقى التدرجات سوى الرأس؛ ويستغرق التدريب المسبق الكامل على Nemotron DQA نحو ساعة على بطاقة RTX 4090 واحدة.
وصفة بيانات من ثلاث مراحل
يشمل التدريب المسبق نحو 60 مليون زوج من الأسئلة والأجوبة من Nemotron DQA، حيث يمثل السؤال الحالة ويمثل الجواب الفعل. وتُضاف في المرحلة الوسيطة نحو 30 مليون حالة سلبية صعبة مُصنَّعة بواسطة Gemini 2.5 Flash-Lite، بينما تستخدم مرحلة التدريب النهائي نحو مليون مسار وكيل من Agent Data Protocol.
النتائج والاستجابة
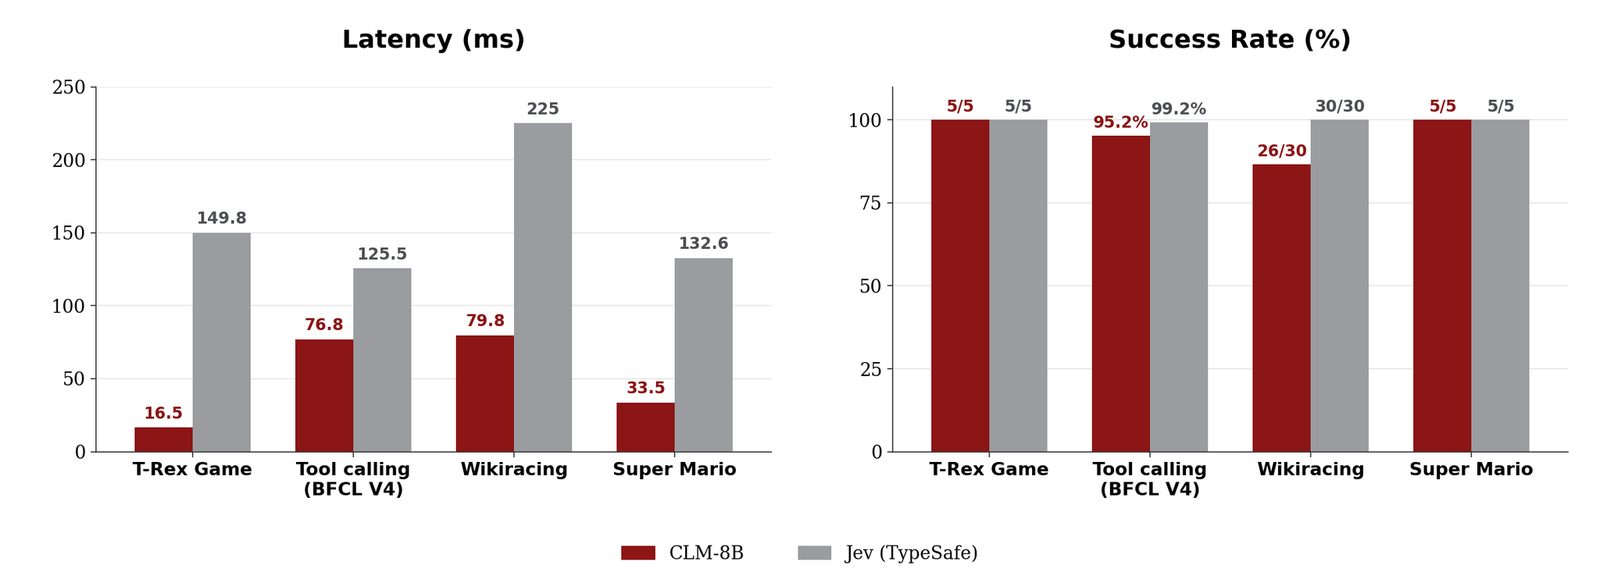
في مهام استخدام الحاسوب والألعاب واستدعاء الأدوات يحقق CLM-8B أداءً مماثلاً لـJev مع سرعة تصل إلى 9 أضعاف، ويبلغ الفارق 13 ضعفاً عند نحو 1000 فعل مرشح. وبعد ضبطه كمدقّق للمسارات يسجل النموذج رقماً قياسياً جديداً في DeepSWE (81.6%) وTerminal-Bench 2.1 (87.6%)، مع استدلال أسرع 4-6 أضعاف من Jev على بطاقة H100 عبر 38 و30 مهمة محجوزة للاختبار.
البنية التحتية والخطوات التالية
تفصل بنية الخدمة الحالات عن الأفعال بحيث تُخزَّن تمثيلاتها مؤقتاً بشكل مستقل: فعندما تتغير الحالة وحدها، كما في Super Mario، يحتاج كل خطوة إلى تمرير واحد بدلاً من خمسة. كما وضع الفريق قوانين تحجيم لـCLM: تتراجع خسارة التباين في الاختبار وفق قانون قوى مع زيادة الحساب والبيانات وحجم النموذج. أما النموذج متعدد الوسائط CLM-35B فهو قيد التدريب حالياً مع إطلاق مخطَّط في بداية الشهر المقبل.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.