عرضت NVIDIA مسارًا فعّالًا لتدريب نماذج MoE الحيوية
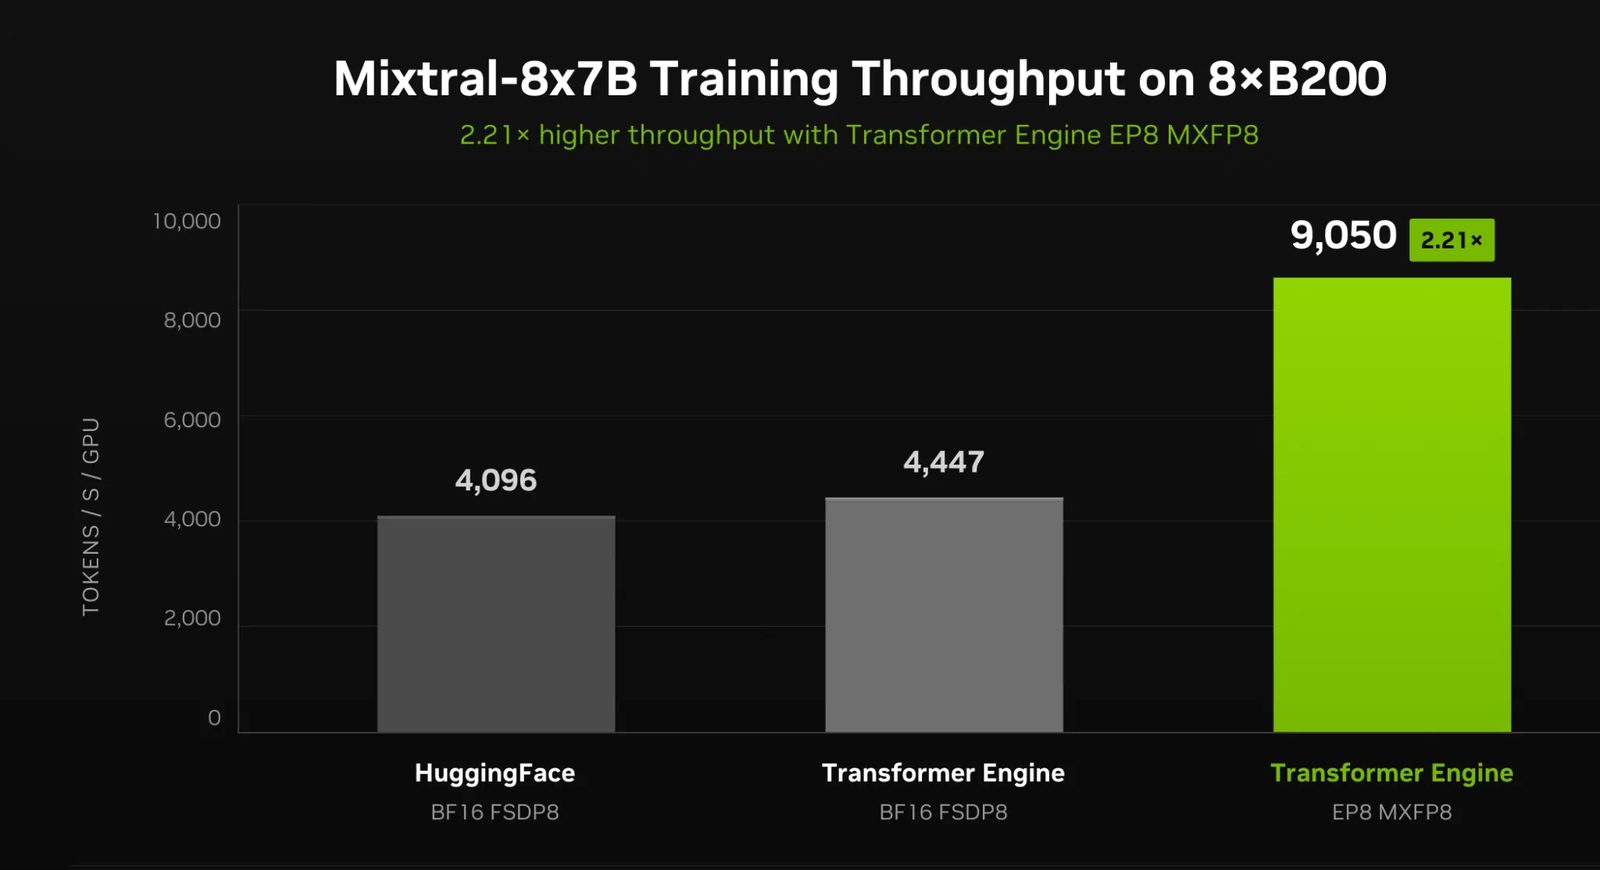
في درس تقني جديد على مدونة مطوّري NVIDIA، يُشرح كيف يسرّع Transformer Engine ووصفة BioNeMo تدريب نماذج مخاليط الخبراء (MoE) في البيولوجيا، بتحقيق إنتاجية تبلغ 2.21 ضعف خط الأساس على ثماني وحدات B200.
نشرت مدونة مطوّري NVIDIA درسًا تقنيًا حول تدريب نماذج الأساس الحيوية بأسلوب مخاليط الخبراء (MoE) بكفاءة أعلى. كتب الدرس Faradawn Yang وPeter St John وKyle Tretina وZoey Zhang.
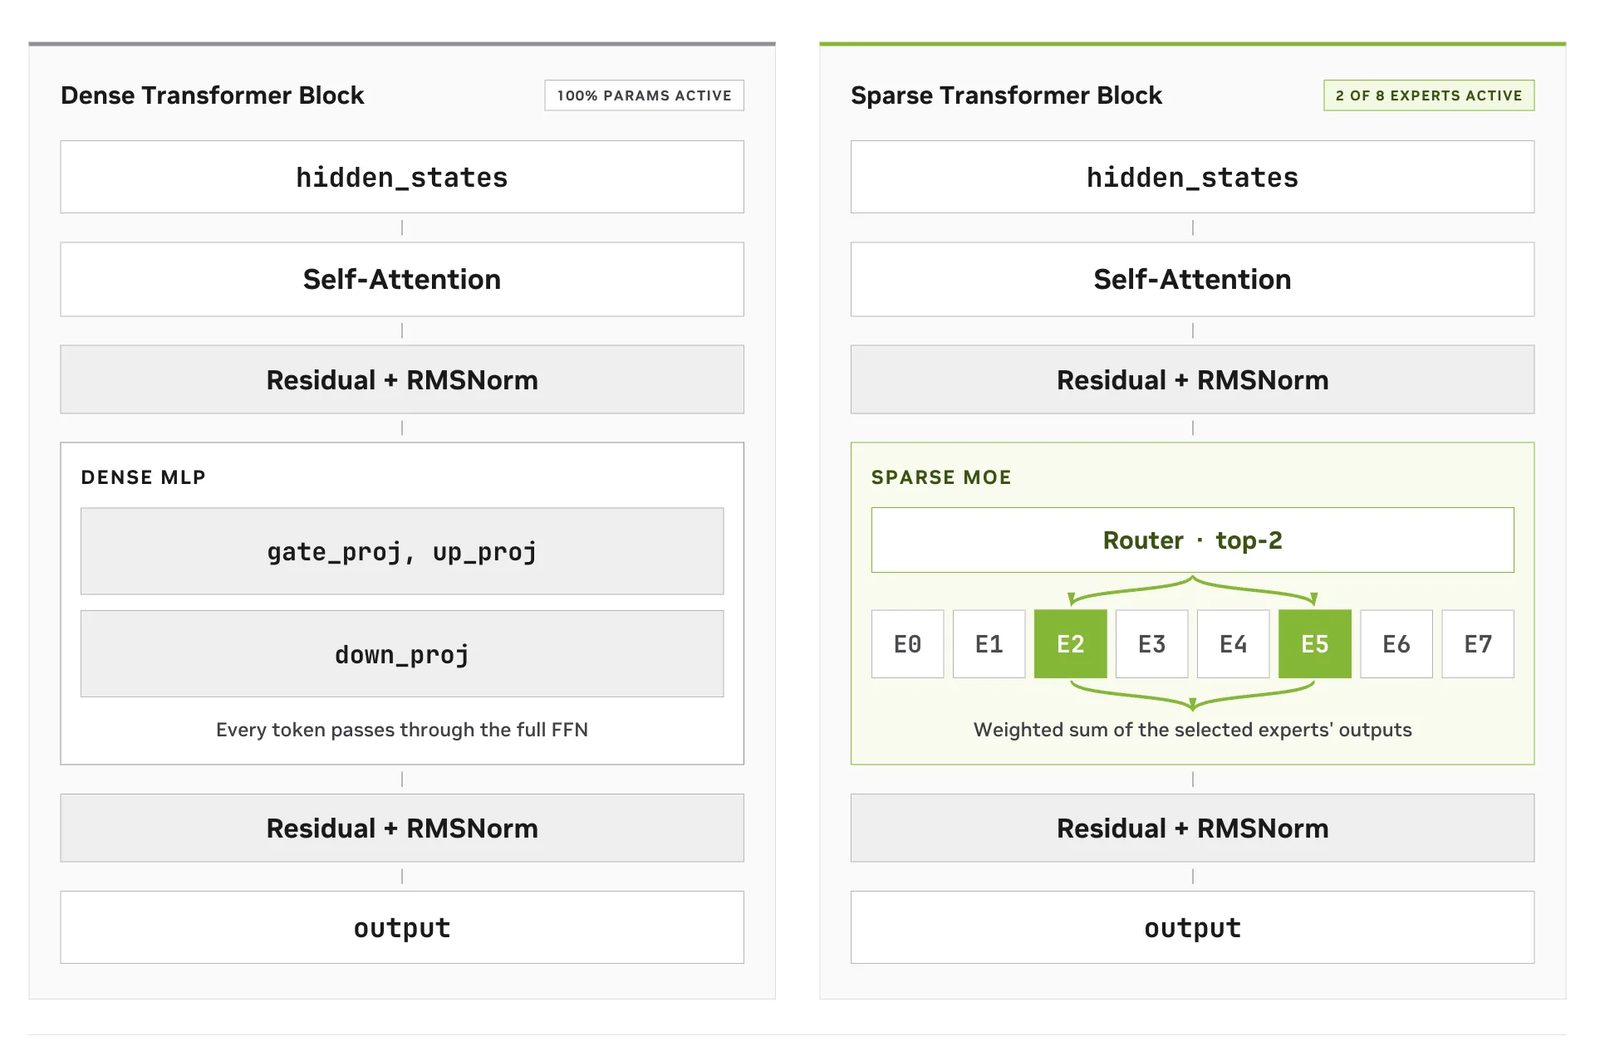
تُمرّر المحوّلات الكثيفة كل رمز عبر جميع الطبقات، لذا تصبح زيادة السعة مكلفة في التدريب والاستدلال معًا. تقسم معماريات MoE كتلة feed-forward إلى خبراء كثيرين وتُنشّط جزءًا صغيرًا فقط لكل رمز. النتيجة تعتمد على التنفيذ: الحسابات المجزّأة تخفض استغلال GPU، والتوجيه يضيف كلفة اتصال، وكبر حجم المعاملات يضغط على الذاكرة.
خبراء مجمّعون بدل حلقة Python
العقبة الأولى هي تفتّت النوى الحاسوبية. في التنفيذ المرجعي من Hugging Face تعمل الخبراء واحدًا تلو الآخر داخل حلقة Python، فيطلق كل منها نوى منفصلة. أما GroupedLinear في TE فيجمع أوزان الخبراء والرموز وينفّذ كل التحويلات الخطية في نداء GEMM مجمّع واحد، ويستقبل عدد الرموز لكل خبير عبر وسيط split_sizes. وتستطيع حزمة NVIDIA دمج هذا الإسقاط مع تكميم MXFP8 وتقيس أوزان التوجيه داخل نواة GroupedMLP.
تقليل الذاكرة وكلفة التكميم
تحمل نماذج MoE معاملات أكثر، وأحمال الجينوم تستخدم سلاسل طويلة غالبًا، ما يضغط على ذاكرة التنشيط. يخزّن BF16 كل قيمة بـ16 بت، بينما يستخدم FP8 وMXFP8 ثماني بتات. ويخصّص MXFP8 معامل قياس لكل كتلة من 32 قيمة متتالية، وعلى وحدات GPU من معمارية Blackwell تعمل عمليات GEMM هذه بتعليمات Tensor Core مخصّصة.
يُبقي التدريب منخفض الدقة أوزان الأساس بـ16 بت، فيضيف التكميم وفك التكميم عملًا إضافيًا. وربط GroupedLinear وScaledSwiGLU وGroupedLinear عبر واجهة Sequential في TE يسمح باستبدال النمط بعملية مدموجة واحدة: ForwardGroupedMLP_CuTeGEMMSwiGLU_MXFP8 في المرور الأمامي وما يقابلها في المرور الخلفي.
إنتاجية أعلى 2.21 مرة على ثماني وحدات B200
في اختبار لنموذج Mixtral-8x7B على ثماني وحدات NVIDIA B200 Tensor Core GPU، بلغت الوصفة حتى 2.21 ضعف إنتاجية الخط الأساسي من Hugging Face. تتطلب نوى MXFP8 GroupedMLP المدموجة عتاد Blackwell، ويحتاج التوازي بين الخبراء إلى وحدتي GPU على الأقل.
يتضمّن الدرس أوامر التشغيل: تهيئة L0_sanity على وحدتي GPU للتحقق من البيئة، ثم تهيئة L1_8x7B_ep مع التوازي بين الخبراء (EP=8) ودقة MXFP8 على ثماني وحدات.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.