NVIDIA Warp وMJWarp: 2048 محاكاة روبوتية متوازية على وحدة GPU واحدة
نشرت NVIDIA المقال الثاني في سلسلة State of Simulation for Physical AI، وهو يستعرض MuJoCo Warp الذي ينقل نماذج MuJoCo المتوافقة إلى وحدة GPU ويشغّل حتى 2048 عالماً للمحاكاة في وقت واحد.
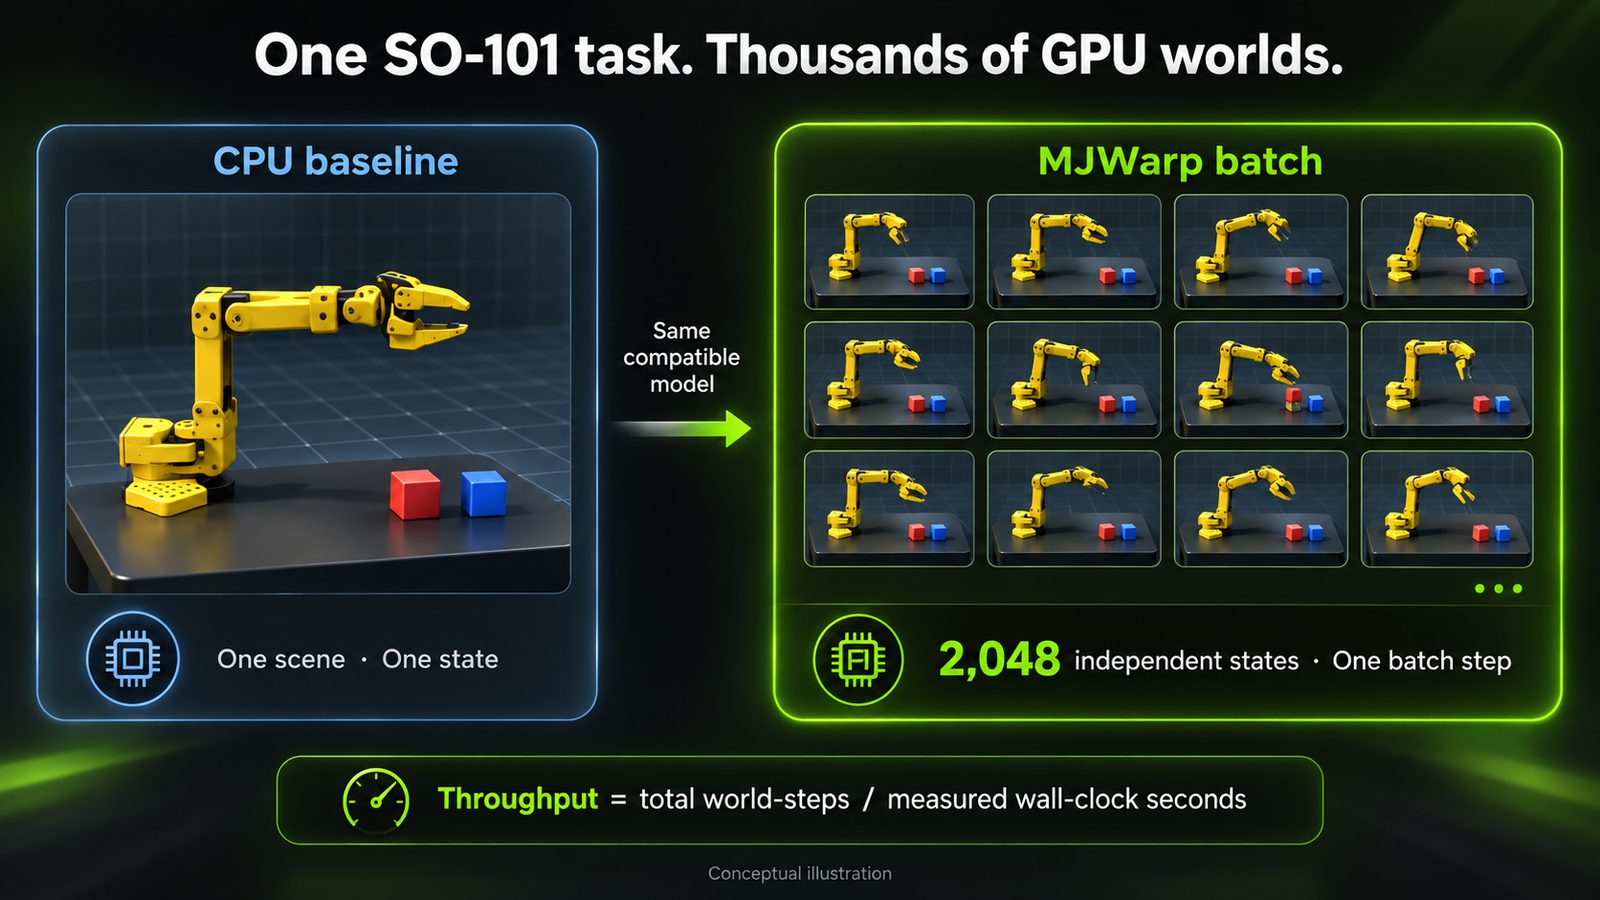
نشرت NVIDIA المقال الثاني في سلسلة State of Simulation for Physical AI. يستعرض المقال MuJoCo Warp (MJWarp)، وهو تطبيق على GPU لفيزياء MuJoCo مبني على إطار النوى NVIDIA Warp. في المثال يُنقل ذراع الروبوت SO-101 من مسار عمل تقليدي على CPU إلى ما يصل إلى 2048 عالماً للمحاكاة في وقت واحد على وحدة GPU واحدة. ويرى المؤلفون أن السؤال الأساسي لم يعد سرعة تقدّم عالم واحد، بل عدد العوالم التي يمكن أن تتقدم معاً.
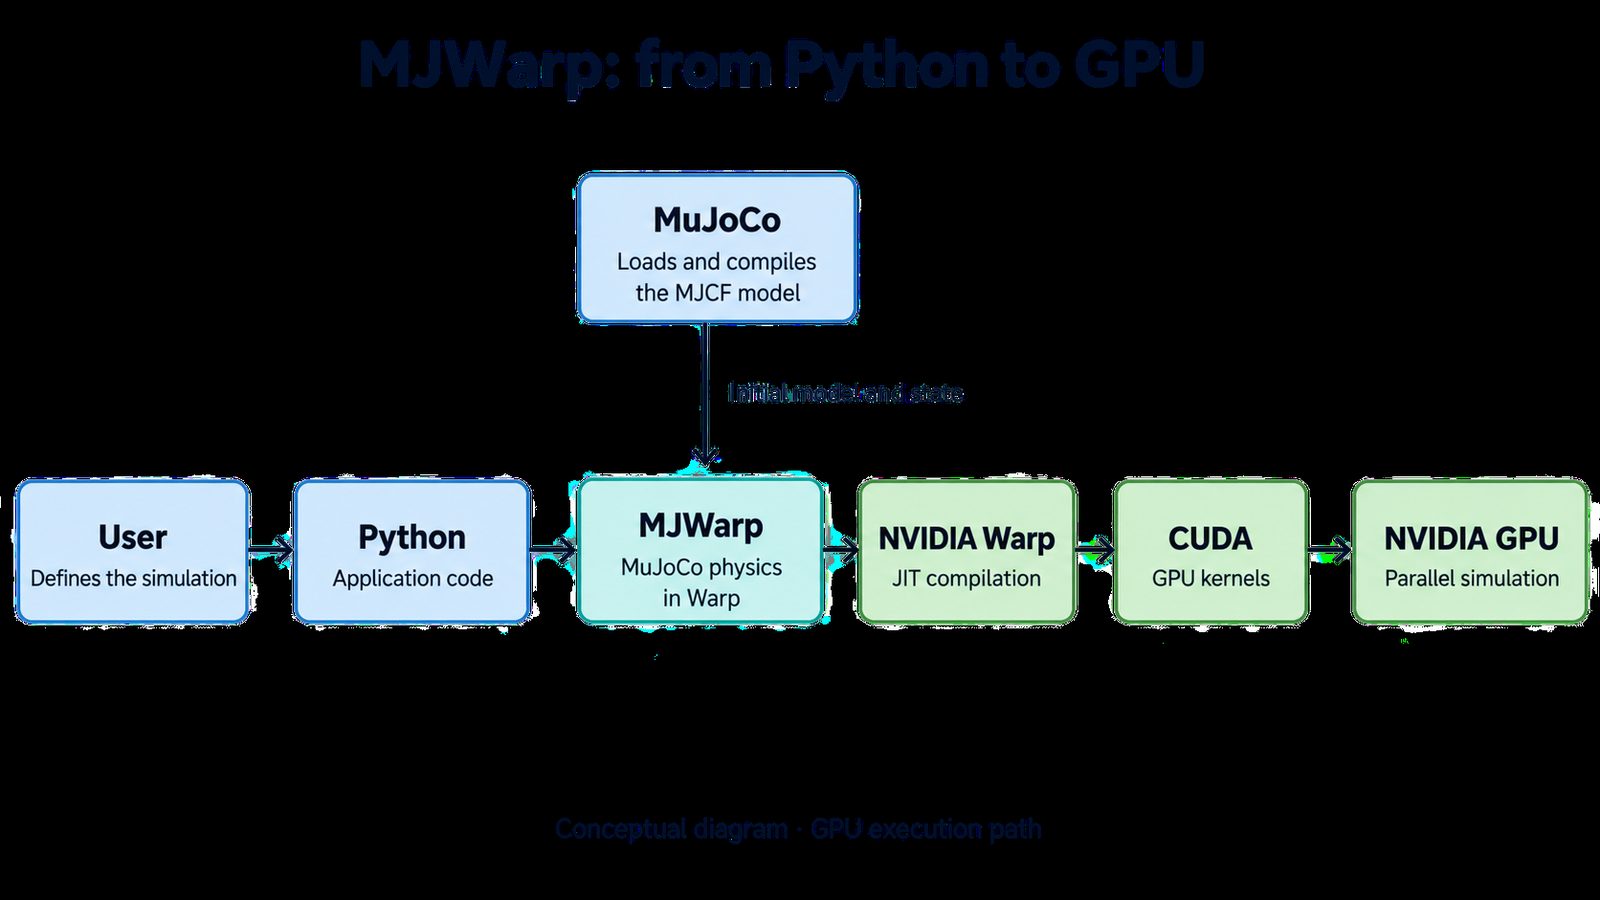
Warp إطار عمل بلغة Python لكتابة نوى عالية الأداء مسرَّعة بوحدة GPU. يكتب المطوّرون نوى ذات أنواع ثابتة بلغة Python، ويترجمها Warp إلى CPU أو CUDA ويخزّن الناتج مؤقتاً، فيما تبقى الإعدادات وتنظيم التشغيل بلغة Python العادية. يقدّم الإطار سرعة بمستوى CUDA عبر الترجمة الفورية وCUDA Graphs، ومتجهات ومصفوفات ورباعيات وhash grid مدمجة، إضافة إلى نوى قابلة للاشتقاق بواجهة DLPack، ما يسمح بإدراج المحاكاة داخل حلقة تدريب نماذج التعلم الآلي.
كيف يجمع MJWarp الفيزياء في دفعات
يحافظ MJWarp على صيغة النموذج: يُحمَّل ملف MJCF في MuJoCo، وينقله mjw.put_model إلى الجهاز، حيث تُقدّم استدعاءة واحدة من mjw.step دفعة كاملة من عوالم مستقلة. وتحدّد أربعة معطيات السعة: nworld عدد البيئات المتوازية، وnconmax التلامسات المتوقعة لكل عالم، وnaconmax حد التلامسات الإجمالي الذي له الأولوية عند تحديده، وnjmax السقف الأعلى للقيود لكل عالم. والمكسب ليس زمن استجابة عالم واحد بل الإنتاجية الكلية، وهو ما يناسب التعلم المعزز وأخذ العينات على نطاق واسع.
التحقق أولاً ثم القياس
يمرّ المؤلفون بفحوص متتابعة: بناء نتيجة أساسية على CPU، ثم نقل عالم واحد إلى GPU والتأكد من التطابق، ثم ضبط وسائد التلامس والقيود وفق أكثر لحظات المهمة ازدحاماً بالتلامس، وأخيراً الانتقال إلى 2048 عالماً. في المثال على ذراع SO-101 أن تضع المكعب الأحمر البالغ 44 مم فوق المكعب الأزرق. ويُقاس النجاح بشرطين: خطأ أفقي لا يزيد على 15 مم ومسافة رأسية بين 35 و55 مم. ولا يُطلق تجاوز الوسادة كخطأ، لذلك لا يمكن الاعتماد على تشغيل استمر بعد التجاوز في القياسات.
القياس هو المرحلة الأخيرة. عمليات التشغيل على GPU غير متزامنة، لذا يقيس المؤقّت الساذج سرعة إدخال Python للعمل لا سرعة إنهاء GPU له. ويجري المقال مرحلة تسخين أولاً ثم مزامنة قبل الفترة المقيسة وبعدها. وتُعرض النتائج بعدد خطوات العالم في الثانية وبالميلي ثانية لكل خطوة دفعة، مع حجم الدفعة. وقد أضاف Warp 1.15 وضع تشغيل حتمياً، وسينقل الجزء التالي من السلسلة البيئة نفسها إلى Newton.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.