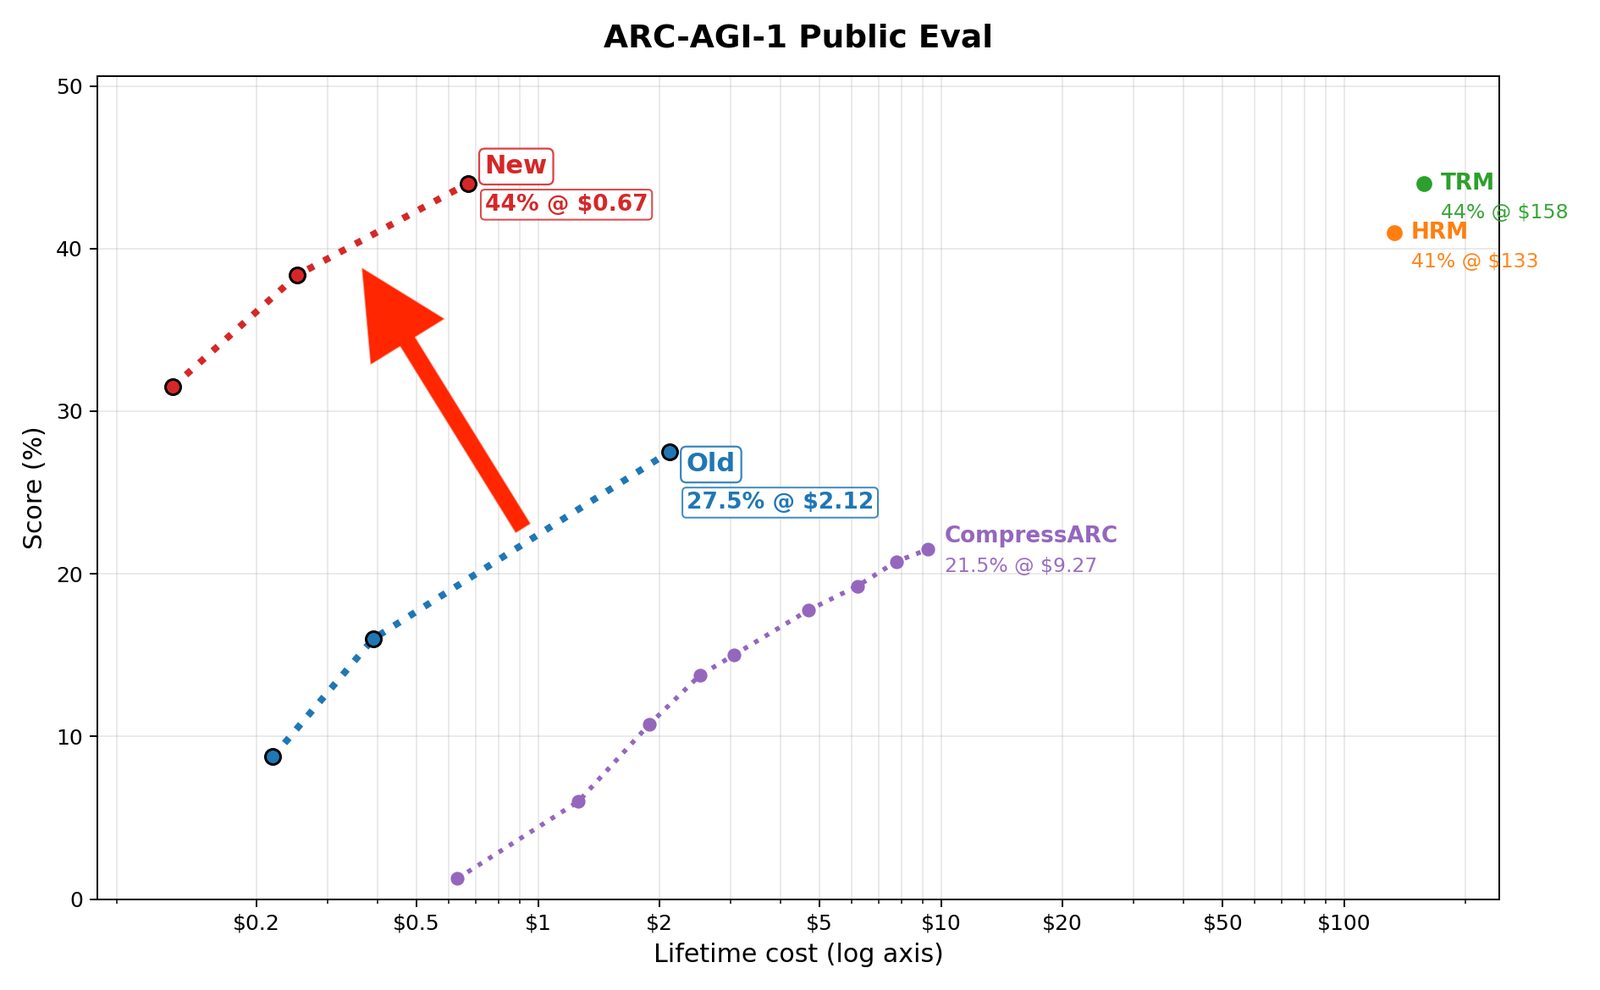
44% في ARC-AGI-1 مقابل 67 سنتاً: نموذج محوّل صغير دُرّب في ساعة ونصف
درّب ميثيل فاكدي نموذجاً محوّلاً صغيراً من الصفر على بطاقة RTX 5090 واحدة في نحو ساعة ونصف، فحقق 44% في التقييم العام لـ ARC-AGI-1 بكلفة إجمالية 67 سنتاً.
نشر الباحث ميثيل فاكدي المقال الثالث في سلسلته حول معيار ARC-AGI. هذه المرة درّب من الصفر نموذج محوّل صغيراً يحقق 44% في مجموعة التقييم العامة لـ ARC-AGI-1 و7% في ARC-AGI-2. ويقول المؤلف إن التكلفة الحاسوبية الإجمالية عبر دورة الحياة كاملة — التدريب من البداية إضافة إلى الاستدلال على كل المهام — بلغت 67 سنتاً.
يستغرق التدريب نحو ساعة ونصف الساعة على بطاقة رسوميات واحدة من طراز RTX 5090، وتوافق النتيجة الدرجات المعلنة لنموذجي TRM وHRM اللذين بات يقارن بهما فقط، إذ يشدّد فاكدي على أنه لا يقارن إلا بالمقاربات التي تستخدم تدريباً مماثلاً أثناء الاختبار. الشيفرة مفتوحة المصدر.
كيف تعمل المقاربة
يُحوَّل كل زوج من المدخل والمخرج في الأحجية إلى سلسلة من الوحدات الرمزية، ويتدرب محوّل صغير عليها من الصفر وبشكل تلقائي انحداري أثناء الاختبار ذاته — على أحاجي المعيار، مع إخفاء الإجابات الصحيحة. ولتمكين التعلم بين المهام تحصل كل أحجية على تضمين جمعي خاص بها، بينما تُعالج المعلومات الموضعية بتضمينات 3D RoPE، لأن كل سلسلة تضم شبكتين ثنائيتي الأبعاد.
تُثرى بيانات التدريب بتبديلات لونية وتبديلات ثنائية السطوح. وعند الاستدلال تُثرى مدخلات الاختبار أيضاً، ثم يُطبَّق التحويل العكسي على المخرجات الناتجة، وتُقدَّم في النهاية الإجابتان الأكثر تكراراً.
ما الذي تغيّر عن النسخة السابقة
جاء أكبر تحسّن في النتيجة من بنية حديثة: SwiGLU بدل GELU وRMSNorm بدل LayerNorm، ومن بيانات أكثر تنوعاً وأفضل خلطاً، ومن التوسّع من 4 طبقات إلى 8. أما خفض الكلفة فجاء من تقليل عدد التحسينات كثيراً، والانتقال بالمحسّن من AdamW وحده إلى NorMuon مع AdamW مساعد، والاعتماد على flash attention على سلاسل معبّأة متغيرة الطول.
لماذا يهم ذلك
يعتبر فاكدي كفاءة العيّنات (sample efficiency) أهم مشكلة غير محلولة في الذكاء الاصطناعي، ويرى في ARC ساحة مناسبة لاختبارها: نحو ألف أحجية، لكل منها قاعدتها الخاصة، مع الحد الأدنى من المعرفة المسبقة. وهدفه المعلن هو تحديد حدود أساليب التعلم العميق الحالية وإبقاء كلفة التكرار منخفضة بما يكفي ليعمل أي شخص في العالم على هذه المسألة.
أظهر تحليل الاستئصال أن جزءاً كبيراً من الأداء يبقى قائماً حتى من دون تحسينات أو بيانات اصطناعية، وأن اتحاد المهام المحلولة عبر عدة تشغيلات يبلغ 55%. ويقول المؤلف إنه يعتقد الآن أن 65% في متناول الإطار التقليدي للمحوّلات، ويرى إمكانية خفض الكلفة عشرة أضعاف أخرى عبر نوى GPU مكتوبة يدوياً.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.