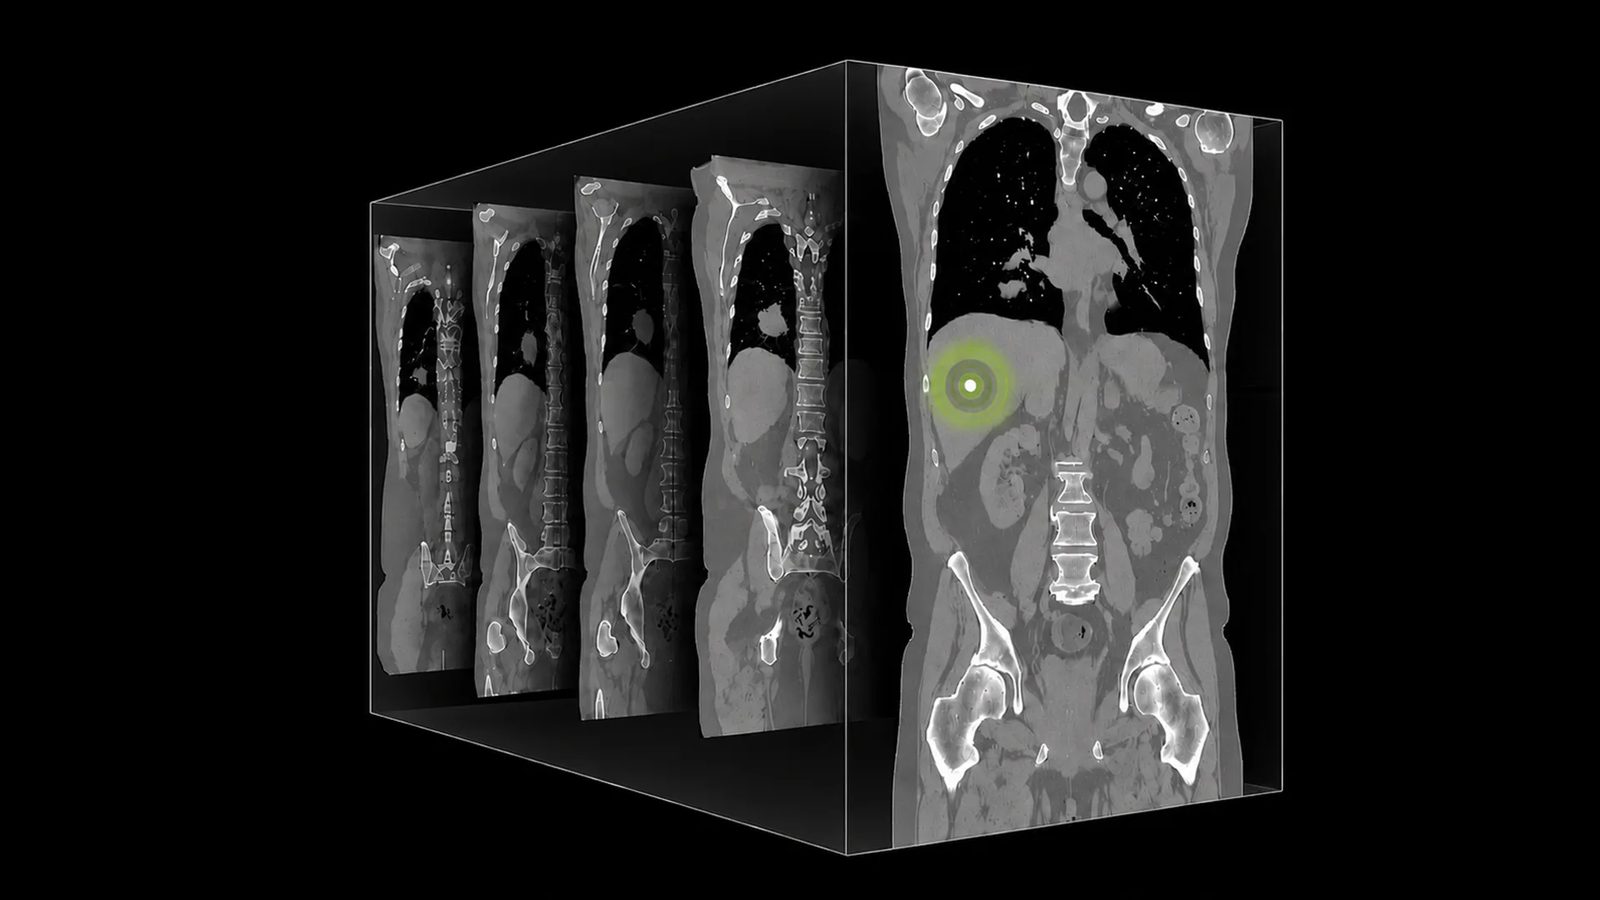
NVIDIA تكشف عن NV-Reason-CT لتحليل الأشعة المقطعية ثلاثية الأبعاد
كشفت NVIDIA عن NV-Reason-CT، نموذج رؤية ولغة مُصمم لتحليل صور مقطعية ثلاثية الأبعاد. ينتج النموذج تقارير منظمة وسلسلة تفكير على غرار أطباء الأشعة، مع أوزان مفتوحة على Hugging Face.
كشفت NVIDIA عن NV-Reason-CT، وهو نموذج رؤية ولغة (VLM) صُمم خصيصًا لتحليل صور التصوير المقطعي المحوسب (CT) ثلاثية الأبعاد. وينتج النموذج تقارير تشخيصية منظمة وسلسلة تفكير خطوة بخطوة تحاكي طريقة عمل أطباء الأشعة، بحسب تدوينة للشركة نشرت في 23 سبتمبر 2026.
ويوسع الإصدار إلى التصوير الحجمي منهجية بدأت مع NV-Reason-CXR، وهو نموذج لتحليل صور الصدر بالأشعة السينية قُبلت دراسته السريرية متعددة القراء في RSNA 2026 وأكدت توفير الوقت لأطباء الأشعة مع الحفاظ على الدقة التشخيصية.
لماذا يتطلب التصوير المقطعي ثلاثي الأبعاد مقاربة مختلفة
قد تضم دراسة واحدة للبطن 300–600 مقطع محوري، فتكون التشريحات مشفرة في ثلاثة أبعاد مكانية. تتعامل نماذج الرؤية واللغة التقليدية مع الصورة كشبكة ثنائية الأبعاد من الرموز، لذا فإن معالجة الحجم كسلسلة من الإطارات المستقلة تفقد العلاقات بين المقاطع التي تمنح الكتل والانصبابات والتسربات معناها السريري.
وتشير NVIDIA إلى فجوتين أخريين: النماذج التي تكتشف الشذوذ غالبًا تخرج تصنيفًا دون تفسير السبب، ومعظم الأنظمة الحالية تفتقر إلى الحوار متعدد الجولات الذي يحتاجه الطبيب للاستقصاء عن أي نتيجة.
مشفّر ثلاثي الأبعاد ونموذج لغوي بحجم 4B
تجمع البنية بين مشفّر كامل ثلاثي الأبعاد من نوع vision transformer ونموذج لغوي Qwen3.5-4B. يُعاد تشكيل حجم الصور المقطعية إلى 192³ فوكسل بدقة متساوية تبلغ 2 ملم ويُقسَّم إلى رموز رقعية 8×8×8، أي 13,824 رمزًا بصريًا تُمرَّر كلها إلى النموذج اللغوي مع إحداثياتها المكانية الثلاثية. ويحافظ مخطط 3D MRoPE على العلاقات المكانية عبر طبقات النموذج. وأعيد تدريب جميع الأوزان من البداية إلى النهاية.
وجرى التدريب على مرحلتين: الضبط الدقيق الموجّه على نحو 550 ألف مثال من الأسئلة والأجوبة المنظمة في الصدر والبطن، بما يشمل ملاحظات تفكير أملاها أطباء أشعة، ثم التعلم المعزز بخوارزمية GRPO ومكافأة تراعي التشريح.
النتائج والتحقق السريري
على معيار CT-RATE العام لتحليل الصور المقطعية ثلاثية الأبعاد، يسجل NV-Reason-CT قيمة Macro-F1 تبلغ 0.614 وMacro-AUROC تبلغ 0.871، متقدمًا على نماذج ثلاثية الأبعاد تقابلية مثل VoxelFM (0.581/0.870) وPillar-0 (0.544/0.861) وCT-CLIP وMerlin، فضلًا عن ClinFusion-8B (0.442) وMedGemma 1.5 (0.303). وبحسب NVIDIA، هذه المرة الأولى التي يكون فيها نموذج مفتوح واحد تنافسيًا في تصنيف الصور المقطعية وتوليد التقارير معًا.
راجع أطباء أشعة في المعاهد الوطنية للصحة (NIH) النتائج؛ وقال باريس توركبي، الطبيب والباحث البارز في NIH، إن تفكير النموذج خطوة بخطوة يعكس كيفية تفكير الأطباء فعليًا في دراسة مقطعية، وإن إمكانية الاطلاع على مسار التفكير وليس النتيجة فقط هي ما يجعل النتائج جديرة بالثقة وقابلة للتنفيذ.
ما الذي تشمله “الانفتاح”
NV-Reason-CT أساس بحثي وتطويري مفتوح، وليس نظام تشخيص مستقلًا ولا منتجًا سريريًا معتمدًا. الأوزان متاحة على Hugging Face، ويضم مستودع GitHub نصوص الاستدلال وإعدادات التدريب ووصفات التدريب اللاحق. وينضم النموذج إلى عائلة NVIDIA Medical AI إلى جانب NV-Generate-CTMR للحجوم الاصطناعية وNV-Segment-CTMR للتقسيم.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.