SiTech AI Team2 წთ. საკითხავი
تقليم نماذج اللغة كعالم فيزياء: إزالة الكتل كمسألة تحسين آيزينغ
ورقة جديدة من Multiverse Computing تعيد صياغة اختيار كتل المحوّل كمسألة تحسين ثنائي مقيّد تُسقط على زجاج آيزينغ، وتتقدّم على أقوى طريقة مقارنة بنحو 23 نقطة في MMLU عند الضغط العميق.
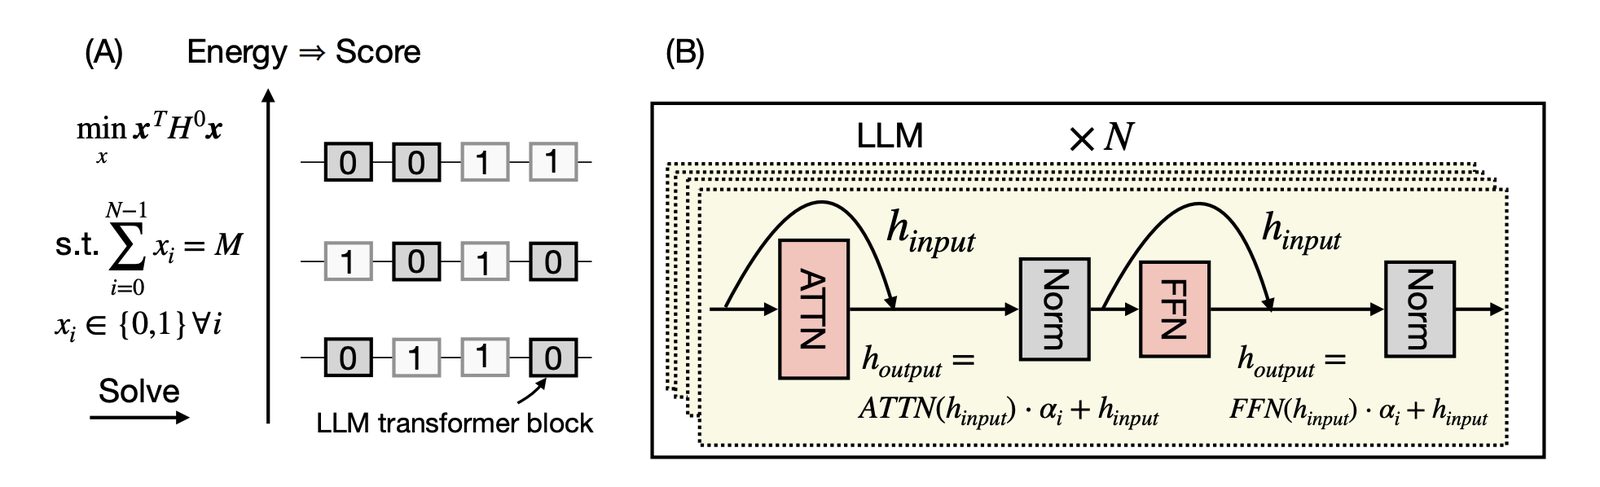
حذف كتل كاملة من المحوّل من أرخص طرق تسريع نموذج لغوي كبير: فالنموذج يصبح أقصر فعليًا، ولذلك تمنح إزالة الكتل (depth pruning) تسريعًا متوقعًا في الاستدلال فوق التوفير في الذاكرة، وتجتمع جيدًا مع التكميم. الصعوبة في تحديد الكتل التي يجب قطعها: أثر إزالة كتلة يعتمد على الكتل الأخرى التي أُزيلت معها. وتعيد ورقة LLM Compression by Block Removal with Constrained Binary Optimization (مدونة Hugging Face، 21 سبتمبر 2026) صياغة هذا الاختيار كمسألة تحسين ثنائي مقيّد (CBO) تُسقط على زجاج آيزينغ؛ وطاقته مؤشر رخيص لجودة النموذج.
 تُحسب مصفوفة هسه مرة واحدة فقط، من تمريرات أمامية وخلفية على مجموعة معايرة صغيرة؛ بعد ذلك يُقيَّم أي تكوين مرشح بحساب طاقة رخيص واحد دون تشغيل النموذج. وتخدم المصفوفة نفسها قيمًا كثيرة لـ M.
 في Llama-3.1-8B-Instruct، عند إزالة 16 من 32 كتلة، تكون الحالة المثارة 17 أول من يقترح إزالة كتلة في بداية النموذج، وبعد إعادة تدريب خفيفة تتجاوز حالة الأرض. ومن دون إعادة تدريب يصل Llama-3.3-70B-Instruct إلى 76.6 و76.9 في MMLU عند إزالة 32 و40 من 80 كتلة، مقابل 59.3 و54.0 لطريقة block influence؛ وفي Qwen3-14B عند إزالة 12 من 40 تكون الأفضلية نحو 10 نقاط. وتنتقل الطريقة إلى النموذج الهجين NVIDIA-Nemotron-3-Nano-30B-A3B-FP8 متفوقة على block influence في AIME25 وGPQA، والكود مفتوح.
لماذا لا تكون الكتل مستقلة
تُقيّم الطرق الحالية كل كتلة على حدة — بالحجم أو الحساسية أو مؤشر block influence — ثم تحذف الأقل أهمية: وهو تقريب المجال المتوسط الذي يعامل مساهمة الكتلة كأنها مستقلة عن غيرها. في الواقع لا تضر إزالة الكتلة 20 إلا إذا أُزيلت معها الكتلة 19 أو 24، وعدد التوليفات ينمو أُسّيًا.من اختيار الكتل إلى تصغير الطاقة
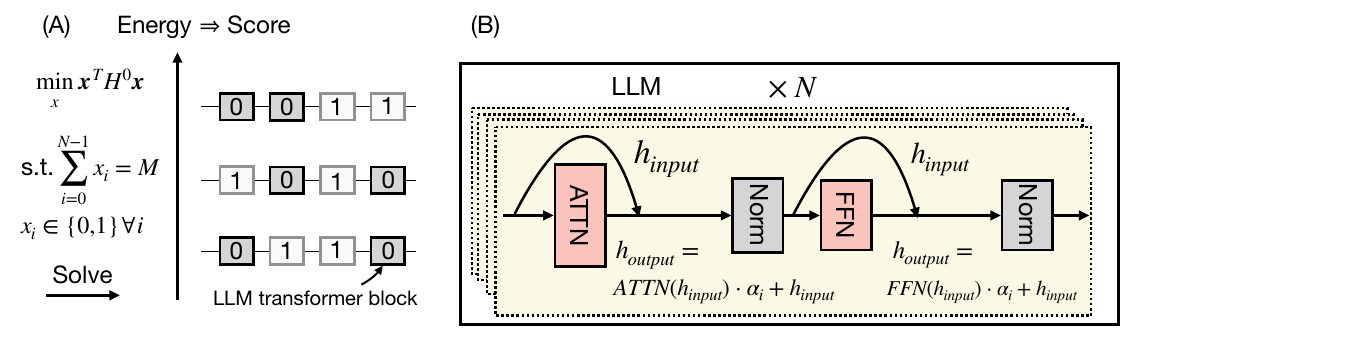
يُخصص لكل كتلة متغير ثنائي: 0 للإبقاء و1 للإزالة. ويعطي نشر تايلور من الدرجة الثانية لدالة الخسارة مصفوفة هسه تقريبية: يبيّن القطر أهمية كل كتلة بمفردها، وتمثل العناصر خارج القطر الاقترانات الزوجية التي تتجاهلها طرق المجال المتوسط. والمهمة هي إيجاد M كتلة من أصل N تؤدي إزالتها إلى تصغير الطاقة.
تُحسب مصفوفة هسه مرة واحدة فقط، من تمريرات أمامية وخلفية على مجموعة معايرة صغيرة؛ بعد ذلك يُقيَّم أي تكوين مرشح بحساب طاقة رخيص واحد دون تشغيل النموذج. وتخدم المصفوفة نفسها قيمًا كثيرة لـ M.
الحلّالات والطيف والنتائج
على وحدة GPU واحدة يفحص المؤلفون عشرات المليارات من التكوينات بالقوة الغاشمة؛ واستغرق أصعب حالة ممكنة، إزالة 8 من 80 كتلة في Llama-3.3-70B (نحو 29 مليار تكوين)، يومين تقريبًا. وبعد ذلك تنتقل المهمة بصيغة QUBO إلى حلّالات كلاسيكية وكمومية ومستوحاة من الكم: التلدين وQAOA وtabu search وbranch-and-bound؛ ويصل حلّال tabu المفتوح إلى أدنى حالات الطاقة في ثوانٍ. ولا حاجة إلى حالة الأرض الحقيقية: يكفي عدد قليل من حالات الطاقة المنخفضة الجيدة.
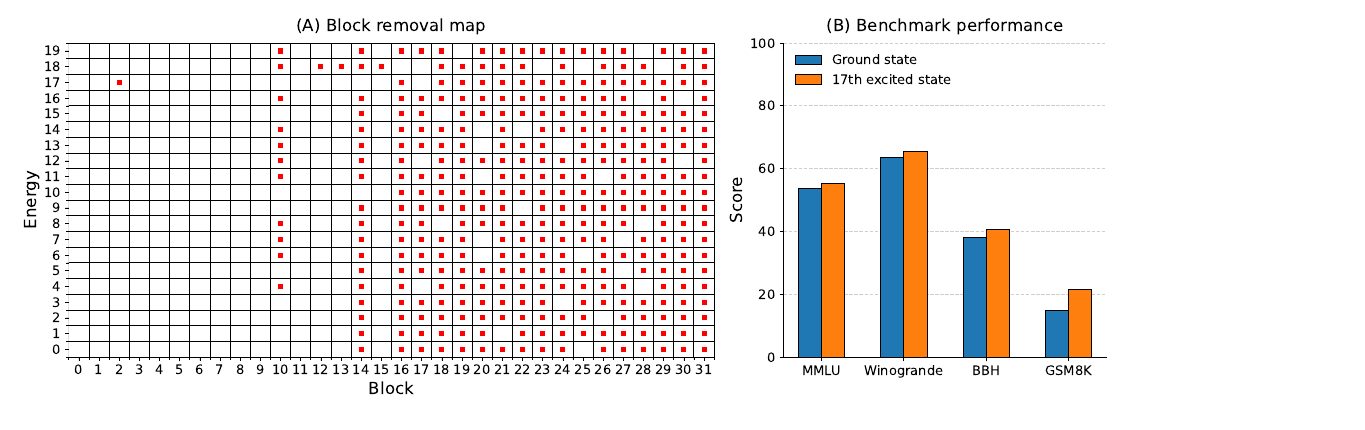
في Llama-3.1-8B-Instruct، عند إزالة 16 من 32 كتلة، تكون الحالة المثارة 17 أول من يقترح إزالة كتلة في بداية النموذج، وبعد إعادة تدريب خفيفة تتجاوز حالة الأرض. ومن دون إعادة تدريب يصل Llama-3.3-70B-Instruct إلى 76.6 و76.9 في MMLU عند إزالة 32 و40 من 80 كتلة، مقابل 59.3 و54.0 لطريقة block influence؛ وفي Qwen3-14B عند إزالة 12 من 40 تكون الأفضلية نحو 10 نقاط. وتنتقل الطريقة إلى النموذج الهجين NVIDIA-Nemotron-3-Nano-30B-A3B-FP8 متفوقة على block influence في AIME25 وGPQA، والكود مفتوح.
شارك التجربة الرقمية
SSiTech
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.