Qwen 3.8 27B: أداء ممتاز بحجم 17 غيغابايت لكنه يفرط في التفكير افتراضيًا
أصدر مختبر Qwen التابع لـ«علي بابا» نموذجًا بـ27 مليار معامل يدعم الرؤية تحت رخصة Apache 2.0. يعمل النموذج على أجهزة عادية، لكن إعداد التفكير الافتراضي يستهلك موارد زائدة.
في 14 أغسطس، نشر مختبر Qwen البحثي التابع لشركة «علي بابا» نموذج Qwen 3.8 27B، وهو نموذج لغوي بـ27 مليار معامل قادر على معالجة الصور، صدر تحت رخصة Apache 2.0. الأوزان متاحة على Hugging Face، ويمكن تشغيل النموذج محليًا عبر LM Studio أو llama.cpp.
النتائج والانطباعات الأولى
تُظهر النتائج التي تنشرها Qwen نفسها تفوقًا واضحًا للنموذج الجديد على سابقه Qwen 3.6 27B، بل وتجاوزه لنموذج Qwen 3.7-Plus المغلق الأوزان، الذي كان حتى مايو من أقوى نماذج Qwen بأي حجم. ولم تصدر تقييمات مستقلة بعد. وقد وصف المطوّر سايمون ويليسون، الذي اختبر النموذج على حاسوب MacBook Pro M5 Max بذاكرة 128 غيغابايت وعلى جهاز NVIDIA DGX Spark، حجم 27B بأنه حجم ممتاز لتشغيل نموذج قادر على أداء المهام على حاسوب محمول عادي.
الإفراط في التفكير افتراضيًا
يتضمن النموذج معامل reasoning_effort وقيمته الافتراضية xhigh، وتحافظ نسخة GGUF في LM Studio على هذا الإعداد. عمليًا، يعني ذلك أن أبسط الطلبات تستهلك آلاف الرموز في التفكير: فسياق LM Studio الافتراضي البالغ 8,192 رمزًا كان يُستهلك بسرعة، ولم تختفِ المشكلة إلا بعد تحميل السياق الكامل البالغ 262,144 رمزًا.
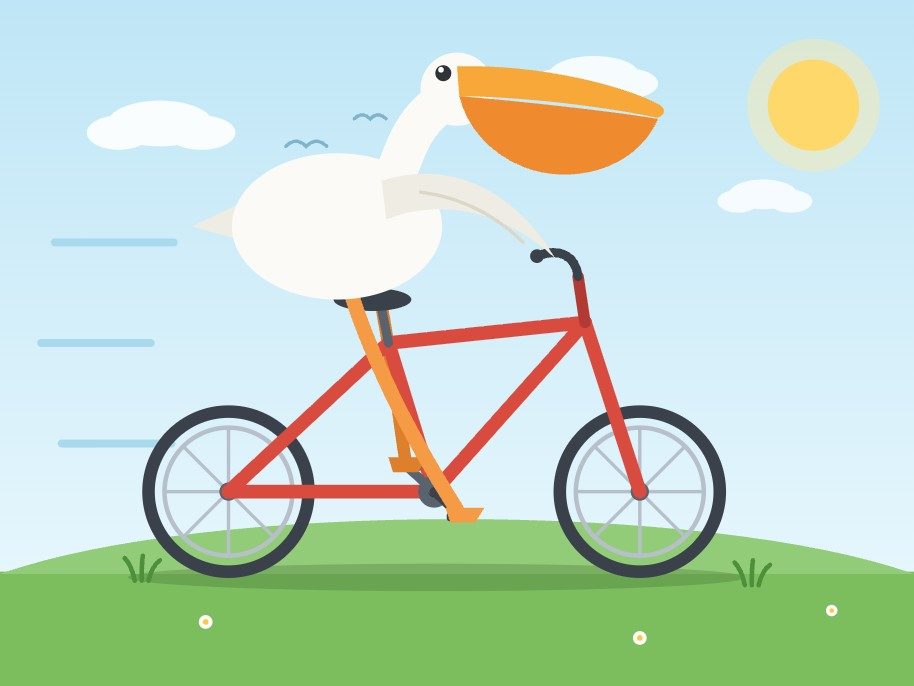
في أحد الاختبارات احتاج النموذج إلى 21 دقيقة و22,276 رمز تفكير لإنتاج 3,223 رمزًا من رسم SVG يمثل بجعًا يقود دراجة. وعند إيقاف التفكير، اكتمل الطلب نفسه في 137 ثانية وبـ3,715 رمزًا. أما الطلب البسيط «ارسم SVG لدائرة» فقد ردّ عليه بتكوين متحرك معقّد. وتتمثل نصيحة الكاتب العملية في تشغيل النموذج عند المستوى المنخفض أو مع إيقاف التفكير، على الأقل في البداية.
الرؤية والأدوات والسرعة
أثبت النموذج قوة في الإدراك البصري: فعند طلب إحداثيات JSON على مقياس 0–1000 للبجع في صورة فوتوغرافية، أعاد إحداثيات طابقت حدود الأجسام بدقة. وبطلب واحد بنى كذلك أداة HTML صغيرة ترسم هذه الصناديق فوق الصور وتعمل بالكامل دون اتصال؛ وكانت النتيجة مفرطة في التعقيد لكنها فعّالة.
أما العيب الأساسي فهو السرعة. فقد أنتج LM Studio نحو 15 إلى 30 رمزًا في الثانية، مقابل 74 و184 رمزًا في الثانية سجّلها Artificial Analysis لنموذجي OpenAI المستضافين 5.6 Sol و5.6 Luna. ويوجد تحسين مجتمعي بالفعل: يدعم Qwen خاصية Multi-Token Prediction، وقد تجاوز خادم llama.cpp المُشغَّل بوضع فك التشفير الاستباقي draft-mtp النسخة الافتراضية من LM Studio بنحو 72% في اختبار على DGX Spark.
الخلاصة الأوسع هي ما يوضحه ملف بحجم 17 غيغابايت اليوم: سياق طويل، واستدعاء أدوات، ورؤية، وتوليد كود بمستوى جيد، وكل ذلك على أجهزة يملكها المطوّر بالفعل. ويبقى السؤال مفتوحًا: هل تلحق سرعة الاستدلال بهذه القدرات؟
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.