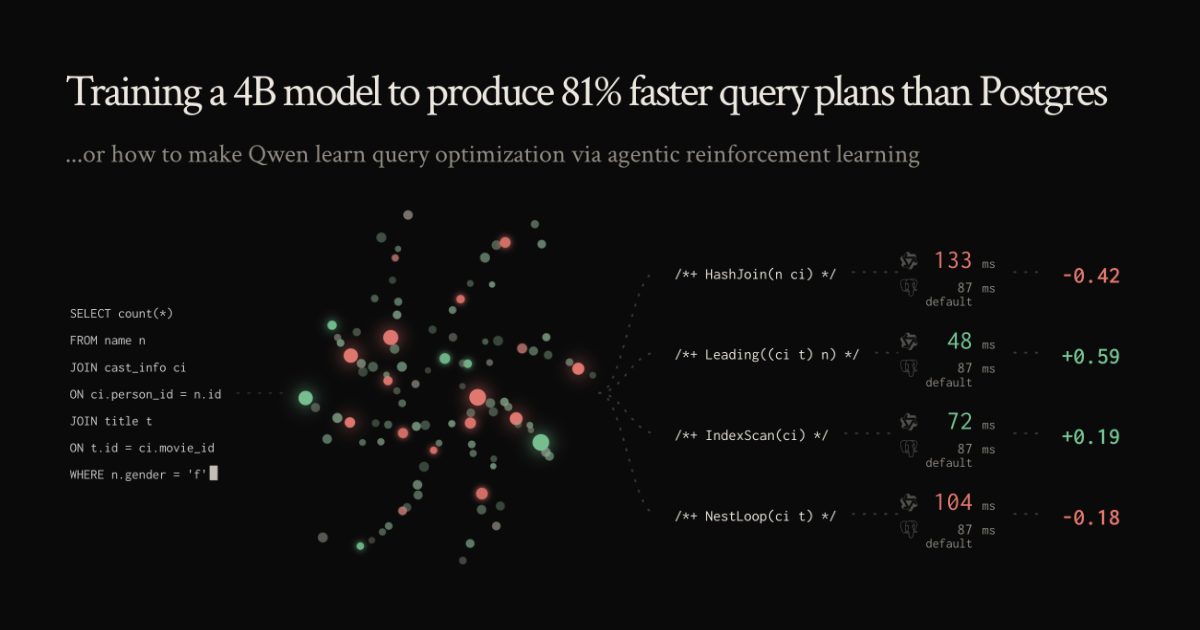
نموذج بحجم 4B مدرَّب بالتعلم المعزز ينتج خطط استعلام أسرع بنسبة 81% من Postgres
درَّب روهان بانسال نموذجًا مفتوح الأوزان بـ4 مليارات معامل على توجيه مُخطِّط PostgreSQL عبر تلميحات pg_hint_plan. وفي 113 استعلامًا كثيف الربط انخفض زمن الاستجابة الإجمالي 44.7%.
نموذج صغير في مواجهة مُخطِّط Postgres
نشر روهان بانسال تجربة تُظهر إمكان تدريب نموذج لغوي صغير مفتوح الأوزان بعد التدريب الأولي ليُنتج لقاعدة بيانات PostgreSQL خطط استعلام أفضل من تلك التي يولّدها المحرك نفسه. على معيار Join Order Benchmark (JOB) — وهو 113 استعلام SQL كثيف الربط على مجموعة بيانات IMDb — حقّق النموذج المدرَّب بحجم 4B، عند اختيار أفضل مرشّح، تسريعًا وسطيًا هندسيًا قدره 1.81x، بينما انخفض زمن الاستجابة الإجمالي لكامل عبء العمل بنسبة 44.7%. وسجّلت نقطة التفتيش نفسها 68 فوزًا مقابل صفر حالات تراجع.
كانت نقطة البداية غير مشجعة: النموذج غير المدرَّب لم يستطع إنتاج خطة صالحة لـ99 استعلامًا من أصل 113، ولم يُسفر إلا 14 محاولة عن مرشّح سليم. ويشرح الكاتب ذلك بأن مُحسِّنات الاستعلامات مهمة صعبة — فترتيب الربط مسألة NP-صعبة، والمُخطِّط يقدّر عدد الصفوف من الإحصاءات لا من العدّ الفعلي. لكن التحقق من جودة الخطة سهل، لأن المعيار الوحيد هو زمن التنفيذ. وهذه المفارقة هي ما يجعل المسألة مناسبة للتعلم المعزز.
تلميحات وبيئة عميل وتقطير
لا يستبدل النموذج المُخطِّط، بل يوجّهه. استخدم بانسال الإضافة الخارجية pg_hint_plan، التي تقبل تلميحات منظَّمة داخل تعليقات SQL، وبنى بيئة عميل بأدوات ست تُسمّى qo-agent: يفحص الوكيل الجداول وإحصاءات الأعمدة، ويقرأ الخطة الافتراضية، ويرسل إجراءات خطط مرشّحة، ثم إما يُبقي خطة Postgres أو ينتهي بخطة خاصة به. ويُترجم كل مرشّح إلى تلميحات، ويُنفَّذ، ويُقاس زمنه مقابل الخطة الافتراضية.
جرى التدريب على مرحلتين. أولًا ضبط دقيق بإشراف عبر تقطير off-policy من 500 مسار عميل لـGPT-6 Astra، حيث يُحدَّث مُهايئ LoRA بحجم 42.5 ميغابايت فقط، بـ21.2 مليون معامل قابل للتدريب، فوق نموذج Qwen مشتق بـ4.66 مليار معامل. حسّنت حقبتان النتائج وأفسدت الثالثة النتيجة، مع أن خسارة التحقق توقفت عن التغيّر — وهو ما يذكّر، بحسب الكاتب، بأن استواء المنحنى لا يثبت توقف التعلم.
مكافآت في بيئة صاخبة
كانت المرحلة الثانية تعلمًا معززًا وکيليًا بنسخة معدَّلة من GRPO. حُسب التسريع كوسيط ثلاث قياسات للخطة الافتراضية مقسومًا على وسيط ثلاث قياسات للمرشّح، وقد بُني منصة القياس بعناية خاصة: أربع حاويات PostgreSQL على جهاز واحد تخلق تنافسًا على ذاكرة التخزين المؤقت للصفحات في لينكس، ما يشوّه القياسات. وقُسّم التدريب بين موقعين — vLLM والمدرب على عقدة 2x H100 مستأجرة، وحاويات قاعدة البيانات على مكتب الكاتب. دفعت صيغة المكافأة الأولى النموذج إلى إعادة الخطة الافتراضية مرارًا؛ وكان الحل مقارنة جولات التشغيل ببعضها بدل منحها درجات مطلقة.
ما الذي تعلمه النموذج
يُظهر تحليل نقطة التفتيش النهائية بعد 1200 تحديث أن 295 من أصل 337 عملية بحث فحصت أولًا جدولًا أو إحصاءات عمود أو الخطة الافتراضية، وأن 235 من 339 استخدمت محاولات المرشّحين الخمس كلها. وكلّف المشروع نحو 1200 دولار: قرابة 95 ساعة من عقدة 2x H100 على Lambda و400 دولار رسوم واجهة OpenAI لتوليد مسارات العرض التوضيحي. ولا يخلص بانسال إلى أن النماذج الكبيرة صارت متقادمة — فالتقطير من Astra هو سبب عمل النموذج الصغير أصلًا — بل إلى أن النماذج الصغيرة تستحق اهتمامًا جديًا في المهام الضيقة التي يسهل التحقق منها.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.