NVIDIA bioloji əsas modellər üçün səmərəli MoE təlim yolunu göstərdi
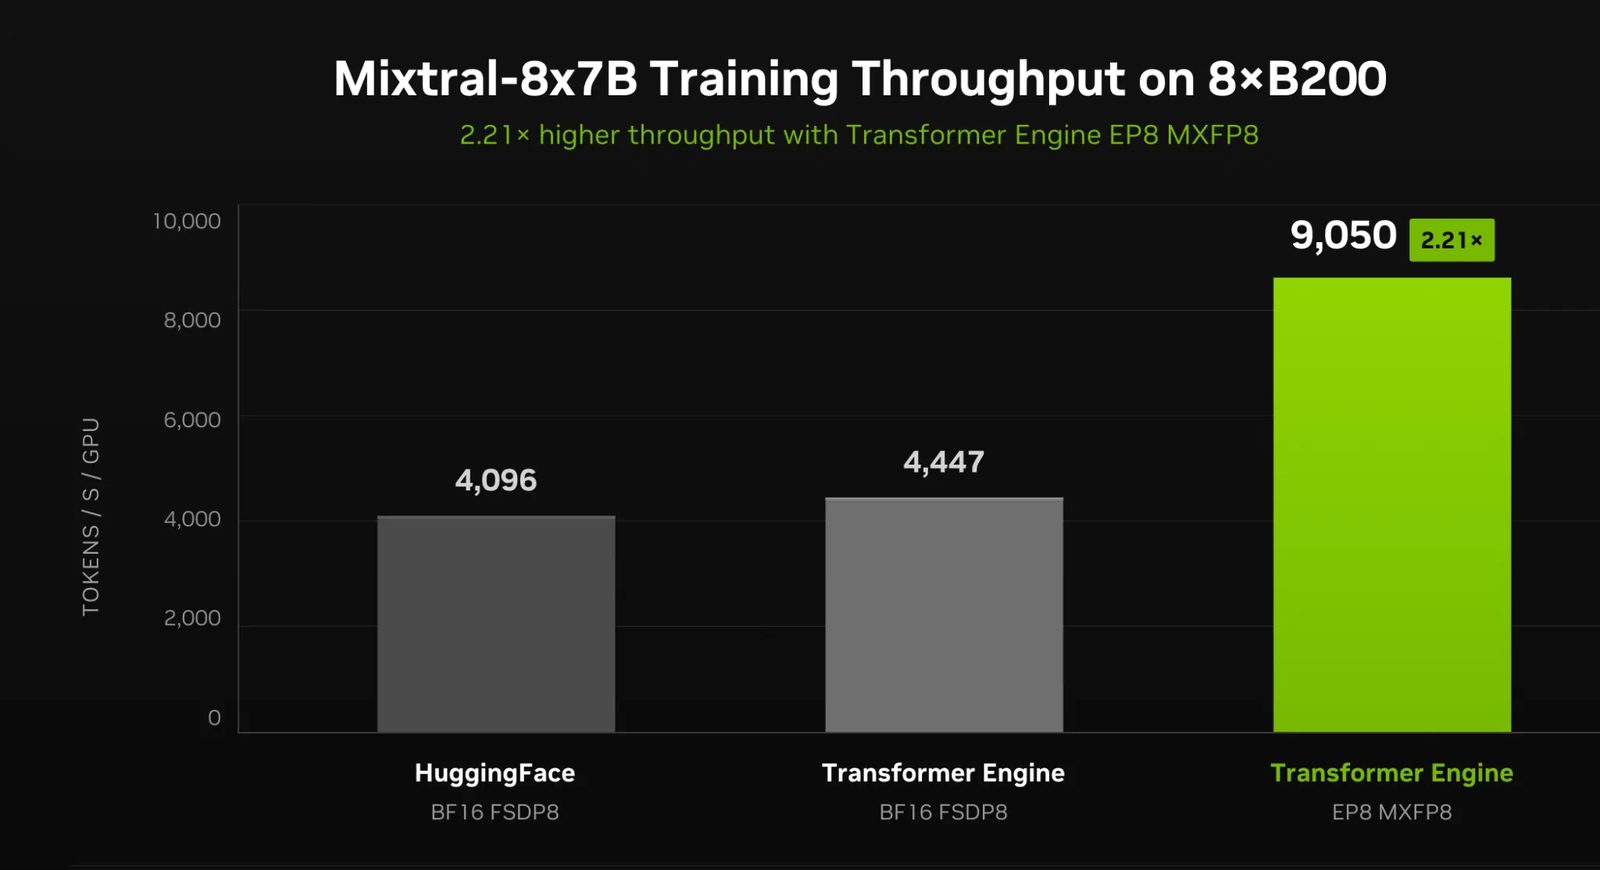
NVIDIA-nın developer bloqunda dərc olunan təlimatda Transformer Engine və BioNeMo reseptinin seyrək MoE modellərinin təlimini necə sürətləndirdiyi izah edilir: səkkiz B200 GPU-da baza versiyasından 2,21 dəfə yüksək məhsuldarlıq.
NVIDIA-nın developer bloqu bioloji əsas modellərin ekspertlər qarışığı (MoE) arxitekturası ilə daha səmərəli təliminə dair texniki təlimat dərc edib. Məqalənin müəllifləri Faradawn Yang, Peter St John, Kyle Tretina və Zoey Zhang-dır.
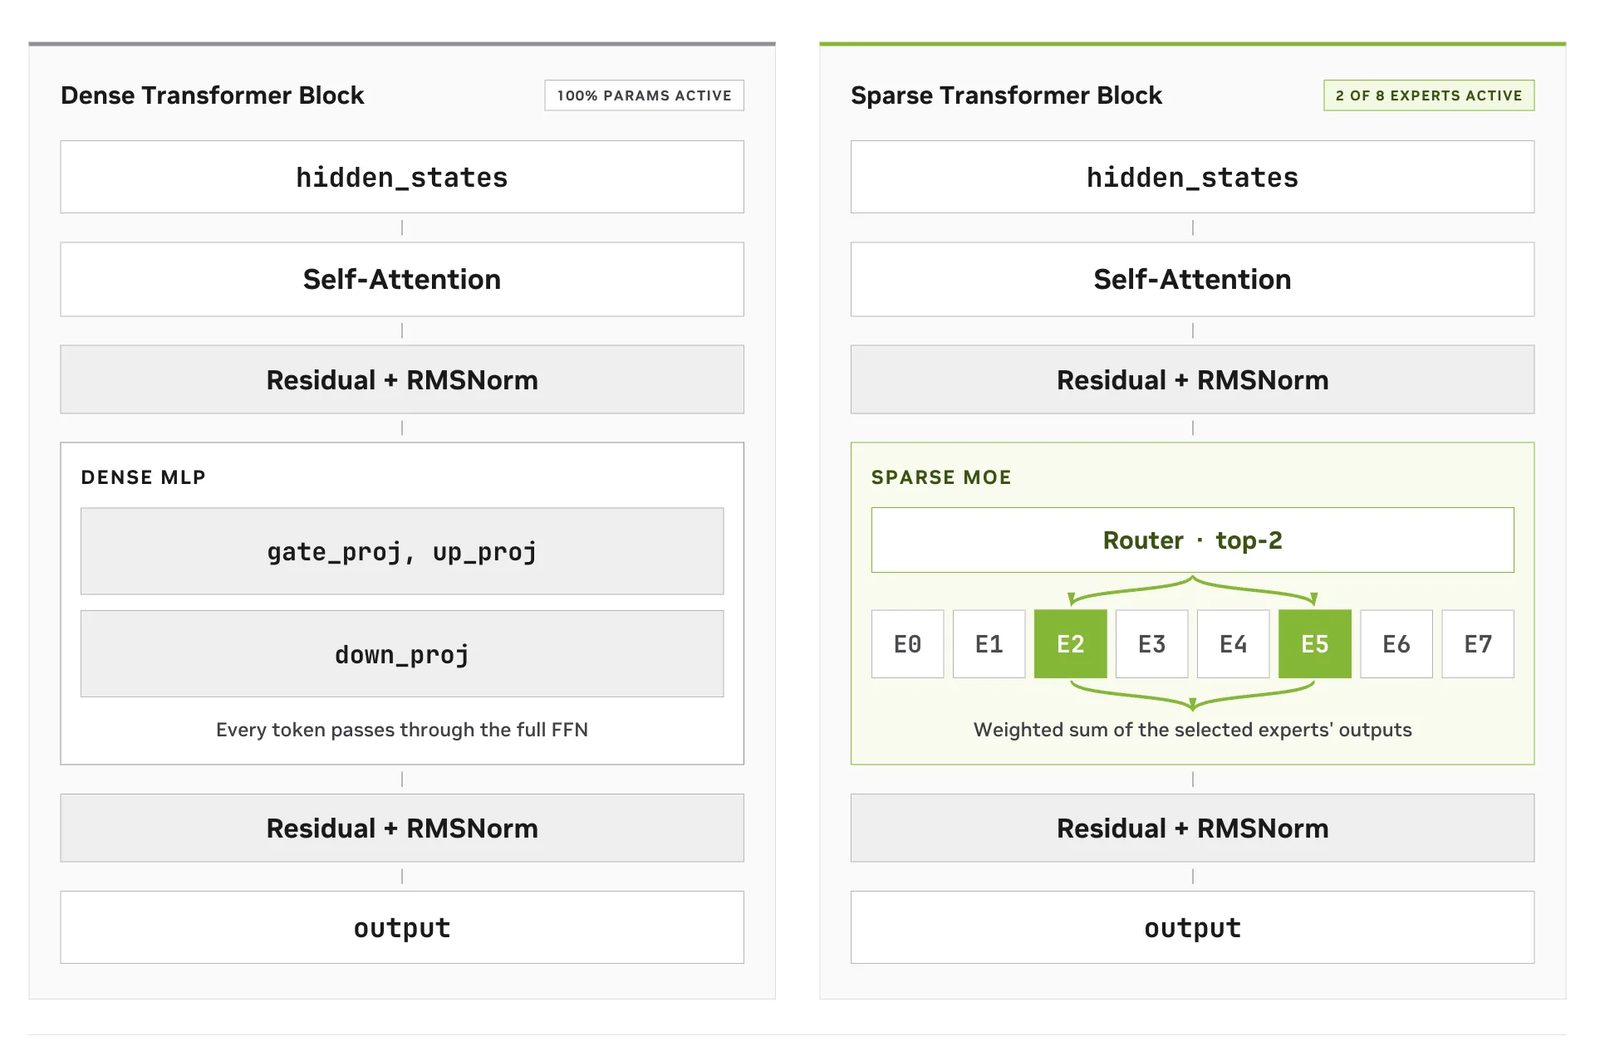
Sıx transformerlər hər tokeni bütün qatlardan keçirir, ona görə əlavə tutum həm təlimdə, həm inference-da baha başa gəlir. MoE arxitekturaları feed-forward blokunu çoxlu ekspertlərə bölür və hər token üçün onların yalnız bir neçəsini aktivləşdirir. Nəticə tətbiqdən asılıdır: parçalanmış hesablamalar GPU istifadəsini azaldır, marşrutlaşdırma rabitə yükü artırır, böyük parametr həcmi isə yaddaşa təzyiq göstərir.
Python dövrü əvəzinə qruplaşdırılmış ekspertlər
İlk problem nüvələrin parçalanmasıdır. Hugging Face-in baza tətbiqində ekspertlər Python dövründə bir-birinin ardınca işləyir və hər biri ayrı nüvə başladır. TE-nin GroupedLinear-ı ekspert çəkilərini və tokenləri toplayıb bütün xətti çevirmələri tək qruplaşdırılmış GEMM çağırışında yerinə yetirir; ekspert üzrə token sayını split_sizes arqumenti ilə qəbul edir. NVIDIA steki bu proyeksiyanı MXFP8 kvantizasiyası ilə birlikdə GroupedMLP nüvəsində birləşdirə bilir.
Yaddaş və kvantizasiya yükünün azaldılması
MoE modelləri daha çox parametr daşıyır, genomika iş yükləri isə çox vaxt uzun ardıcıllıqlardan istifadə edir və bu, aktivasiya yaddaşına təzyiq edir. BF16 hər dəyəri 16 bitdə saxlayır, FP8 və MXFP8 isə 8 bitdə. MXFP8 ədədi diapazonu qorumaq üçün hər 32 dəyərlik bloka miqyas əmsalı təyin edir; Blackwell GPU-larda bu GEMM-lər xüsusi Tensor Core təlimatları ilə işləyir.
Aşağı dəqiqlikli təlim əsas çəkiləri yenə 16 bitdə saxlayır, buna görə kvantizasiya və dekvantizasiya əlavə iş yaradır. GroupedLinear, ScaledSwiGLU və GroupedLinear əməliyyatlarını TE-nin Sequential API-si ilə zəncirləmək şablonu vahid birləşmiş əməliyyatla əvəz etməyə imkan verir: irəli keçid üçün ForwardGroupedMLP_CuTeGEMMSwiGLU_MXFP8.
Səkkiz B200 GPU-da 2,21 dəfə məhsuldarlıq
Mixtral-8x7B modeli ilə səkkiz NVIDIA B200 Tensor Core GPU üzərində aparılan testdə resept Hugging Face baza versiyası ilə müqayisədə 2,21 dəfəyə qədər yüksək məhsuldarlıq göstərdi. Birləşmiş MXFP8 GroupedMLP nüvələri Blackwell tələb edir, ekspert paralelliyi üçün isə ən azı iki GPU lazımdır.
Təlimatda işə salma əmrləri də var: mühiti yoxlamaq üçün iki GPU-luq L0_sanity, sonra səkkiz GPU-da ekspert paralelliyi (EP=8) və MXFP8 ilə L1_8x7B_ep.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.