NVIDIA-nın SWE-Serve-i yerli testlərlə canlı server arasındakı fərqi göstərir
NVIDIA SGLang komandasının töhfəsi ilə hazırlanan SWE-Serve meyarını təqdim edib: 83 birləşdirilmiş pull request 53 icra edilə bilən tapşırığa çevrilib. Bütün digər yoxlamalardan keçən yamaların təxminən üçdə biri canlı server testlərində uğursuz olur.
Kod agentinin yaması testlərdən keçə bilər, lakin server real modeli yükləyib sorğuları emal etməyə başlayanda uğursuz ola bilər. NVIDIA sentyabrın 23-də dərc etdiyi SWE-Serve meyarı ilə məhz bu fərqi ölçür. SGLang komandasının töhfəsi ilə hazırlanan meyar 83 birləşdirilmiş SGLang pull request-ni 53 icra edilə bilən tapşırığa çevirir.
SWE-Serve nəyi yoxlayır
Tapşırıqlar altı sahəyə bölünür: spekulyativ və təkmilləşdirilmiş dekodlama (14), model və backend dəstəyi (12), nüvələr, kvantlaşdırma və məhsuldarlıq (8), server API-ləri və işləmə vaxtı düzgünlüyü (8), keşləmə (7), paylanmış icra və planlama (4). On iki tapşırıq CPU-da, 41 tapşırıq isə bir NVIDIA H100-də işləyir; ilk buraxılış digər inference mühərriklərini, çoxlu GPU icrasını və çoxdüyünlü serveri əhatə etmir. On doqquz tapşırıq isə real server işə salır.
Canlı server testləri nəyi aşkarlayır
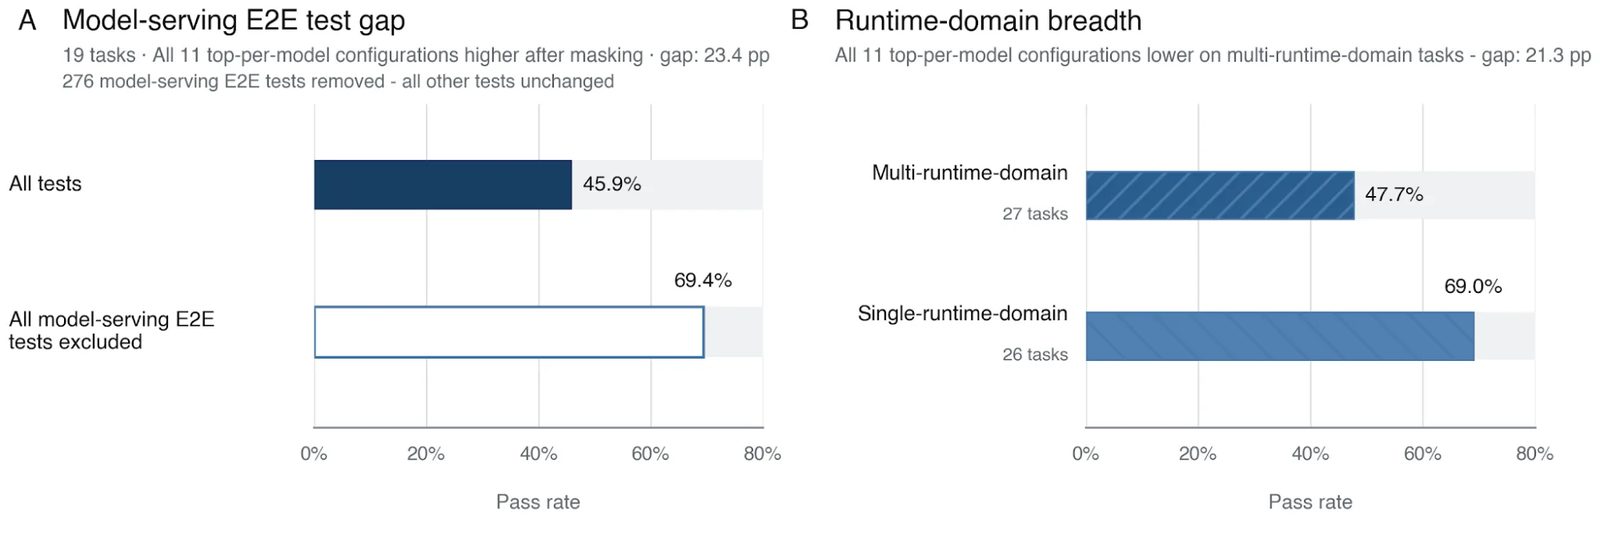
Canlı server işlədən 19 tapşırıqda eyni 627 yama tam yoxlayıcı ilə 45,9% halda keçir. Server testləri çıxarıldıqda göstərici 69,4%-ə yüksəlir: 147 yama uğursuzluqdan uğura keçir və digər bütün yoxlamalardan keçən yamaların təxminən üçdə biri server testində uğursuz olur. Bu tapşırıqlarda 276 server testi var; 242-si SGLang-dan götürülüb və ya uyğunlaşdırılıb. Gemma 4 MoE tapşırığı bunu aydın göstərir: 33 yamanın 16-sı digər bütün yoxlamalardan keçdiyi halda ən azı bir canlı server testində uğursuz oldu.
Müəlliflər uğurun mənasının dar olduğunu vurğulayır: bu yalnız yamanın meyar yoxlayıcısını ödədiyini göstərir, yerləşdirməyə hazır olduğunu deyil.
Agentlər harada aşağı bal toplayır
Sorğudan çıxışa gedən yol dörd işləmə vaxtı sahəsinə bölünür: sorğuların emalı və G/Ç, planlama və sorğunun həyat dövrü, modelin icrası, KV-cache və resurs idarəetməsi. Bir sahə ilə məhdudlaşan 26 tapşırıq 69,0% nəticə verir, bir neçə sahəni əhatə edən 27 tapşırıq isə 47,7%-də qalır; bu 21,3 bəndlik fərq hər model konfiqurasiyasında eyni istiqamətdə görünür.
On bir model və 31 konfiqurasiya yalnız Bash istifadə edən mini-swe-agent ilə qapalı şəraitdə yoxlanılıb. Orta pass@1 34,6%-dən 75,5%-ə qədər dəyişir. Cədvələ 75% ilə Claude Opus 5 və GPT-5.6 Sol başçılıq edir; lakin 64%-də dayanan dörd modelin xərci kəskin fərqlənir: tapşırıq başına 0,95 dollardan 7,24 dollara, orta vaxt isə 25,5-99,9 dəqiqə arasında dəyişir.
Komanda 786 mənbəni nəzərdən keçirib, 156 namizəd qurub və 53-nü qəbul edib; dəyişdirilməmiş kod yeni davranış testlərində uğursuz olmalı, eyni zamanda reqressiya testlərindən keçməli idi. Qiymətləndirmə zamanı açıq şəbəkə və upstream repozitoriyalar bloklanır.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.