NVIDIA cədvəl proqnozlaşdırması üçün açıq Kumo Tabular modelini buraxdı
NVIDIA Kumo Tabular-ı buraxdı: yeni sətirlərin etiketlərini təlim və xüsusiyyət hazırlığı olmadan bir irəli keçidlə proqnozlaşdıran açıq baza modeli dörd benchmarkda birinci yerdədir.
NVIDIA sentyabrın 29-da Kumo Tabular-ı buraxdı. Bu, cədvəl məlumatları üçün açıq baza modelidir və NVIDIA Kumo Structured kolleksiyasına daxildir. Çəkilər Hugging Face-də, kod isə şirkətin açıq kitabxanasındadır (structured-data-models). Model kommersiya istifadəsinə icazə verən OpenMDW-1.1 lisenziyası ilə yayılır.
Modelə etiketli sətirlərdən ibarət cədvəl verilir və o, yeni sətirlərin etiketlərini bir irəli keçidlə qaytarır: təlim, incə tənzimləmə və xüsusiyyət hazırlığı olmadan, həm təsnifat, həm də reqressiya üçün. Model 28 milyondan 215 milyon parametrə qədər üç ölçüdədir və yalnız süni cədvəllərdə öyrədilib.
Necə işləyir
Kumo Tabular cədvəl strukturuna söykənən transformer-dir: TabICL və TabPFN yanaşmasına bənzər şəkildə sütun, sətir və kontekst diqqətindən istifadə edir. Hər bir dəyər öz sütununun paylanmasında qiymətləndirilir, sətir daxilində xüsusiyyətlərin qarşılıqlı təsiri qeyd olunur, məlum etiketləri olan sətirlər isə yeni sətirlərə bağlanır. Kontekst sorğulara heç vaxt baxmır, buna görə də onun açarları bir dəfə hesablanır və sonrakı proqnozlar üçün dəfələrlə istifadə olunur. Rəqəmsal və kateqoriyalı məlumatlar Fourier xüsusiyyətlərindən keçir, çatışmayan dəyərlər isə doldurulma tələb etmir. Diqqət temperaturu açarların sayının loqarifmi ilə birlikdə artır ki, daha böyük cədvəllərdə kəskin qalsın.
Süni məlumatlarda təlim
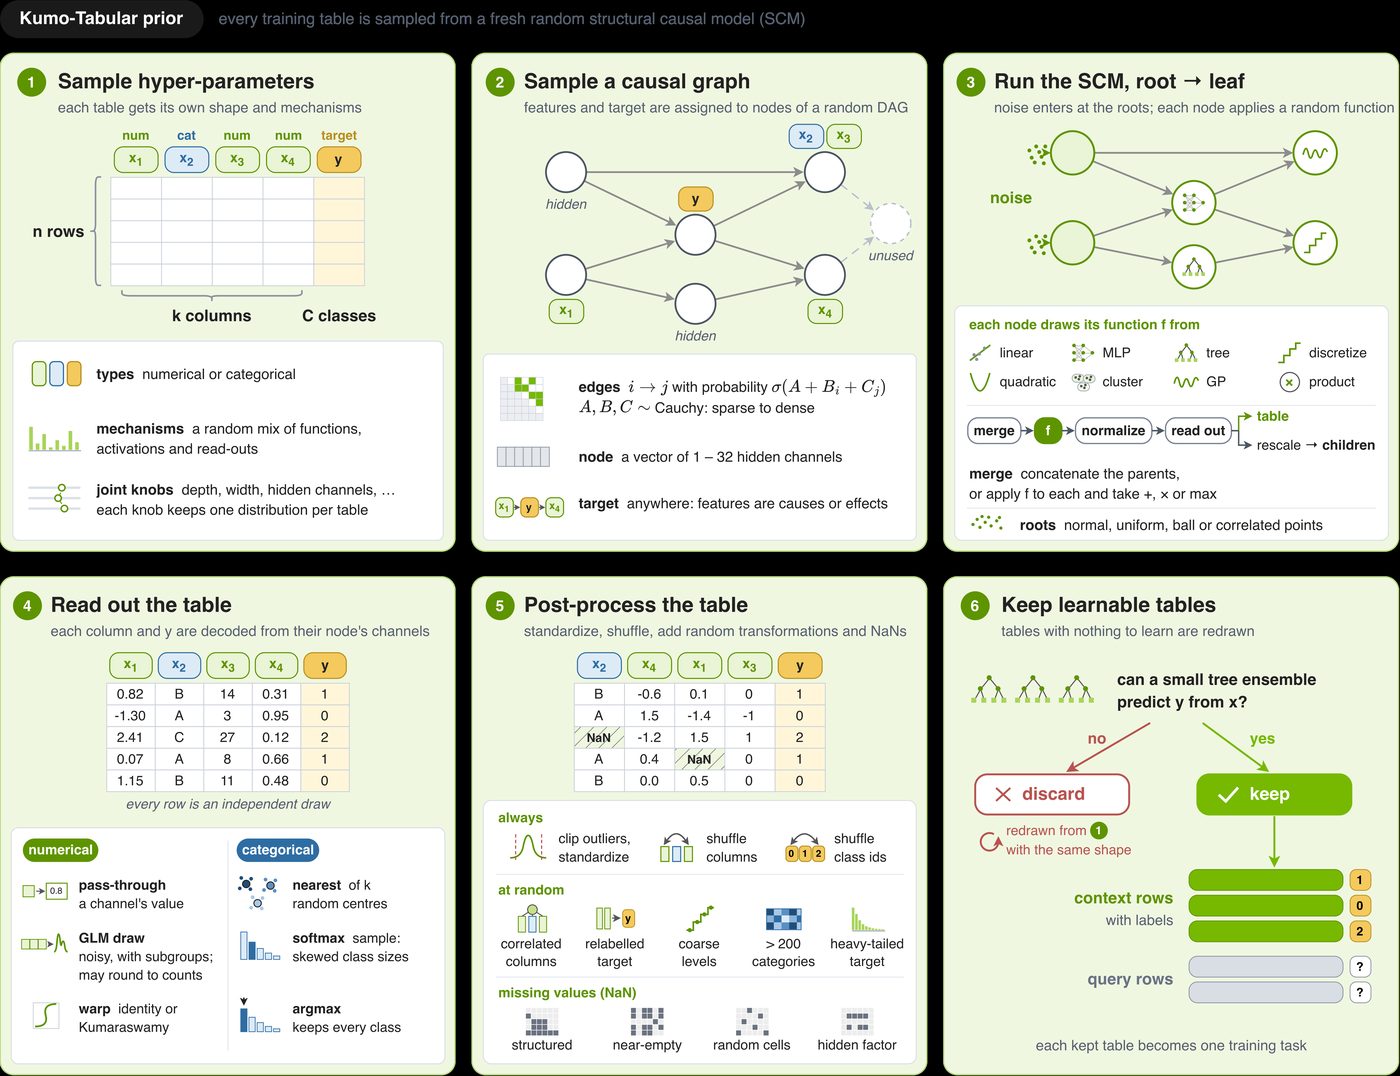
Hər təlim cədvəli Struktur Səbəbiyyət Modelindən (Structural Causal Model) yaradılır və sonra emal olunur: sütun qrupları bir-biri ilə kəsişir, kənar dəyərlər kəsilir, cədvələ çatışmayan məlumatlar süni şəkildə əlavə edilir, tree-ensemble yoxlaması isə qanunauyğunluqdan məhrum qalan cədvəlləri kənar edir. Təlim üç mərhələdə aparıldı: 1 024 sətirli və 100 sütuna qədər cədvəllərdən 400–10 240 sətirli kontekstə, sonda isə 60 000 sətirə qədər. Small, Medium və Large versiyaları təxminən 35, 71 və 137 milyon süni cədvəl gördü. Təsnifat və reqressiya ayrı-ayrı modellər kimi öyrədilir.
Nəticələr
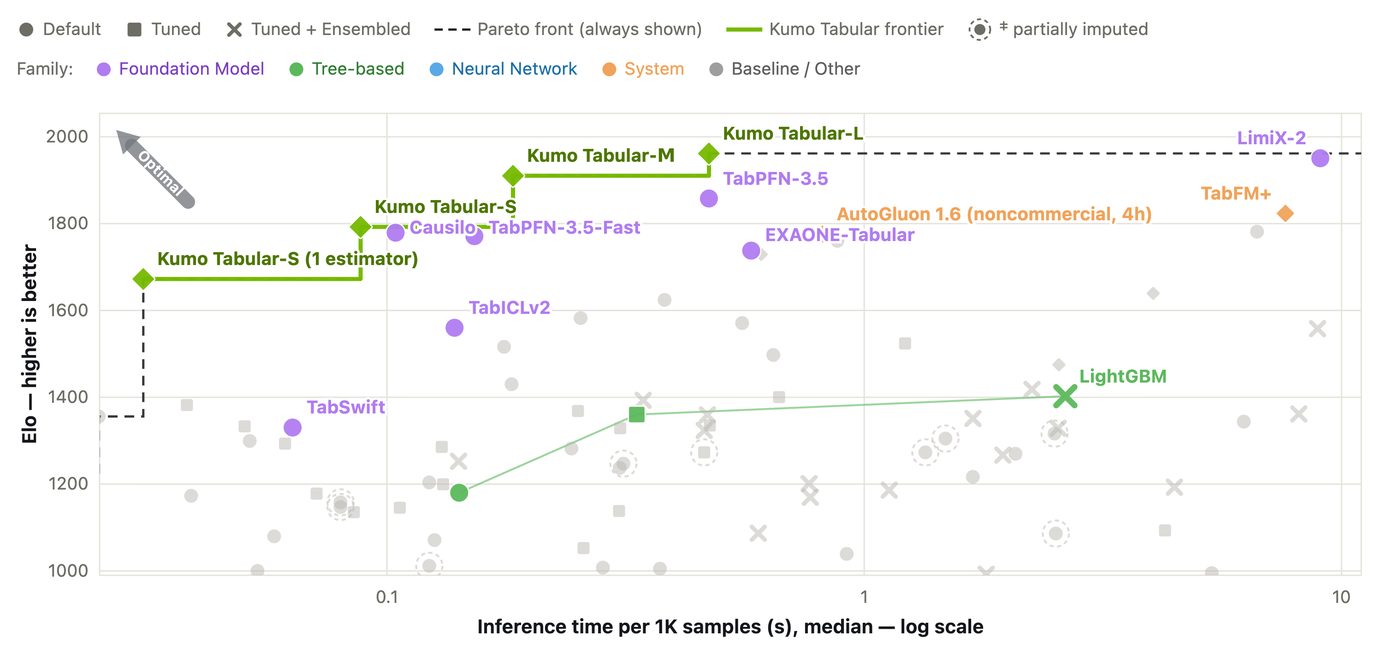
TabArena-da Kumo Tabular 1950 ELO ilə birinci yerdədir və NVIDIA-nın açıqlamasına görə, bir RTX 6000 Pro şəraitində LimiX-2-dən 17 dəfə daha sürətli işləyir. BeyondArena-da model 1418 ELO və 7,78% Improvability qiyməti aldı və yenə birincidir. TALENT-də o, ümumi reytinqdə təsnifat dəqiqliyi, log-loss və reqressiya RMSE-si ilə birincidir; orta reytinqlər 6,67; 3,98 və 4,22-dir. ScoringBench-də Kumo Tabular-Large və Medium orta reytinqlə birinci və ikinci yerlərdədirlər.
Məhdudiyyətlər
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.