Qwen3.6 27B: yerli inkişaf üçün praktik optimal nöqtə
Quesma bloqunda dərc olunan yazı iddia edir ki, sıx 27B modeli noutbukda yaxşı işləyir, real tapşırıqlarda daha sürətli MoE variantını üstələyir və 2025-ci ilin ortası səviyyəli benchmark göstəricilərinə çatır.
Yerli dil modelləri gündəlik iş üçün uzun müddət ciddi seçim sayılmırdı, lakin Quesma bloqunda dərc olunan yazı Qwen3.6 27B-ni daim istifadə etməyə dəyər ilk model adlandırır. Model iki formada təqdim olunur: daha sürətli ekspert qarışığı Qwen3.6 35B A3B və müəllifin daha yavaş, amma daha güclü hesab etdiyi və tövsiyə etdiyi sıx Qwen3.6 27B.
Müəllif nələri sınadı
Adi yaradıcı yazı testlərindən əlavə, modeldən OpenCode vasitəsilə pnpm ilə altıbucaqlı mina oyunu qurması istənildi. Model tək sorğudan, ilk cəhddə düzgün Node paketi ilə işləyən layihə yaratdı. Daha sürətli 35B A3B paket yaratma təlimatını görməzdən gəldi və hər şeyi bir index.html faylına yerləşdirdi. Şam mağazası üçün açılış səhifəsi sorğusu bir neçə dəqiqə işlədi və münasib standart parametrlərlə uyğunlaşan səhifə qaytardı. Müəllifin qiymətləndirməsi: qabaqcıl modellərin ölçülərinə görə adi, lakin artıq praktik nəticə.
Yerli işə salma
Quraşdırma Ollama yerinə llama.cpp-yə əsaslanır və Hugging Face-dən 8 bitlik kvantlaşdırma götürür: unsloth-un çoxsaylı token proqnozunu (MTP) dəstəkləyən Qwen3.6-27B-MTP-GGUF Q8_0 versiyası. Tək bir llama-server əmri modeli MTP qaralaması ilə, bütün qatlar GPU-da, flash attention açıq, 64k kontekst və sabitlənmiş portla işə salır; modelin təbii konteksti 256k-dır. 8 bitlik kvantlaşdırma BF16 versiyasının həcmini demək olar keyfiyyət itkisi olmadan yarıya endirir; 4 bitlik versiya isə 18 GB-dan az yer tutur və 32 GB-lıq cihaza sığır.
Məhsuldarlıq və mövqe
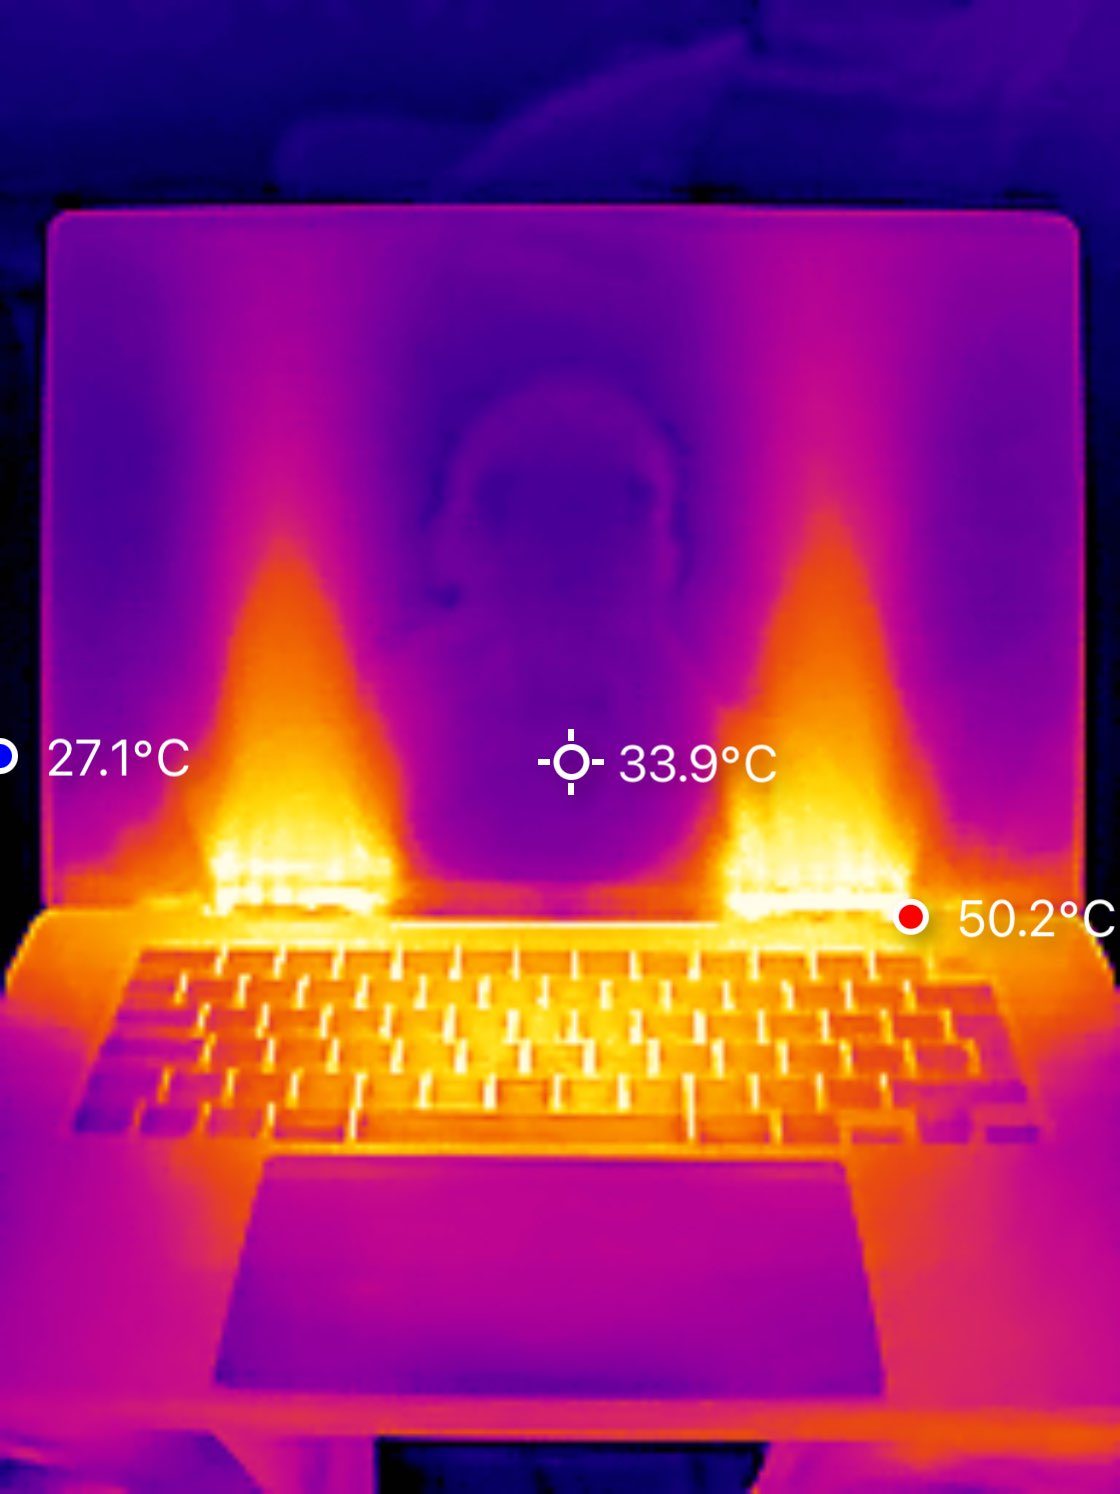
128 GB vahid yaddaşa malik MacBook M5 Max-də model saniyədə təqribən 30 token istehsal edir — qabaqcıl API-lərin adi aralığında — və GPU-nun təxminən 95 faizini istifadə edir. llama.cpp Apple çipləri üçün hazırlanmış mlx-lm-dən daha sürətli çıxdı və hər iki Qwen3.6 versiyası 48 GB yaddaş çərçivəsində qalır. İstehlakçı səviyyəli Nvidia RTX 5090-da Hacker News istifadəçilərindən biri Q6_K kvantlaşdırma və Q4_0 KV keşi ilə 123k kontekstdə saniyədə təxminən 50 token bildirdi. Artificial Analysis zəka indeksində 27B 37 bal toplayır; yazı bunu 2025-ci ilin ortası qabaqcıl model səviyyəsinə uyğunlaşdırır — 32 ballı 35B A3B və 29 ballı Gemma 4 31B-dən irəlidə. Müəllif yenə də 27B-ni üstün tutur: üçdə biri qədər kod, amma daha yüksək keyfiyyətdə. Onun geniş arqumenti belədir: yerli modelləri incə tənzimləmək mümkündür, onları geri almaq olmaz və onlar həssas məlumatlar üçün yararlıdır.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.