Qwen 3.8 27B: 17 GB-da əla nəticə, amma standart olaraq həddindən artıq düşünür
Alibaba-nın Qwen laboratoriyası Apache 2.0 lisenziyası ilə görmə qabiliyyətli, 27 milyard parametrli model buraxdı. Model adi avadanlıqda işləyir, lakin standart reasoning ayarı lazımsız resurs sərf edir.
Avqustun 14-də Alibaba-nın Qwen tədqiqat laboratoriyası Apache 2.0 lisenziyası ilə buraxılmış, 27 milyard parametrli və görüntü tanıma qabiliyyətinə malik Qwen 3.8 27B modelini təqdim etdi. Çəkilər Hugging Face-də mövcuddur, modeli isə LM Studio və ya llama.cpp ilə yerli olaraq işə salmaq mümkündür.
Göstəricilər və ilk təəssüratlar
Qwen-in özünün yayımladığı nəticələr yeni modeli həm sələfi Qwen 3.6 27B-dən, həm də may ayına qədər Qwen-in ölçüdən asılı olmayaraq ən güclü modellərindən biri sayılan qapalı Qwen 3.7-Plus-dan aydın şəkildə önə çıxarır. Müstəqil qiymətləndirmələr hələ dərc olunmayıb. Modeli 128 GB yaddaşlı M5 Max MacBook Pro-da və NVIDIA DGX Spark üzərində sınaqdan keçirən tərtibatçı Saymon Uillison 27B ölçüsünü güclü modeli adi noutbukda işə salmaq üçün ideal ölçü adlandırıb.
Standart olaraq həddindən artıq düşünmə
Modeldə standart dəyəri "xhigh" olan reasoning_effort parametri var və LM Studio-dakı GGUF versiyası bu ayarı saxlayır. Təcrübədə bu o deməkdir ki, ən sadə sorğular belə minlərlə düşünmə tokeni sərf edir: LM Studio-nun standart 8.192 tokenlik kontekst pəncərəsi tez dolur və problem yalnız 262.144 tokenlik tam kontekst yükləndikdən sonra aradan qalxır.
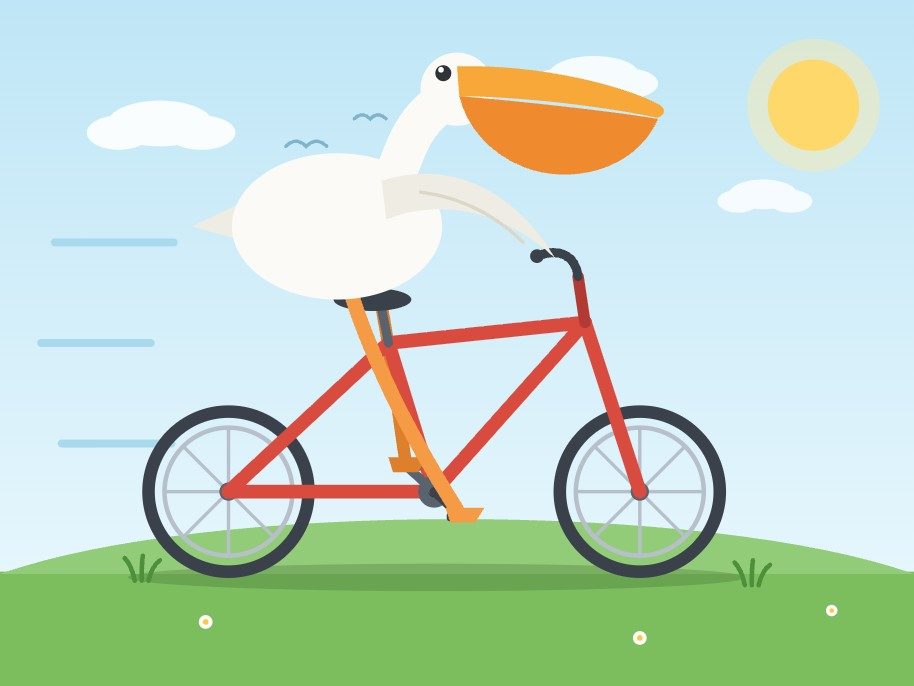
Bir sınaqda modelə 3.223 tokenlik SVG çıxışı — velosiped sürən pelikan — yaratmaq üçün 21 dəqiqə və 22.276 düşünmə tokeni lazım gəldi. Düşünmə söndürüldükdə həmin sorğu 137 saniyəyə və 3.715 tokenə tamamlandı. Yalnız "bir dairənin SVG-sini çək" sorğusuna isə model mürəkkəb, animasiyalı kompozisiya ilə cavab verdi. Müəllifin praktiki tövsiyəsi modeli başlanğıcda aşağı səviyyədə və ya düşünmə tam söndürülmüş halda işə salmaqdır.
Görmə, alətlər və sürət
Model vizual qavrayışda güclü çıxdı: fotoşəkildəki pelikanlar üçün 0–1000 şkalasında JSON sərhəd qutuları tələb edildikdə obyektlərə dəqiq uyğun gələn koordinatlar qaytardı. Tək bir təlimatla o, həmçinin şəkil üzərinə belə qutular çəkən və tamamilə oflayn işləyən kiçik HTML aləti qurdu; nəticə həddindən artıq mürəkkəb, lakin funksional idi.
Əsas çatışmazlıq sürətdir. LM Studio saniyədə təxminən 15–30 token verdi; Artificial Analysis-in ölçmələrinə görə isə OpenAI-ın hostinqdəki 5.6 Sol və 5.6 Luna modelləri saniyədə 74 və 184 tokenə çatır. İcma səviyyəsində optimallaşdırma artıq var: Qwen Multi-Token Prediction dəstəkləyir və draft-mtp spekulyativ dekodlaşdırma rejimi ilə işə salınan llama.cpp serveri DGX Spark üzərindəki sınaqda LM Studio-nun standart versiyasını təxminən 72% üstələdi.
Əsas nəticə 17 GB-lıq faylın artıq nəyi nümayiş etdirməsidir: uzun kontekst, alət çağırışı, görmə və keyfiyyətli kod generasiyası — hamısı tərtibatçının artıq sahib olduğu avadanlıqda. Açıq qalan sual budur: inference sürəti bu imkanlara çata biləcəkmi.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.