Qwen3.8-Flash-Next: Alibaba-nın Qwen komandası Qwen4 arxitekturasını təqdim edib
Qwen komandası 125 milyard parametrli, yalnız 6 milyardı aktiv olan açıq çəkili Qwen3.8-Flash-Next-i yayımlayıb; model hibrid seyrək diqqət və 262 min token kontekst təklif edir.
Alibaba-nın Qwen komandası avqustun 26-da Qwen3.8-Flash-Next-i yayımladı: şirkətin Qwen4-ün arxitekturasının əsasını təşkil edəcəyini bildirdiyi, açıq çəkilərlə deneysel model. Çəkilər Hugging Face-də qwen-community-1.0 lisenziyası ilə yerləşdirilib və Transformers, vLLM, SGLang və TokenSpeed ilə uyğundur.
Hibrid diqqət və QSA
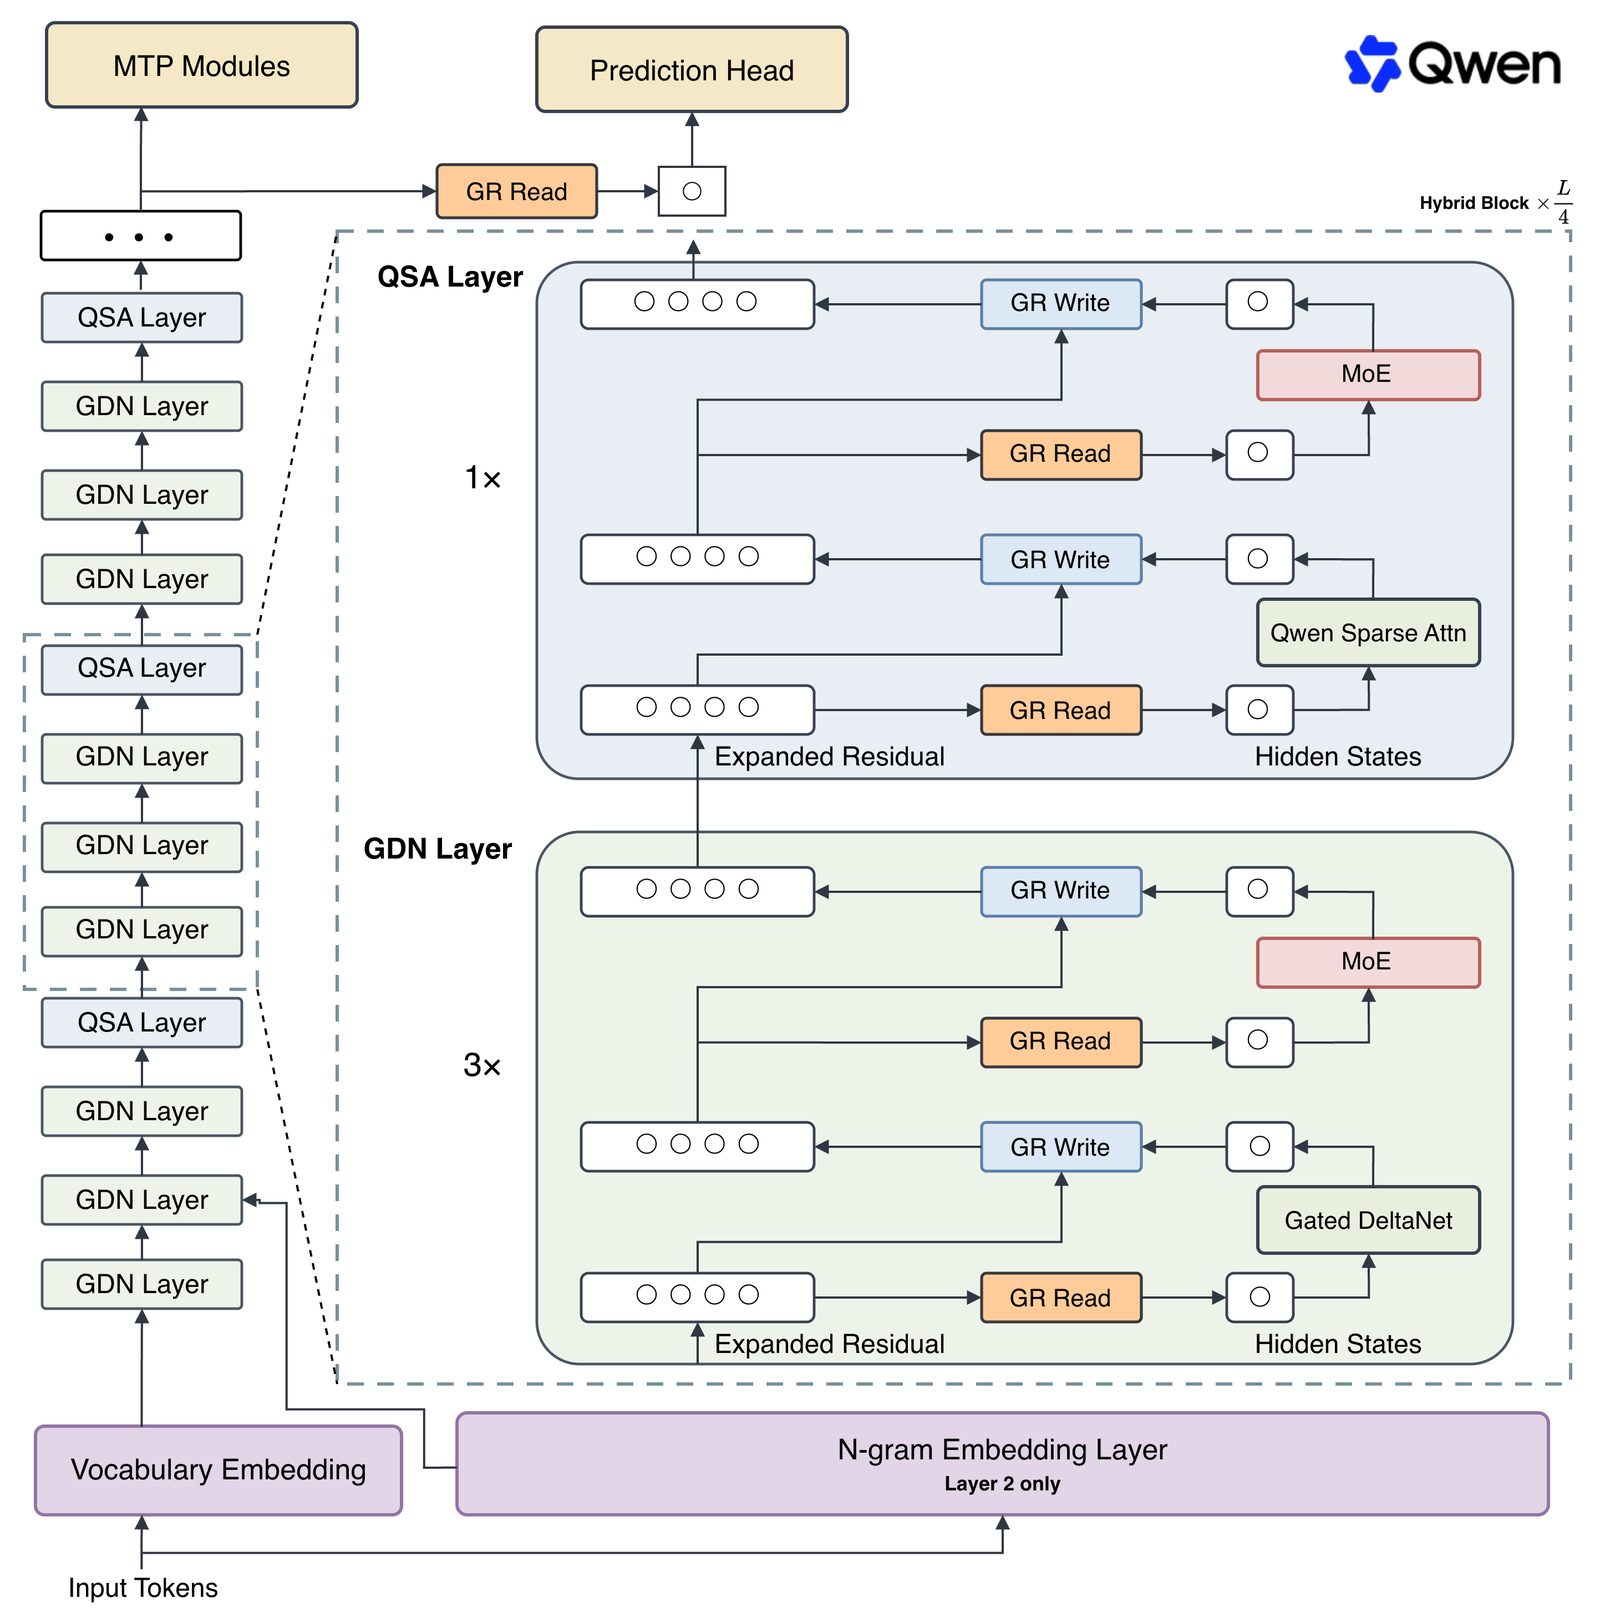
Əsas dəyişiklik arxitekturadadır: Gated DeltaNet və Gated Attention cütlüyü Gated DeltaNet ilə Qwen Sparse Attention (QSA) formasında yenidən qurulub. QSA ayrı-ayrı tokenləri seçmək əvəzinə müvafiq konteksti mikro-blok səviyyəsində seçir; bu, uzun kontekstlərdə gecikməni nəzərəçarpacaq dərəcədə azaldır. Komanda bunu real istifadədə agent yüklərinin getdikcə üstünlük təşkil etməsi baxımından kritik hesab edir.
Gated Residual və n-gram yerləşdirmə
Gated Residual genişləndirilmiş residual axınlarındakı məlumatı veriləndən asılı elementar oxuma qapısı və hər budaq üçün skalyar yazma qapısı ilə tənzimləyir; təlimin sabitliyini qoruyub ifadə gücünü artırır. N-gram yerləşdirmə isə parametr miqyaslanması üçün ayrı oxdur: mixture-of-experts-dən daha az hesablama tələb edir və yaddaşı məhdud akseleratorlarda xarici yaddaşa köçürülməyə daha uyğundur.
Miqyas və test nəticələri
Modeldə 125 milyard parametr var; onların yalnız 6 milyardı eyni vaxtda aktivdir, əlavə olaraq 51 milyard n-gram yerləşdirmə və 4 milyard MTP parametri mövcuddur. Model 48 laydan və 512 ekspertindən (10 istiqamətləndirilmiş və bir ortaq) ibarətdir. Kontekst pəncərəsi təbii olaraq 262 144 tokendir və bir milyona qədər genişləndirilə bilər. Yayımlanmış nəticələrdə Qwen3.8-Flash-Next SWE-bench Pro-da 62,5; DeepSWE 1.1-də 58,7; SWE-bench Multilingual-də 81,0; NL2Repo-Bench-də 48,1 və CoWorkBench-də 73,9 bal toplayır.
Bu nə deməkdir
Təlim tərəfində Qwen bildirir ki, Muon və AdamW optimizatorları konkret çəki kateqoriyalarına tətbiq olunur, batch ölçüsünün ənənəvi qızdırılması ləğv edilir və təlim birbaşa hədəf ölçüsü ilə başlayır. İstehsalat versiyası Qwen3.8-Flash buludda standart olaraq bir milyon token konteksti və daxili alətlərlə işləyir, açıq çəkilər isə öz serverində qurmaq üçün qalır. Texniki hesabat Qwen-in GitHub deposunda dərc olunub.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.